提示缓存被宣传为一种免费获得的折扣。它并非自动开启,也并非在每个提供商那里都免费。节省的费用取决于你的流量的三个方面:每个请求中有多少内容重复,有多少请求共享该重复部分,以及它们之间经过多少时间。如果这三方面都做对了,在长时间的智能体会话中,缓存可以将输入令牌成本降低80%到90%。如果做错了,至少在某个主流提供商那里,缓存的成本可能比完全不缓存还要高。
这篇文章提供的是公式,而不仅仅是主张。它展示了根据每个提供商自己发布的价格推导出的精确盈亏平衡计算,然后提供了一个DIY测试工具,你可以针对DigitalOcean的无服务器推理运行它,以衡量自己的工作负载,而不是相信供应商宣传的百分比。它还包含了我直接在配有单个NVIDIA H200的DigitalOcean GPU Droplet上使用vLLM 0.24.0服务的Llama 3.3 70B(FP8)运行的实测结果,下方实测结果部分中的每个命中率和延迟数字都来自该测试。
太长不看
- 提示缓存取决于工作负载,而非提供商。 同一提供商的缓存,根据你的流量形态,可能带来明显的收益,也可能造成净亏损。
- 三个变量决定结果: 前缀稳定性、会话深度和到达间隔时间。本文精确定义了每一项,并展示了如何测量。
- Anthropic 收取写入溢价;DigitalOcean 上的大多数 OpenAI 模型则不收取,尽管 OpenAI 自己的文档称最新的模型(GPT-5.6)现在会收取。 这一差异改变了计算结果,本文推导了每种情况下的精确盈亏平衡点。下面关于 Anthropic 和大多数 OpenAI 模型的费率已在 DigitalOcean 自己的定价页面上确认;GPT-5.6 的缓存写入费率已在 OpenAI 的定价页面上确认,但尚未在 DigitalOcean 上独立验证,因为该模型是在定价页面最后一次验证之后才在 DigitalOcean 上推出的。
- 结构性门槛比任何百分比都重要: 对于OpenAI 模型,DigitalOcean 不会缓存低于 1,024 个令牌的提示词。DigitalOcean 上的开源模型没有此类下限,自托管引擎也没有,本文直接测量了这一差异。
cache_control或prompt_cache_retention),按账户隔离,并可用于DeepSeek V3.2等模型。将提示缓存与无服务器推理的聊天补全和响应API结合使用,以缓存上下文并在未来的请求中使用它。如果您的部分请求已被缓存,您将为这些缓存的令牌支付较低的价格,并为剩余的输入令牌支付标准价格。这显著降低了推理成本。开源模型会自动缓存上下文。有关支持提示缓存的模型列表,请参阅基础模型。更多详情,请使用无服务器推理中的提示缓存文档。
提示缓存关键术语表
如果你对提示缓存不熟悉,这里有一些本文中使用的术语的简单定义:
| 术语 | 定义 |
|---|---|
| 提示 | 你发送给AI模型以获得响应的消息或输入(文本、指令)。 |
| 令牌 | 你的提示或输出的一小部分——通常是一个单词或单词的一部分——AI模型用于处理文本。 |
| 预填充 | AI模型在开始回答之前,将输入令牌转换为自己的内部格式的步骤。 |
| 缓存 | 一个存储区域,其中保留了重复的工作或结果,以便下次访问更快、更便宜。 |
| 缓存命中 | 当你当前的请求与缓存中已有的内容匹配时,系统可以使用缓存的结果,而不是重新做这项工作。 |
| 缓存未命中 | 当你的请求与缓存中的任何内容都不匹配时,系统必须从头开始重新完成所有工作。 |
| 缓存写入 | 将新信息(如处理后的提示)首次存储到缓存中。 |
| 缓存读取 | 使用缓存中存储的信息——无需再次处理提示。 |
| 前缀 | 提示的开头或重复部分,很可能在未来的请求中被重用。 |
| TTL(生存时间) | 缓存项目在自动过期并被移除之前保留的时间。 |
| 延迟 | 你在发送请求后AI模型开始响应所需的时间。 |
| 会话 | 一组相关的请求,通常就像与AI模型的对话,其中过去的消息可能作为上下文重复出现。 |
提示缓存的实际工作原理及其成本
当你向模型发送请求时,平台必须先将每个输入令牌转换为内部表示,然后才能生成响应。此步骤称为预填充。对于长系统提示、一组工具定义或大型检索文档,这是请求中成本和延迟最高的部分,因为平台每次都会从头重新处理相同的内容,即使它在一秒钟前刚看到完全相同的文本。
提示缓存存储已处理的表示,即注意力层使用的键值状态,这样后续具有相同前缀的请求可以跳过重新处理,直接读取存储的状态。这仅适用于输入令牌。输出令牌始终是重新生成的,因为响应取决于你这次问的内容,而不是你上次问的内容。
该机制依赖于精确匹配。提供商基于提示前缀的哈希进行缓存。如果在缓存边界之前的任何地方有一个字符发生变化,包括时间戳、请求ID或重新排序的工具列表,整个前缀将无法匹配,请求将回退到全价处理。这就是为什么提示结构与提示内容同样重要的原因。
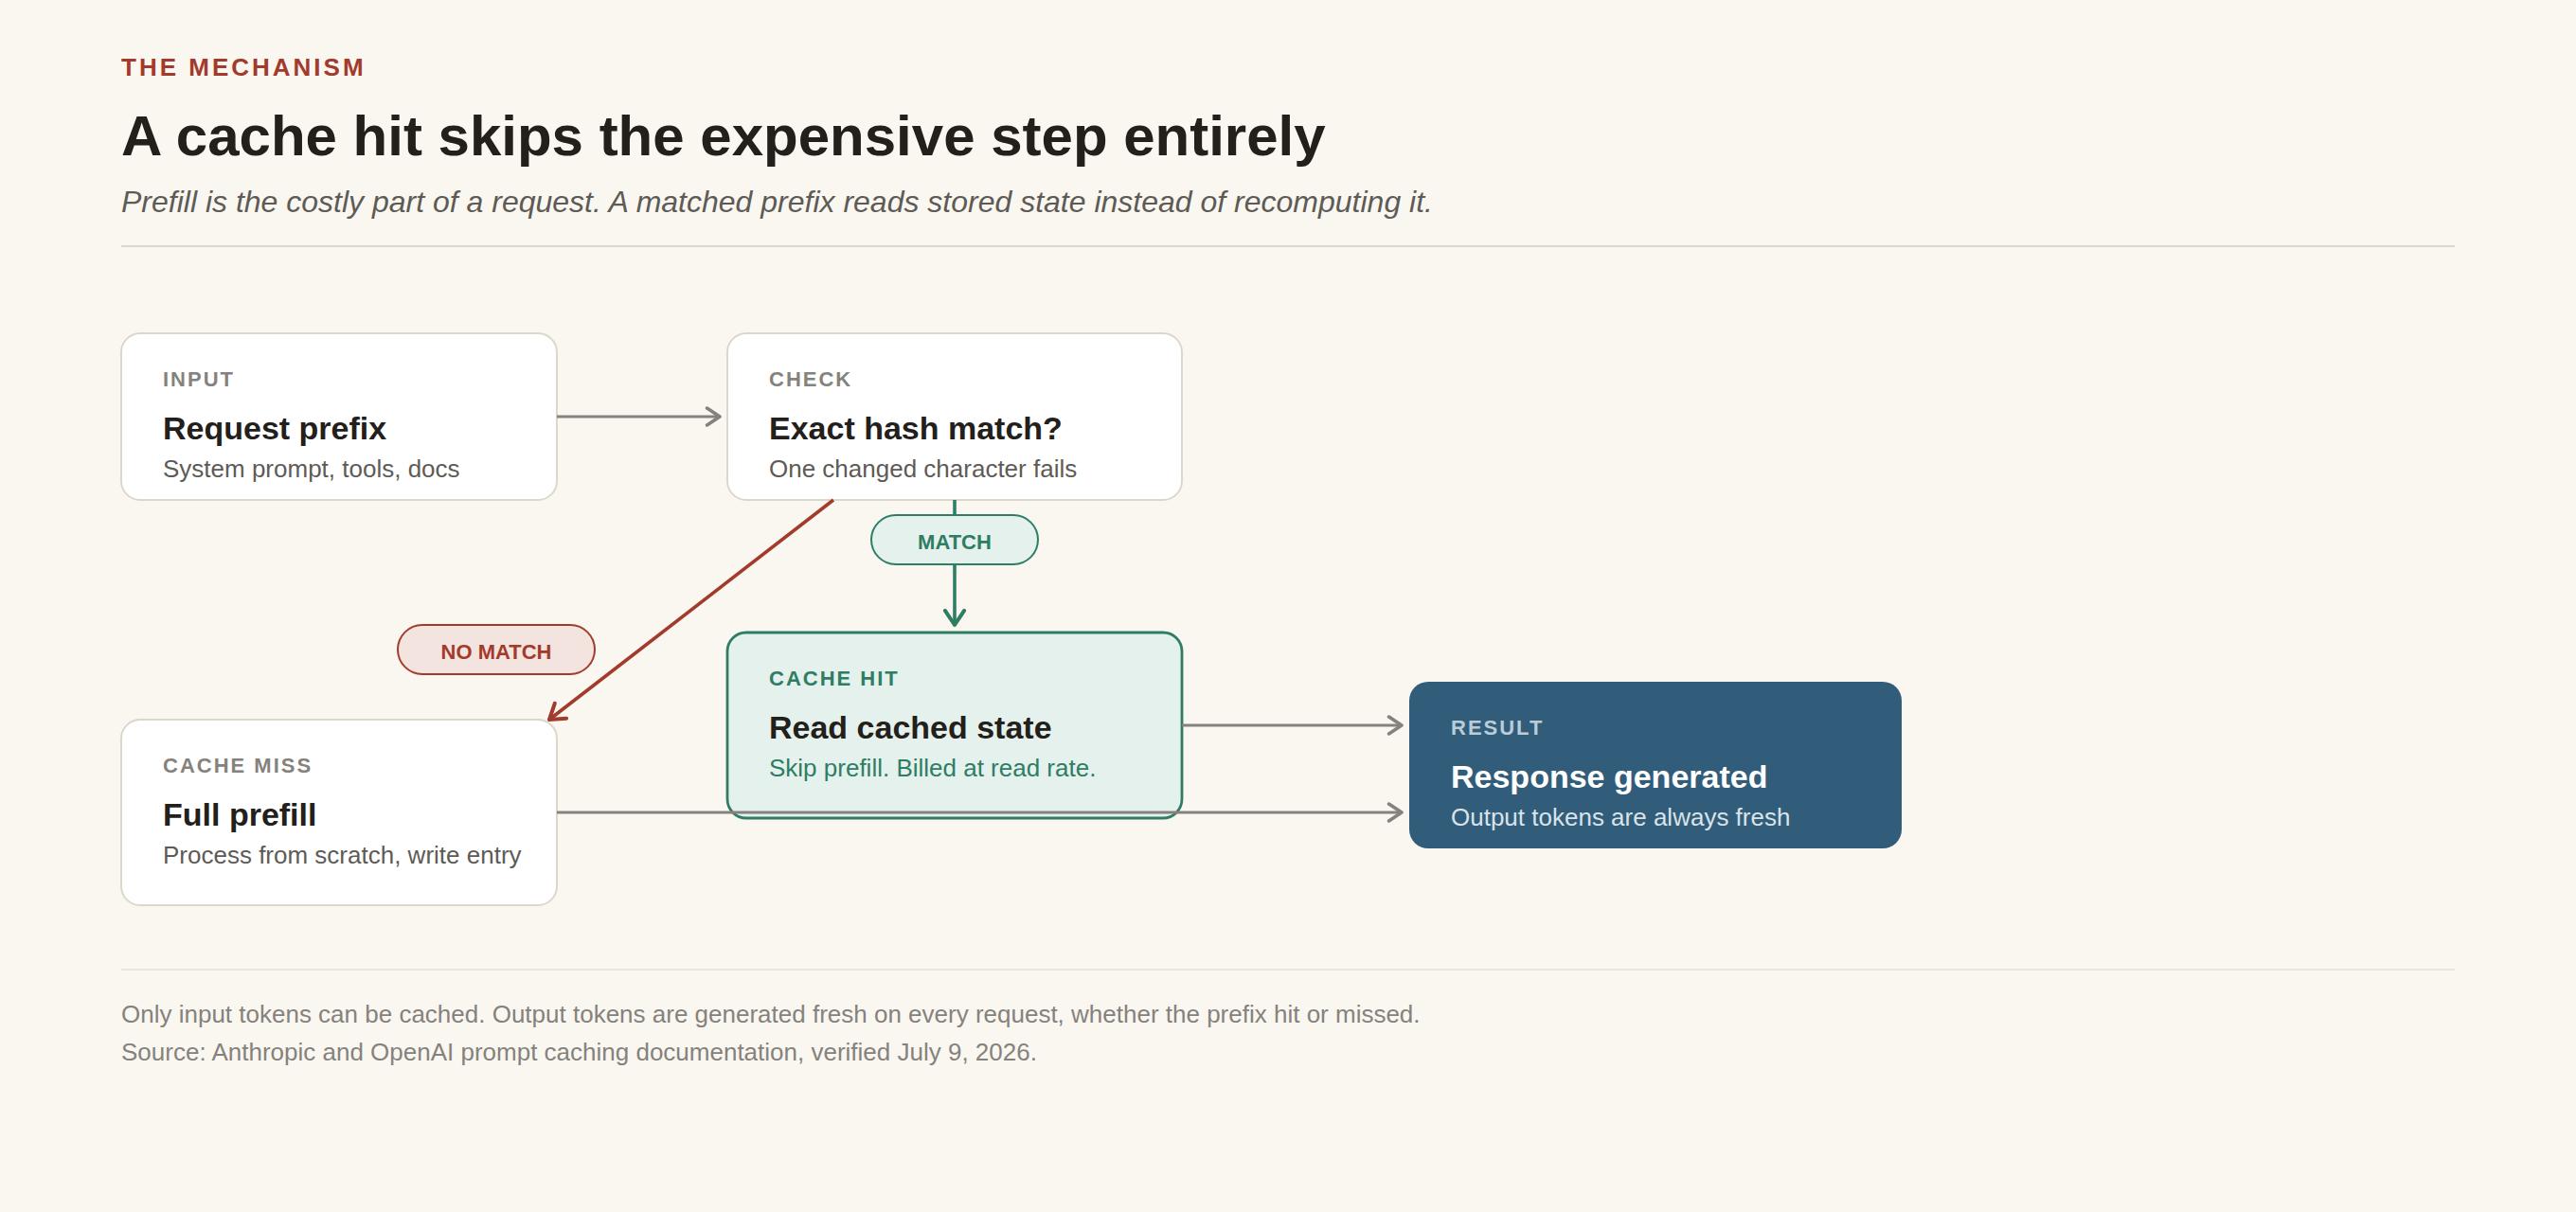 缓存命中会跳过匹配前缀的昂贵预填充步骤。缓存未命中则会处理完整提示词,并在提供显式缓存的提供商上写入新条目以供下次使用。
各提供商的成本结构
每个主要提供商的缓存定价都不同,而且这些差异并非表面功夫。它们会改变缓存对哪些工作负载有帮助。
DigitalOcean 上的 Anthropic 模型使用显式缓存。你可以通过 cache_control 字段(值为 type: ephemeral)以及 ttl(5m(默认)或 1h)在请求中标记边界。写入该边界的首个请求将按高于标准输入费率的溢价计费,DigitalOcean 自己的定价页面确认了倍率:对于 Claude Haiku 4.5,标准输入为每百万 token 1.00 美元,5 分钟缓存创建为 1.25 美元(1.25 倍),1 小时缓存创建为 2.00 美元(2.0 倍),缓存读取为 0.10 美元(0.10 倍,即 90% 折扣)。同样的 1.25x / 2.0x / 0.10x 倍率适用于 DigitalOcean 上的全部 Claude 系列模型。响应中的 usage 对象会在写入请求中报告 cache_creation_input_tokens,并在后续命中中报告 cache_read_input_tokens。
Claude 模型的最小可缓存前缀长度取决于具体模型,通常在 512 token 到 4,096 token 之间。如果你标记的缓存块小于模型要求的限制,该提示片段将不会被缓存,你将继续按正常输入 token 费率付费
请针对你的具体模型,查阅当前文档进行确认。来源:DigitalOcean 提示缓存指南 和 推理定价;Anthropic 提示缓存文档。
请针对你的具体模型,查阅当前文档进行确认。来源:DigitalOcean 提示缓存指南 和 推理定价(最后验证于 2026 年 7 月 14 日);Anthropic 提示缓存文档。
DigitalOcean 上的 OpenAI 模型会缓存 1,024 个或更多 token 的提示词,在 DigitalOcean 上,您可以通过每个请求中的 prompt_cache_retention 参数选择启用,该参数可设置为 in_memory 或 24h。缓存是尽力而为的:当请求的输入 token 与先前响应的前缀匹配时,缓存才会生效,但并不保证一定命中。缓存读取折扣并非一个固定数字,而这一细节值得正确理解,因为 DigitalOcean 自己的定价页面显示,该折扣因模型不同而差异显著。对于 GPT-4o 系列,缓存读取费率恰好是输入费率的一半(GPT-4o:输入 $2.50,缓存读取 $1.25),即折扣 50%。对于 GPT-4.1 和 o3,折扣为 75%。对于 GPT-5 系列,折扣为 90%(GPT-5:输入 $1.25,缓存读取 $0.125)。这些数字直接在 DigitalOcean 自己的推理定价页面上得到确认,验证日期为 2026 年 7 月 14 日。另外,OpenAI 自己的定价文档指出,最新的 GPT-5.6 模型(Sol、Terra、Luna)新增了缓存写入费率,为输入价格的 1.25 倍,这使得它们的行为比旧版 OpenAI 模型更类似于 Anthropic 的明确计费模式。我无法在 DigitalOcean 自己的定价页面上确认这一具体项目,因为 GPT-5.6 在该页面最后一次验证日期之后才在 DigitalOcean 上可用。请在推理定价页面上核实您所用模型的最新费率,而不要假设一个固定的百分比。来源:DigitalOcean 提示缓存操作指南和推理定价,验证日期为 2026 年 7 月 14 日。
DigitalOcean 的 Serverless Inference 上的开源模型支持提示缓存。根据DigitalOcean 当前文档,开源模型的提示缓存处于公开预览阶段,诸如 DeepSeek V3.2 等模型会自动缓存。你完全不需要设置 cache_control 或 prompt_cache_retention;只要请求的 token 与先前请求的前缀匹配,缓存就会以尽力而为的方式应用。缓存按客户账户隔离,基于每个账户的密钥派生,因此一个账户永远无法读取或推断另一个账户的缓存内容。有两个特性使开源路线的行为与上述商业模型不同。首先,没有 1,024 个 token 的最低限制:DigitalOcean 自己文档中的示例显示,一个 214 个 token 的 DeepSeek 请求从缓存中提供了 128 个 token。其次,没有固定的 TTL;文档指出缓存会无期限保留,但应视为机会性缓存,因此你不应依赖缓存命中来获得可预测的成本。缓存的 token 在 usage 对象的两个位置报告:cache_read_input_tokens 和 prompt_tokens_details.cached_tokens,并按照模型的缓存读取折扣费率计费。根据 DigitalOcean 的定价页面,该折扣约为输入价格的 46% 到 80% 不等,具体取决于模型(DeepSeek V3.2:输入 $0.425,缓存读取 $0.15;Qwen3 Coder Flash:输入 $0.45,缓存读取 $0.09),且没有单独的写入加价。来源:DigitalOcean 提示缓存操作指南、推理功能参考以及推理定价,于 2026 年 7 月 14 日核实。
请注意,并非每个开源模型都有托管缓存费率。DigitalOcean 的定价页面列出了 DeepSeek V3.2、Qwen 3 系列、GLM、Kimi 以及数个 NVIDIA 和 MiniMax 模型的提示缓存费率,但没有列出其他模型,包括本文所评测的 Meta Llama 3.3 70B。有关完整的最新列表,请参阅基础模型。
在 DigitalOcean GPU Droplet 上自托管的模型是任何没有托管缓存费率的开源模型的后备方案,也是完全控制缓存层的手段。现代推理引擎 vLLM、SGLang 和 TensorRT-LLM 都支持副本内的自动前缀缓存,将传入的提示与先前缓存的 KV 状态进行匹配,无需用户配置,正如 DigitalOcean 的大规模高级提示缓存工程文章中所详细说明的那样。vLLM 默认启用此功能。没有写入加价,也没有需要跟踪的逐 token 折扣,而且正如本文后面的实测运行所确认的,也没有 1,024 个 token 的最低限制:vLLM 以 16 个 token 的块进行缓存,一个 155 个 token 的提示在第二次出现时命中了缓存。无论缓存是否命中,你都需要按小时支付 GPU 费用(本文测试中使用的单 H200 Droplet 为每小时 $3.44,根据GPU Droplet 定价),因此收益体现在延迟和容量上,而不是逐项折扣:每一次缓存的预填充都是为服务其他请求而腾出的 GPU 时间。
以下所有DigitalOcean数据均来自DigitalOcean官方的提示缓存操作指南和推理定价页面,已于2026年7月核实。
| 路径(在DigitalOcean上) | 机制 | 写入成本 | 读取成本 | 缓存有效期 | 最小前缀 |
|---|---|---|---|---|---|
| Anthropic模型 | 显式,cache_control标记,ttl 5分钟或1小时 |
标准价格的1.25倍(5分钟)或2.0倍(1小时) | 标准价格的0.10倍(优惠90%) | 5分钟或1小时 | 约1,024个token |
| OpenAI模型(GPT-4o、GPT-4.1、GPT-5、o系列) | 尽力而为,通过prompt_cache_retention选择启用(in_memory或24h) |
这些模型无写入溢价 | 因模型而异:优惠50%(GPT-4o)、优惠75%(GPT-4.1、o3)、优惠90%(GPT-5) | in_memory或最长24小时 |
1,024个token |
| OpenAI GPT-5.6模型(费率依据OpenAI官方文档;尚未在DO定价页面上独立确认) | 尽力而为,prompt_cache_retention |
标准价格的1.25倍(缓存写入) | 标准价格的0.10倍(优惠90%) | in_memory或最长24小时 |
1,024个token |
| 开源模型(DeepSeek V3.2、Qwen 3、GLM、Kimi等) | 自动,无参数,按账户隔离(公开预览) | 无写入溢价 | 约优惠46-80%,因模型而异 | 无限制但尽力而为(机会性缓存) | 无(文档显示在214个token处开始缓存) |
| GPU Droplet,自托管vLLM | 自动前缀缓存,默认开启 | 无溢价(GPU按小时计费) | 不按token计费;优势在于TTFT和容量 | 直到被从GPU显存中驱逐(LRU) | 未观察到;16个token块粒度(实测) |
在DigitalOcean上逐个提供商实现缓存
所有三条托管路径都使用相同的OpenAI兼容端点https://inference.do-ai.run/v1,并且在Authorization标头中使用相同的模型访问密钥。每个提供商的不同之处在于你如何请求缓存,以及缓存计数在usage对象中的显示位置。以下示例使用Python标准库,因此无需任何依赖项即可运行,并且完全遵循DigitalOcean的提示缓存操作指南。只需设置一次你的密钥:
export DO_MODEL_ACCESS_KEY="your-model-access-key"
一个小的共享辅助程序会读取缓存字段,这些字段在不同提供者之间略有差异:
import os
import json
import urllib.request

BASE_URL = "https://inference.do-ai.run/v1"
HEADERS = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {os.environ['DO_MODEL_ACCESS_KEY']}",
}


def post_chat(body):
    req = urllib.request.Request(
        BASE_URL + "/chat/completions",
        data=json.dumps(body).encode(),
        headers=HEADERS,
    )
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.loads(r.read())


def cache_report(usage):
    """Normalize the cache fields DigitalOcean returns across model families."""
    details = usage.get("prompt_tokens_details") or {}
    return {
        "prompt_tokens": usage.get("prompt_tokens"),
        "cache_created": usage.get("cache_created_input_tokens", 0),
        "cache_read": usage.get("cache_read_input_tokens", 0),
        # open-source models also expose this field:
        "cached_tokens": details.get("cached_tokens", 0),
    }
Anthropic模型:显式cache_control。 用一个类型为type: ephemeral、ttl为5m(默认)或1h的cache_control断点标记稳定块的结束。该块及其之前的所有内容都会被缓存。将大型、稳定的内容(系统指令、工具定义、参考文档)放在前面并标记它,然后附加易变的用户轮次:
STABLE_SYSTEM_PROMPT = "..."  # your long, stable instructions and reference material

def anthropic_turn(user_message, ttl="1h"):
    body = {
        "model": "claude-haiku-4.5",
        "messages": [
            {
                "role": "system",
                "content": [
                    {
                        "type": "text",
                        "text": STABLE_SYSTEM_PROMPT,
                        "cache_control": {"type": "ephemeral", "ttl": ttl},
                    }
                ],
            },
            {"role": "user", "content": user_message},
        ],
    }
    response = post_chat(body)
    return cache_report(response["usage"])


# First call writes the cache (cache_created > 0); the second reads it (cache_read > 0).
print(anthropic_turn("Summarize the attached policy in three bullets."))
print(anthropic_turn("Now list any compliance risks."))
在第一次请求时,usage对象报告cache_created_input_tokens大于0,而cache_read_input_tokens为0;在TTL窗口内的重复请求中,情况发生翻转,cache_read_input_tokens变为缓存计数,而cache_created_input_tokens则恢复为0。该读取按标准输入费率的0.10倍计费。
OpenAI模型:通过prompt_cache_retention选择启用。无需cache_control标记;你只需设置一个顶层参数为in_memory或24h,缓存会尽力应用于任何1,024个token或以上的提示词。将稳定内容放在消息列表的前面,以便匹配前缀尽可能长:
def openai_turn(messages, retention="24h"):
    body = {
        "model": "gpt-5",
        "prompt_cache_retention": retention,  # "in_memory" or "24h"
        "messages": messages,
        "temperature": 0.2,
    }
    response = post_chat(body)
    return cache_report(response["usage"])


history = [
    {"role": "system", "content": STABLE_SYSTEM_PROMPT},  # >= 1,024 tokens to be eligible
    {"role": "user", "content": "Summarize the attached policy in three bullets."},
]
print(openai_turn(history))  # cache_created_input_tokens on first eligible call
history.append({"role": "user", "content": "Now list any compliance risks."})
print(openai_turn(history))  # cache_read_input_tokens on the repeat
缓存读取折扣因模型而异(GPT-4o 50%折扣,GPT-4.1 和 o3 75%,GPT-5 90%),因此请根据模型的费率读取返回的 cache_read_input_tokens,而不是假设一个固定的百分比。
开源模型:无需配置。 DeepSeek V3.2 和其他具有托管缓存费率的开源模型会自动缓存。你发送一个普通请求,缓存令牌就会同时出现在 cache_read_input_tokens 和 prompt_tokens_details.cached_tokens 中:
def open_source_turn(messages):
    body = {
        "model": "deepseek-3.2",  # caches automatically, no cache params
        "messages": messages,
        "max_tokens": 512,
    }
    response = post_chat(body)
    return cache_report(response["usage"])


history = [
    {"role": "system", "content": STABLE_SYSTEM_PROMPT},
    {"role": "user", "content": "Summarize the attached policy in three bullets."},
]
print(open_source_turn(history))
history.append({"role": "user", "content": "Now list any compliance risks."})
print(open_source_turn(history))  # cached_tokens > 0 once the prefix matches
等效的原始请求,直接来自 DigitalOcean 的文档,是一个完全不包含任何缓存参数的简单 curl 命令:
curl https://inference.do-ai.run/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DO_MODEL_ACCESS_KEY" \
  -d '{
    "model": "deepseek-3.2",
    "messages": [
      {"role": "user", "content": "Summarize this: ..."}
    ],
    "max_tokens": 512
  }'
命中时,响应中的usage块会同时报告这两个字段,例如"cache_read_input_tokens": 128和"prompt_tokens_details": {"cached_tokens": 128},而prompt_tokens为214,这意味着214个输入令牌中有128个以折扣价从缓存中提供,其余86个按标准费率计费。
对于任何没有托管缓存费率的开放模型(例如本文基准测试中的Llama 3.3 70B),可以将其自托管在GPU Droplet上,vLLM会自动应用前缀缓存,无需任何参数,也没有最低限制。这条路径以及如何直接测量它,是本文后面第一手测试的主题。
提示缓存并非冷启动缓解措施
提示缓存和冷启动缓解是解决不同问题的不同机制,而提供商的营销有时会模糊两者,因此有必要明确区分它们。
提示缓存解决的是已在运行的模型部署中重复输入内容的问题。它与模型本身是否已加载到GPU内存无关。冷启动解决的是相反的问题:在空闲期间缩减为零的模型部署,必须先重新加载才能再次服务第一个请求。这段重新加载时间完全体现在首令牌延迟(即第一个输出令牌流回之前的延迟)上,并且不影响每输出令牌时间(即响应开始后的稳态生成速度)。
在DigitalOcean的Serverless Inference中,空闲一段时间后可能会发生冷启动,而空闲后的第一个请求可能会因为容量重新扩展而变慢。这是缩减为零并在空闲时无需付费所付出的代价。DigitalOcean自身的指导建议是,稳定的、对延迟敏感的工作负载更适合保留容量的专用部署,而不是无服务器部署。来源:在哪里托管你的开源模型,DigitalOcean社区。具体到微调适配器,DigitalOcean自身的分析发现,当只需重新加载一个轻量级适配器时,冷启动会使首令牌延迟急剧增加大约几百毫秒,并且可以通过定期发送保持活动的请求来缓解这一问题。来源:无服务器架构上的微调LLM,DigitalOcean社区。
真正减少冷启动延迟的是模型预加载、预备容量的热池,或者永远不会缩减为零的专用部署。真正降低重复输入内容成本的是提示缓存。两者不能相互替代,同时存在这两种问题的工作负载需要两种解决方案。
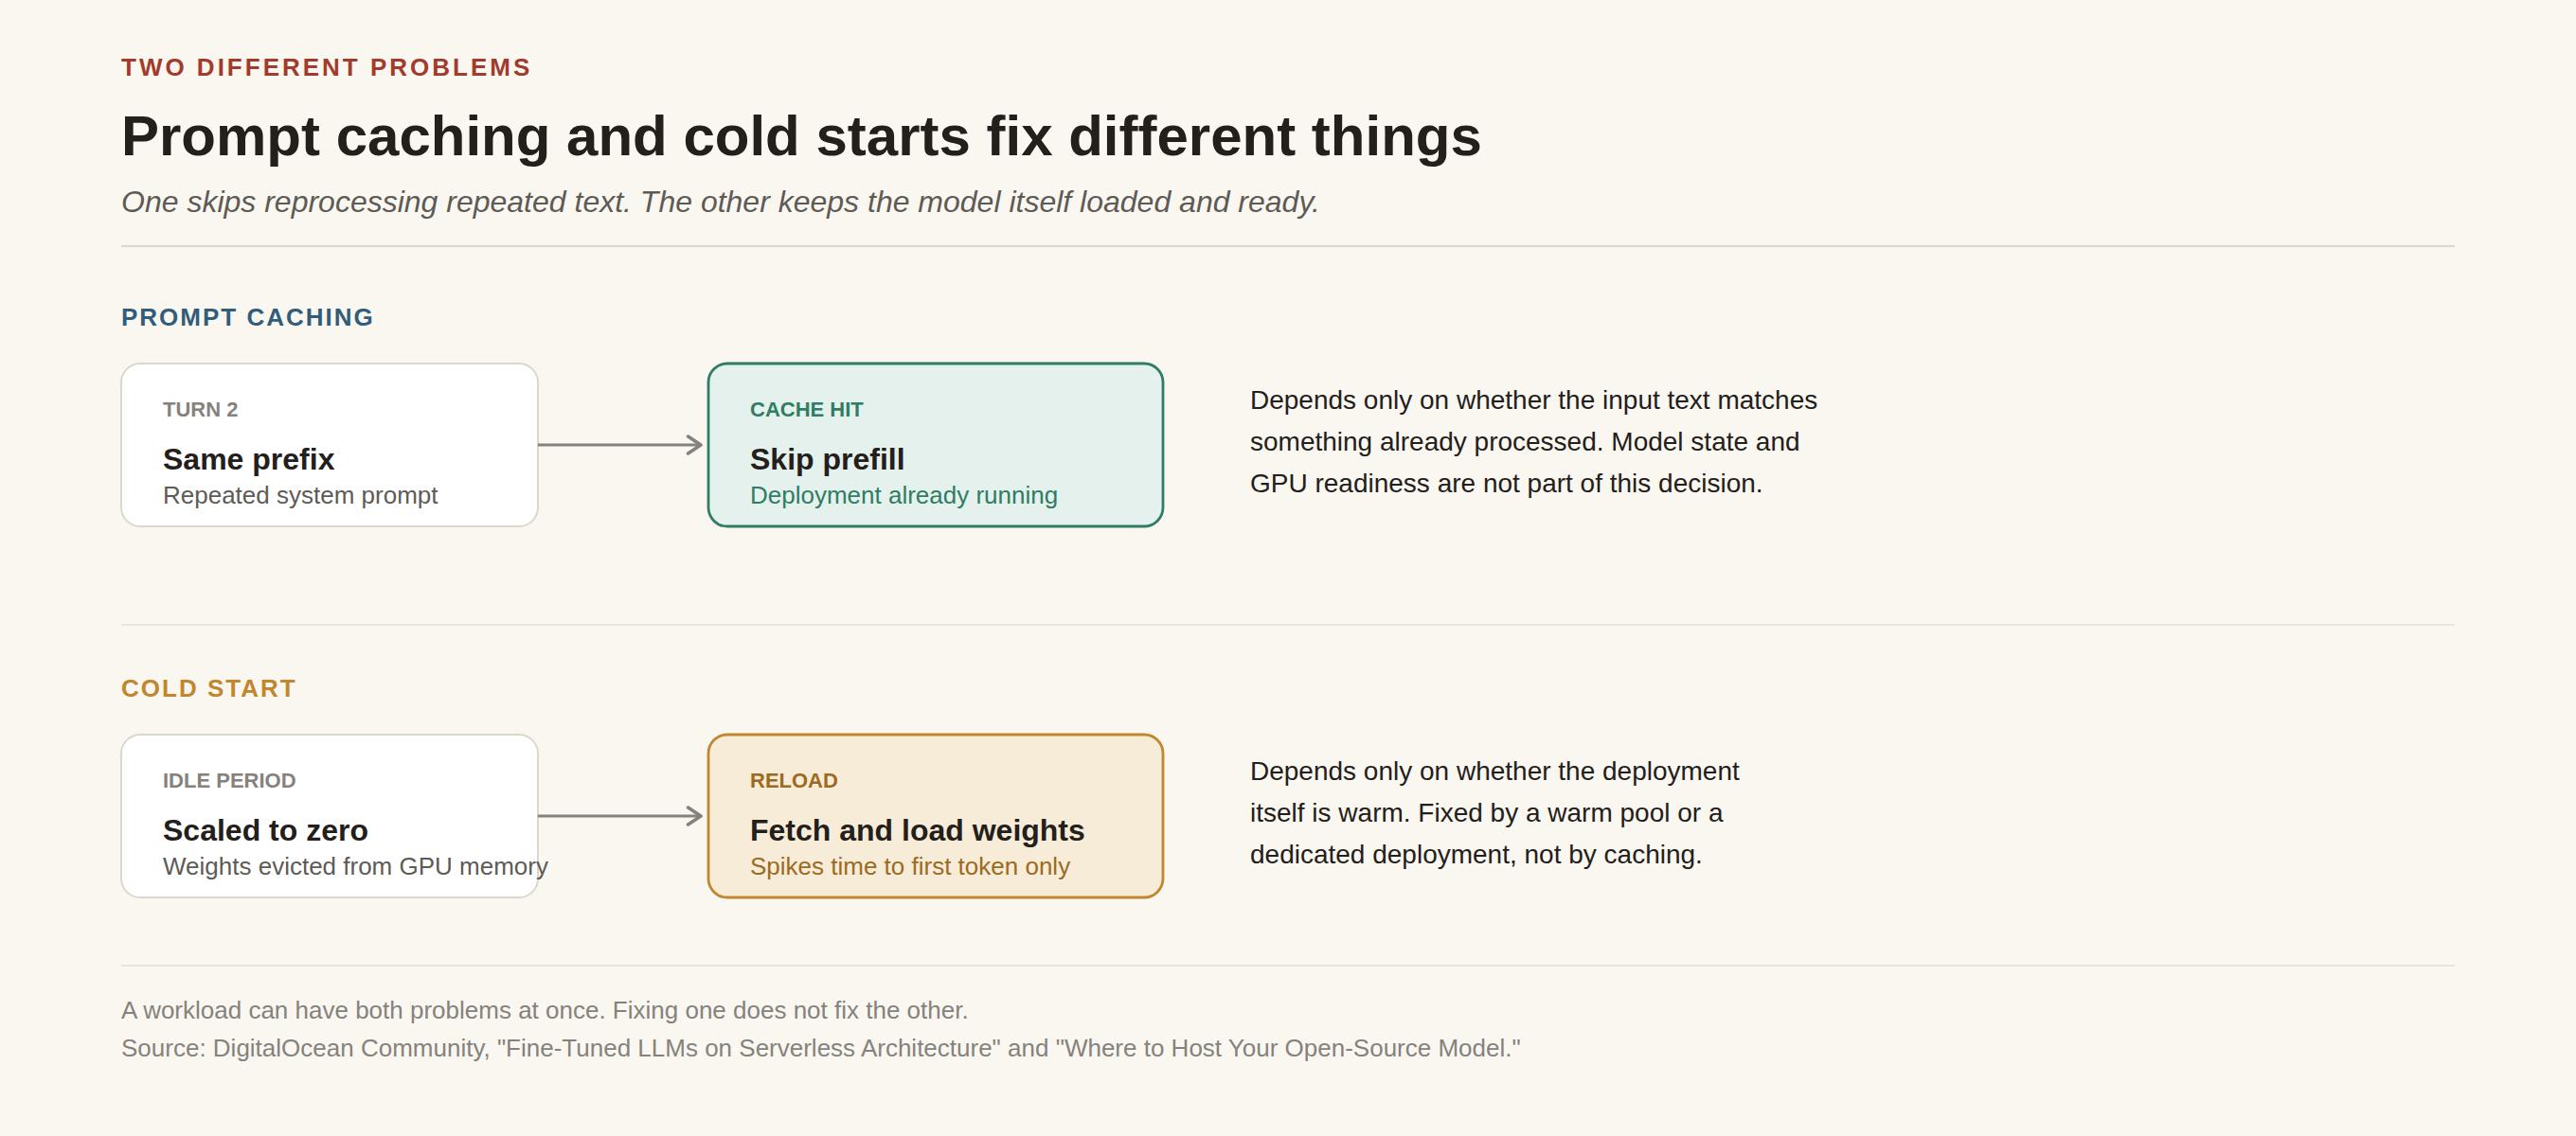 缓存会跳过对已在运行部署中重复内容的重新处理。冷启动缓解则保持部署本身随时可服务。它们解决不同的问题,且彼此无法替代。
基于各提供商自身数据得出的盈亏平衡公式
这里是大多数讲解者跳过的重要部分:一个可以用您自己提供商的已发布费率重新计算的实用公式,而不仅仅是表面上的百分比。
将写入乘数 w 定义为首次建立缓存前缀的请求成本(相对于标准输入价格),将读取乘数 r 定义为后续命中同一缓存前缀的请求成本(同样相对于标准价格)。在使用缓存变得比完全不使用缓存更便宜之前所需的缓存命中次数,我称之为盈亏平衡点 h*,其计算公式为:
h* = (w − 1) / (1 − r)
代入Anthropic自己公布的数字。在5分钟缓存档位中,w = 1.25,r = 0.10,得出 h* = 0.25 / 0.90 ≈ 0.28。由于不能有小数次的命中,因此向上取整为1:在一次缓存命中之后——即在两次请求序列中的第二次请求时——一次写入加上一次读取的总成本已经低于按全价支付两次的成本。我直接验证过:两次全价请求的成本为标准费率的2.0倍,而一次写入加一次读取的成本为1.25加0.10,即1.35,确实更便宜。在1小时缓存档位中,w = 2.0,得出 h* = 1.0 / 0.90 ≈ 1.11,向上取整后,在更长、更昂贵的写入成本收回之前,需要2次缓存命中。
再代入无写入溢价模型的数据,该模型在DigitalOcean上涵盖大多数OpenAI模型(GPT-4o、GPT-4.1、GPT-5、o系列)以及所有开源模型。此时 w = 1,公式得出 h* = 0。每一次缓存命中从第一次开始就是纯粹的节省,因为没有额外的成本需要回收。这就是显式缓存和自动缓存之间的实际区别:Anthropic的模型在命中次数过少的工作负载上可能会亏损,而无溢价模型在结构上则不可能亏损。有一点值得直接提醒:OpenAI自己的定价文档指出,GPT-5.6(Sol、Terra、Luna)引入了相当于未缓存输入费率1.25倍的缓存写入费率,这与早期OpenAI模型有所不同。截至本文撰写时,我无法在DigitalOcean自己的Inference定价页面上确认这一条目,因为该页面最后核验日期为2026年7月1日,当时GPT-5.6尚未在DigitalOcean平台上提供。如果您通过DigitalOcean使用GPT-5.6,在假设 h* = 0 之前,请查看实时定价页面以了解当前的缓存写入费率。
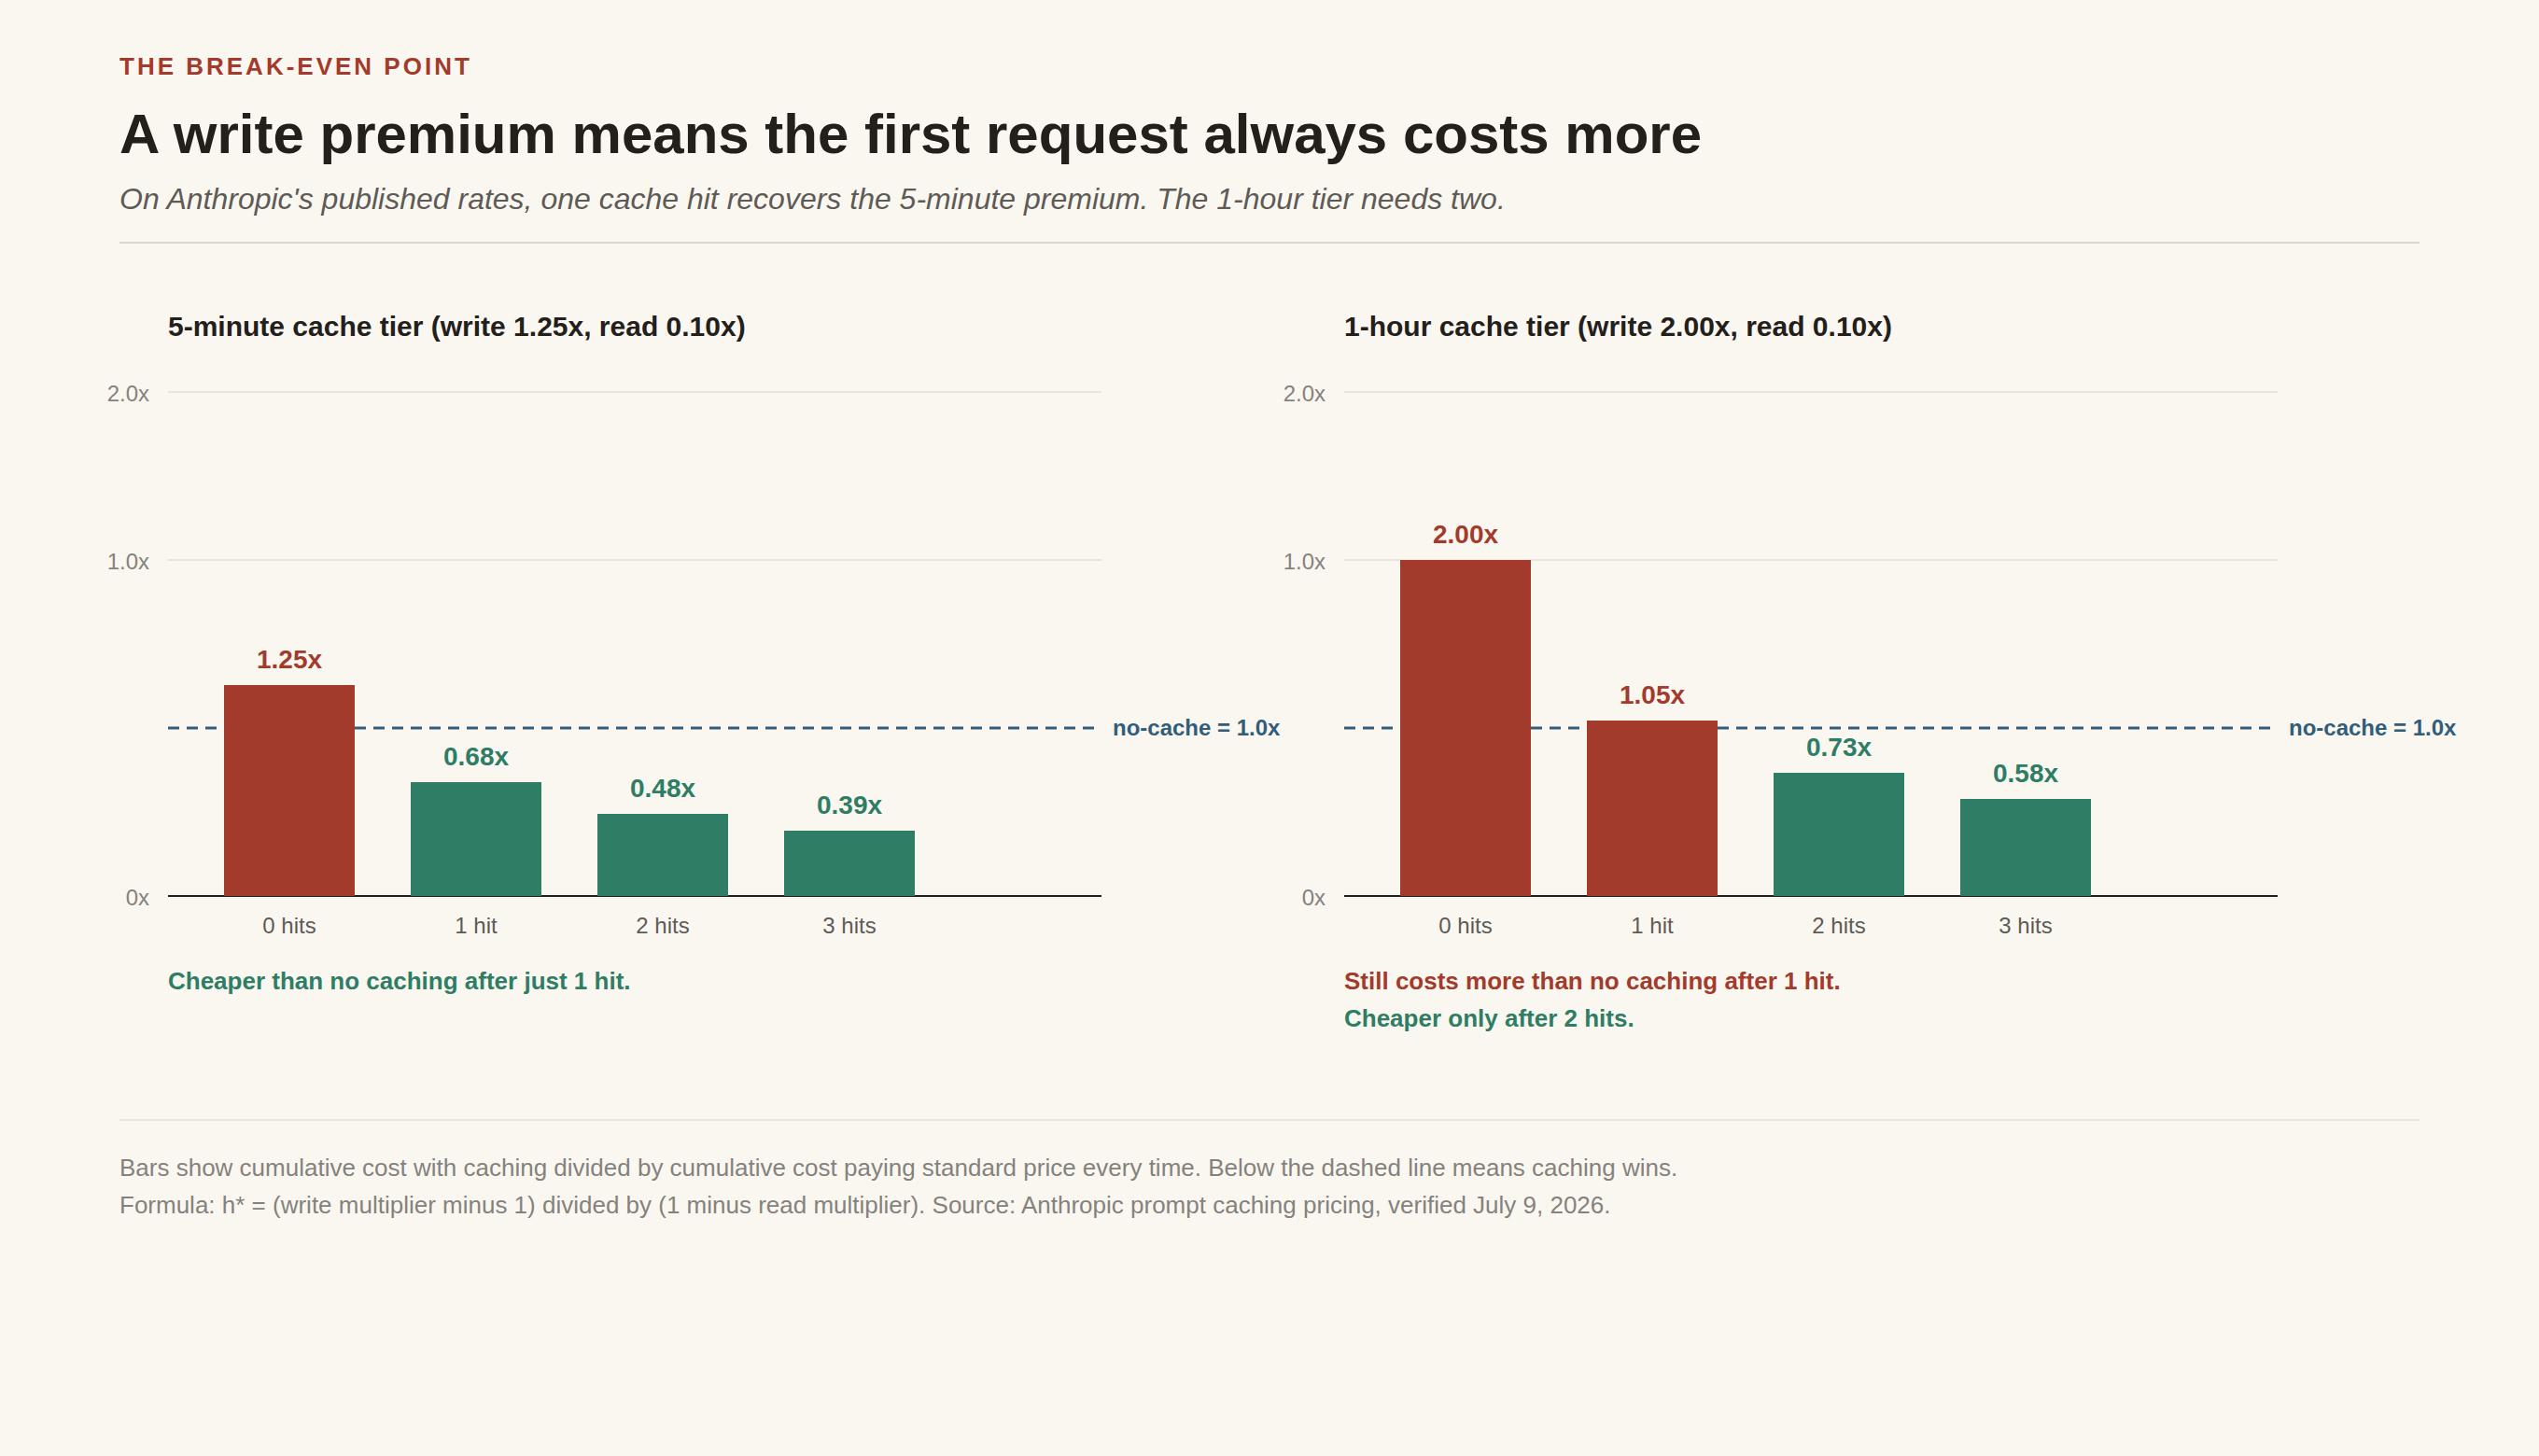 每条线都显示了缓存变得比每次都按标准价格付费更便宜的那个临界点。写入溢价意味着首次请求的成本更高,您必须先收回这笔成本,缓存才能开始产生收益。
这个公式能告诉您什么,又不能告诉您什么
这个公式告诉你,一旦你知道提供商的费率,你就能确切地知道需要多少次命中。它并不告诉你你的流量是否真的会产生那么多次命中。第二个问题取决于本文主旨中提到的三个变量,而每个变量都对应一个具体的、可衡量的失败模式。
前缀稳定性低于最小可缓存长度,对商业模型来说是一个硬性门槛,而不是程度问题。如果你的整个提示词低于1,024个令牌,Anthropic和OpenAI模型(在DigitalOcean及其他地方)将不会缓存其中的任何部分,无论你重复多少次,或者请求到达得有多快。这值得直接针对本文后面用作示例的聊天机器人工作负载加以说明:一个400令牌的系统提示词在两者上都低于该阈值。该工作负载在那些模型上根本无法缓存,这与会话深度或时序无关。不过,这个门槛并非普遍适用:DigitalOcean的开源模型没有文档化的最小值(文档显示在214个令牌时进行缓存),而本文后面测量的短提示词测试显示,自托管引擎在155个令牌时进行缓存。该门槛是商业模型的政策,而不是机制的特性,如果小提示词工作负载正促使你转向开源或自托管模型,这一点就很重要。
会话深度低于提供商层级对应的h*,意味着如果存在写入溢价,你永远无法收回它。一个一次性请求写入了缓存条目,却从未有匹配请求随后到达,那么它支付了溢价却一无所得。在任何收取该溢价的提供商那里,这都是纯粹的损失。
到达间隔时间超过缓存生命周期,意味着每个请求都被视为新请求,无论会话深度如何。如果你的请求相隔7分钟,而你使用的是Anthropic的5分钟层级,那么每个请求都会重写缓存,且没有一个请求会读取缓存,这保证了你每次都支付写入溢价,却从未享受折扣。这里的解决办法不是放弃缓存,而是如果你的流量稀疏但最终会重复,就使用1小时层级,接受更高的h*(2次命中),以换取更宽的时间窗口来达到这些命中。
一个实际示例,并测量命中率
为了展示该公式如何随真实会话深度扩展,以Anthropic的5分钟层级上的一次20轮代理会话为例,其中一段稳定的3,000令牌系统提示词和工具定义块在每一轮中都被复用,并且每一轮都在上一轮的5分钟内到达。这里的价格乘数是Anthropic公布的价格。命中率——第一轮一次未命中,之后每一轮都命中——并不是本文的假设:下面亲身测试中测量的12轮会话,运行在DigitalOcean GPU Droplet上的Llama 3.3 70B上,流量形状恰好如此,在随后的11轮中产生了11次缓存命中,令牌级命中率为98.7%。在本文考察的每个缓存实现中,在缓存窗口内复用的稳定前缀基本上每次都能命中。
将该命中模式应用于Anthropic的定价。稳定块中的令牌按1次写入(1.25倍)加19次读取(每次0.10倍)计费,20个请求总计为标准费率的1.25 + 1.9 = 3.15倍,而完全不使用缓存时则为标准费率的20.0倍。这大约使该部分输入减少84%,远高于1次命中的盈亏平衡点,并且与我查阅的行业资料中关于长时间代理会话所报告的“50%到90%”范围一致。对比一个3轮聊天机器人会话,其系统提示为4,000个令牌,远高于最低要求,但只有2次命中机会。在2次命中的情况下:3个请求总计为标准费率的1.25 + 0.20 = 1.45倍,而缓存未命中时为标准费率的3.0倍,该部分减少52%,绝对值较小,因为分摊写入成本的请求较少,但仍然超过了盈亏平衡点。彻底失败的聊天机器人示例并不是这个。而是之前门控中的400令牌提示,它从一开始就永远没有资格在托管提供商处缓存。
实测运行增加了一个注意事项:近乎完美的命中率仅在前缀逐字节稳定时成立。同样的实测会话在系统提示顶部添加时间戳和请求ID后重新运行,其他一切相同,令牌命中率从98.7%下降到0.7%。如果你的示例假设20次中有19次命中,但你的提示模板在稳定块之前注入了任何动态内容,那么你的实际数字将是后者。在围绕任一数字规划预算之前,请使用下一节中的测试工具测量你自己的流量。
第一手测试:测量你自己流量上的缓存行为
这是本文中最重要的部分,因为它用你可复现的运行取代了假设。下面的测试工具已针对实时模型服务端点执行,后续表格中的每一个数字都直接来自该次测试运行。本部分末尾提供了托管平台DIY测试工具,供任何拥有密钥的人使用。所测量的缓存机制是精确前缀KV复用,这是每个提供商都实现的同一机制,因此即使计费模型不同,命中率行为也具有可移植性。
实测环境
- 基础设施: DigitalOcean GPU Droplet,
gpu-h200x1-141gb(1x NVIDIA H200,141 GB显存,24个vCPU,240 GB内存),每小时$3.44,NYC2区域,从一键推理就绪镜像创建。参见GPU Droplet定价。 - 服务栈: vLLM 0.24.0(
vllm/vllm-openai:v0.24.0Docker镜像),默认启用自动前缀缓存(引擎启动日志中的enable_prefix_caching=True)。 - 模型:
RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic,FP8 KV缓存,4,096令牌上下文,单GPU。
精确的服务命令,以便环境可复现:
docker run -d --name vllm-bench --gpus all \
  -v /root/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  vllm/vllm-openai:v0.24.0 \
  RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic \
  --kv-cache-dtype fp8 \
  --max-model-len 4096 \
  --max-num-seqs 256 \
  --gpu-memory-utilization 0.92 \
  --tensor-parallel-size 1 \
  --port 8000
测试时在 Droplet 上运行 nvidia-smi,确认硬件及已加载的引擎(输出仅保留相关行):
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 575.57.08              Driver Version: 575.57.08      CUDA Version: 12.9     |
|-----------------------------------------+------------------------+----------------------+
|   0  NVIDIA H200                    On  |   00000000:83:00.0 Off |                    0 |
| N/A   43C    P0            125W /  700W |  134095MiB / 143771MiB |      0%      Default |
+-----------------------------------------+------------------------+----------------------+
|    0   N/A  N/A         1644641      C   VLLM::EngineCore                      13408... |
+-----------------------------------------------------------------------------------------+
引擎自身的启动日志行确认前缀缓存已激活,而无需我们进行任何配置:
Initializing a V1 LLM engine (v0.24.0) with config:
model='RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic', ...
kv_cache_dtype=fp8, ... enable_prefix_caching=True, enable_chunked_prefill=True, ...
测试设计
针对同一模型运行四个合成工作负载,除流量形态外保持其他一切不变:
- TTFT 扫描。大约 512、1,024、2,048 和 3,072 个 token 的唯一前缀,每个前缀先冷发送一次,再热发送三次,以衡量前缀大小增长时命中的延迟收益。
- 智能体工作负载。一个稳定的 2,048-token 系统提示,后接 12 个连续对话轮次,对话历史不断增长,每个轮次大约在上一个轮次之后一秒到达。
- 前缀破坏者工作负载。与智能体工作负载相同,但有一处更改:每轮都在系统提示的顶部注入请求 ID 和时间戳,这是生产环境中最常见的缓存错误。
- 短提示工作负载。将一个 117-token 的系统提示重复四次,以测试商业模型强制执行的 1,024-token 最低限制是否存在于引擎层面。
测量内容与测量方式
vLLM 不像托管提供商那样在 OpenAI 兼容的 usage 对象中返回每个请求的缓存 token 数量,但在其 Prometheus /metrics 端点上暴露了引擎级计数器:vllm:prefix_cache_queries_total(针对缓存检查的 token 数量)以及 vllm:prefix_cache_hits_total(由缓存提供服务的 token 数量)。一个命名说明:vLLM 自身的指标文档将这些列作 vllm:prefix_cache_queries 和 vllm:prefix_cache_hits,不带 _total 后缀。Prometheus 客户端库通常在实际暴露的文本输出中将 _total 附加到 Counter 类型的指标上,这与下面 curl 的输出一致。但如果你的版本不同,在依赖确切字符串之前,请使用 curl localhost:8000/metrics | grep prefix_cache 列出你端点的实际指标名称。测试工具串行地发出请求,并在每个请求前后对这些计数器进行比较,从而将命中的 token 精确归属到单个请求。首 token 时间在客户端启用流式传输的情况下测量,对第一个内容块打上时间戳。
以下是在 Droplet 上直接查询时这些计数器看起来的样子:
curl -s localhost:8000/metrics | grep -E "^vllm:prefix_cache_(queries|hits)_total"
vllm:prefix_cache_queries_total{engine="0",model_name="RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic"} 2.99845e+06
vllm:prefix_cache_hits_total{engine="0",model_name="RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic"} 194672.0
测试工具
这是我编写的完整脚本,用于生成本文中每个测量数字,cache_bench.py,可针对任何vLLM端点运行,除Python标准库外无需任何依赖。保存它,将--base-url指向你的端点,它就会运行所有四个工作负载,并将每次请求的原始记录写入JSON文件。
即使你更改工作负载,这种测量模式也值得借鉴:measured_turn会对每个串行请求前后的引擎前缀缓存计数器做差分,从而将缓存的令牌精确归因于各个请求;make_prefix则根据vLLM的/tokenize端点校准提示大小,因此“2,048令牌前缀”的含义名副其实。
#!/usr/bin/env python3
"""
Prefix-cache benchmark for a vLLM OpenAI-compatible endpoint.

Measures, per request:
  - TTFT (time to first streamed token)
  - total latency
  - prompt tokens (from the usage object)
  - cached prefix tokens (by diffing vLLM's /metrics prefix-cache counters
    around each request, so requests are issued serially)

Workloads:
  1. ttft_sweep     - cold vs warm TTFT across prefix sizes
  2. agent_session  - stable system prompt + growing history, N turns
  3. prefix_buster  - identical session but a timestamp at the TOP of the
                      system prompt, which breaks exact-prefix matching
  4. short_prompt   - a ~120-token prompt repeated, to observe block-level
                      behavior below typical managed-provider minimums

Run on the droplet (or anywhere that can reach the endpoint):
  python3 cache_bench.py --base-url http://localhost:8000 --out results.json
"""

import argparse
import json
import time
import urllib.request
import uuid

WORD = "inference "  # 1 word ~= 1.2 tokens for this tokenizer; calibrated below


def http_json(url, payload=None, timeout=120):
    data = json.dumps(payload).encode() if payload is not None else None
    req = urllib.request.Request(
        url, data=data, headers={"Content-Type": "application/json"}
    )
    with urllib.request.urlopen(req, timeout=timeout) as r:
        return json.loads(r.read())


def get_cache_counters(base_url):
    with urllib.request.urlopen(base_url + "/metrics", timeout=30) as r:
        text = r.read().decode()
    queries = hits = 0.0
    for line in text.splitlines():
        if line.startswith("vllm:prefix_cache_queries_total"):
            queries = float(line.rsplit(" ", 1)[1])
        elif line.startswith("vllm:prefix_cache_hits_total"):
            hits = float(line.rsplit(" ", 1)[1])
    return queries, hits


def streamed_request(base_url, model, messages, max_tokens=32):
    """Send a streaming chat completion; return TTFT, total time, usage."""
    payload = {
        "model": model,
        "messages": messages,
        "max_tokens": max_tokens,
        "temperature": 0,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    req = urllib.request.Request(
        base_url + "/v1/chat/completions",
        data=json.dumps(payload).encode(),
        headers={"Content-Type": "application/json"},
    )
    start = time.perf_counter()
    ttft = None
    usage = {}
    content_parts = []
    with urllib.request.urlopen(req, timeout=300) as r:
        for raw in r:
            line = raw.decode().strip()
            if not line.startswith("data:"):
                continue
            body = line[5:].strip()
            if body == "[DONE]":
                break
            chunk = json.loads(body)
            if chunk.get("usage"):
                usage = chunk["usage"]
            for choice in chunk.get("choices", []):
                delta = choice.get("delta", {})
                if delta.get("content"):
                    if ttft is None:
                        ttft = time.perf_counter() - start
                    content_parts.append(delta["content"])
    total = time.perf_counter() - start
    return {
        "ttft_s": ttft,
        "total_s": total,
        "prompt_tokens": usage.get("prompt_tokens"),
        "completion_tokens": usage.get("completion_tokens"),
        "content": "".join(content_parts),
    }


def measured_turn(base_url, model, messages, max_tokens=32):
    q0, h0 = get_cache_counters(base_url)
    result = streamed_request(base_url, model, messages, max_tokens)
    q1, h1 = get_cache_counters(base_url)
    result["cache_query_tokens"] = int(q1 - q0)
    result["cache_hit_tokens"] = int(h1 - h0)
    return result


def make_prefix(base_url, model, target_tokens):
    """Build a unique prefix of roughly target_tokens, calibrated via tokenize API."""
    tag = f"run-{uuid.uuid4().hex[:8]} "
    words = int(target_tokens * 0.9)
    text = tag + (WORD * words)
    # calibrate with the /tokenize endpoint
    for _ in range(6):
        n = http_json(
            base_url + "/tokenize", {"model": model, "prompt": text}
        )["count"]
        if abs(n - target_tokens) <= 8:
            break
        delta_words = int((target_tokens - n) * 0.8)
        if delta_words > 0:
            text += WORD * delta_words
        else:
            text = text[: delta_words * len(WORD)]
    return text, n


def ttft_sweep(base_url, model, sizes, warm_repeats=3):
    out = []
    for size in sizes:
        prefix, actual = make_prefix(base_url, model, size)
        messages = [
            {"role": "system", "content": prefix},
            {"role": "user", "content": "Reply with the single word: ready."},
        ]
        cold = measured_turn(base_url, model, messages, max_tokens=8)
        warms = [
            measured_turn(base_url, model, messages, max_tokens=8)
            for _ in range(warm_repeats)
        ]
        out.append(
            {
                "target_prefix_tokens": size,
                "actual_prefix_tokens": actual,
                "cold": cold,
                "warm": warms,
            }
        )
        print(f"[ttft_sweep] {size} tokens done", flush=True)
    return out


def agent_session(base_url, model, prefix_tokens=2048, turns=12, bust_prefix=False):
    prefix, actual = make_prefix(base_url, model, prefix_tokens)
    results = []
    history = []
    for i in range(turns):
        system = prefix
        if bust_prefix:
            # per-request variable content at the TOP: the classic mistake
            system = f"[request-id: {uuid.uuid4()}] [ts: {time.time()}]\n" + prefix
        messages = (
            [{"role": "system", "content": system}]
            + history
            + [{"role": "user", "content": f"Turn {i}: answer in five words or fewer."}]
        )
        r = measured_turn(base_url, model, messages, max_tokens=16)
        r["turn"] = i
        results.append(r)
        history.append({"role": "user", "content": f"Turn {i}: answer in five words or fewer."})
        history.append({"role": "assistant", "content": r["content"] or "ok"})
        time.sleep(1)
    return {"prefix_tokens": actual, "turns": results}


def short_prompt(base_url, model, repeats=4):
    prefix, actual = make_prefix(base_url, model, 120)
    messages = [
        {"role": "system", "content": prefix},
        {"role": "user", "content": "Reply with one word."},
    ]
    return {
        "prefix_tokens": actual,
        "requests": [
            measured_turn(base_url, model, messages, max_tokens=8)
            for _ in range(repeats)
        ],
    }


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--base-url", default="http://localhost:8000")
    ap.add_argument("--out", default="cache_bench_results.json")
    args = ap.parse_args()

    model = http_json(args.base_url + "/v1/models")["data"][0]["id"]
    print(f"Model: {model}", flush=True)

    results = {"model": model, "timestamp": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime())}

    print("== TTFT sweep ==", flush=True)
    results["ttft_sweep"] = ttft_sweep(args.base_url, model, [512, 1024, 2048, 3072])

    print("== Agent session (stable prefix) ==", flush=True)
    results["agent_session"] = agent_session(args.base_url, model, 2048, 12)

    print("== Prefix-buster session (timestamp first) ==", flush=True)
    results["prefix_buster"] = agent_session(args.base_url, model, 2048, 12, bust_prefix=True)

    print("== Short prompt ==", flush=True)
    results["short_prompt"] = short_prompt(args.base_url, model)

    with open(args.out, "w") as f:
        json.dump(results, f, indent=2)
    print(f"Wrote {args.out}", flush=True)


if __name__ == "__main__":
    main()
在Droplet上执行的完整运行:
python3 cache_bench.py --base-url http://localhost:8000 --out cache_bench_results.json
Model: RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic
== TTFT sweep ==
[ttft_sweep] 512 tokens done
[ttft_sweep] 1024 tokens done
[ttft_sweep] 2048 tokens done
[ttft_sweep] 3072 tokens done
== Agent session (stable prefix) ==
== Prefix-buster session (timestamp first) ==
== Short prompt ==
Wrote cache_bench_results.json
结果如下所示:
{
  "model": "RedHatAI/Llama-3.3-70B-Instruct-FP8-dynamic",
  "timestamp": "2026-07-14T13:45:35Z",
  "ttft_sweep": [
    {
      "target_prefix_tokens": 512,
      "actual_prefix_tokens": 510,
      "cold": {
        "ttft_s": 0.11955002718605101,
        "total_s": 0.14034194918349385,
        "prompt_tokens": 551,
        "completion_tokens": 2,
        "content": "ready",
        "cache_query_tokens": 551,
        "cache_hit_tokens": 16
      },
      "warm": [
        {
          "ttft_s": 0.03656787099316716,
          "total_s": 0.05752997612580657,
          "prompt_tokens": 551,
          "completion_tokens": 2,
          "content": "ready",
          "cache_query_tokens": 551,
          "cache_hit_tokens": 544
        },
        {
          "ttft_s": 0.03680372005328536,
          "total_s": 0.05818751105107367,
          "prompt_tokens": 551,
          "completion_tokens": 2,
          "content": "ready",
          "cache_query_tokens": 551,
          "cache_hit_tokens": 544
        },
下面的每个表格都直接读取自该结果文件,并且每条请求的原始记录都显示在对应表格旁边。
实测结果1:缓存命中将TTFT降低了69%至92%,且随前缀大小扩展
每一行代表一个唯一前缀:先以冷启动方式发送(首次出现,无缓存条目),随后以热启动方式发送三次(相同前缀,缓存已填充)。热启动TTFT取三次重复的平均值,三次结果之间的差异小于2毫秒。
| 提示词Token数 | 冷启动TTFT | 热启动TTFT | TTFT降幅 | 热请求中缓存的Token数 |
|---|---|---|---|---|
| 551 | 120 ms | 37 ms | 69% | 544/551(98.7%) |
| 1,061 | 178 ms | 37 ms | 79% | 1,056/1,061(99.5%) |
| 2,081 | 319 ms | 37 ms | 88% | 2,080/2,081(100%) |
| 3,110 | 462 ms | 39 ms | 92% | 3,104/3,110(99.8%) |
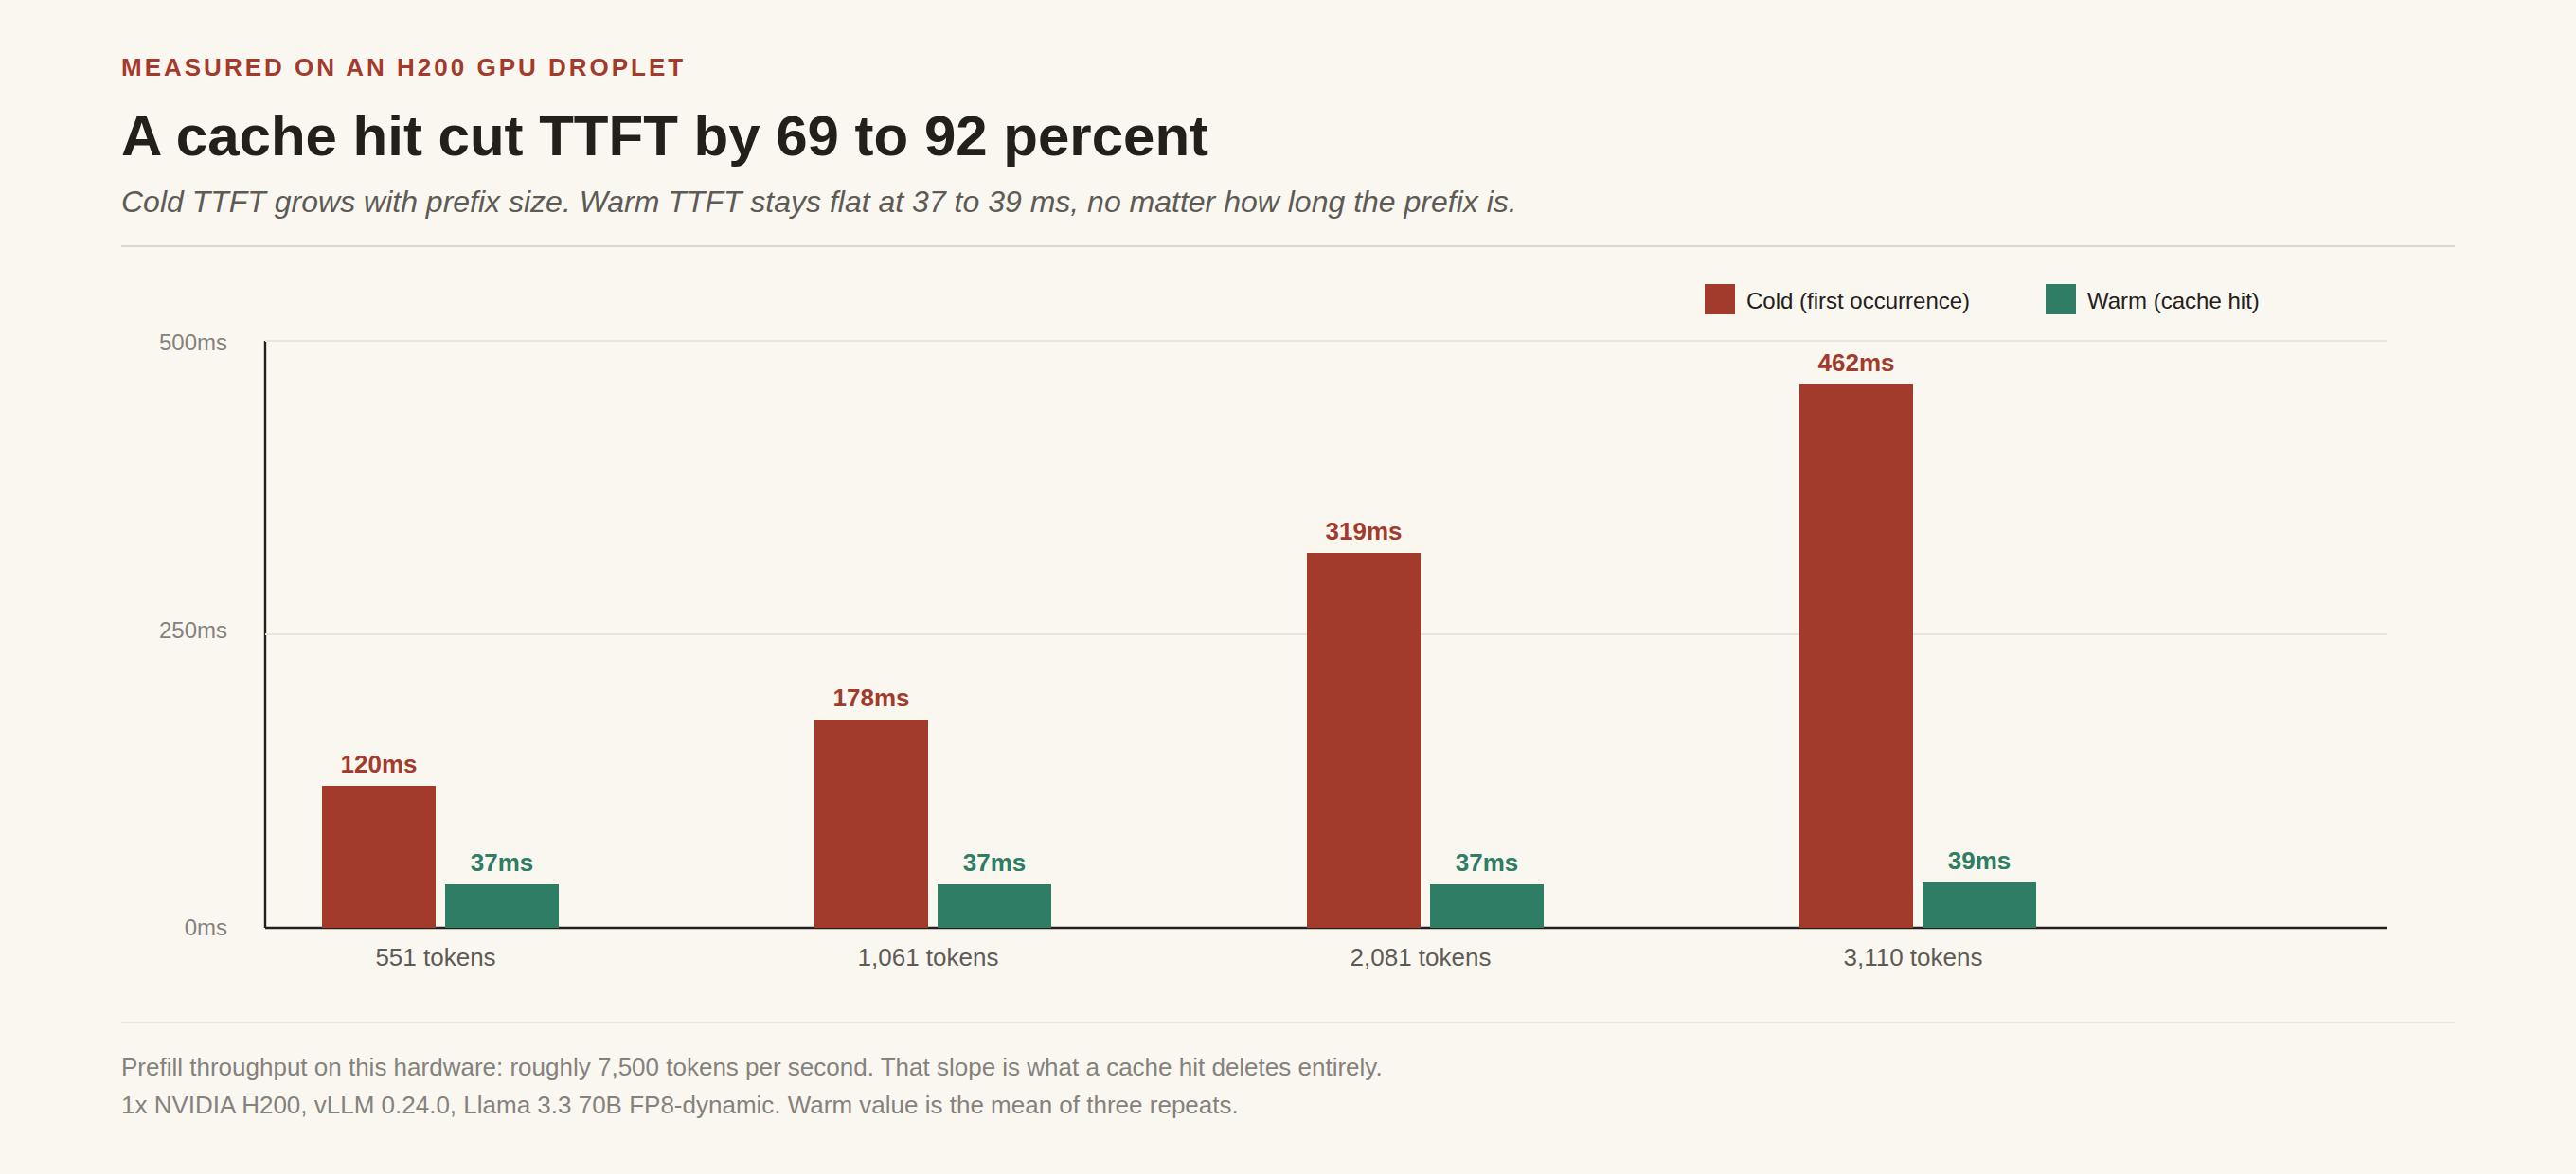 冷启动TTFT随前缀大小扩展,因为预填充(prefill)也随之扩展;热启动TTFT则不然,因为缓存命中会完全跳过匹配部分的预填充。
以下为3,072个Token用例的原始记录,与测试框架记录的完全一致:
{"cold": {"ttft_s": 0.4615, "prompt_tokens": 3110, "cache_query_tokens": 3110, "cache_hit_tokens": 16},
 "warm": [
   {"ttft_s": 0.0389, "prompt_tokens": 3110, "cache_query_tokens": 3110, "cache_hit_tokens": 3104},
   {"ttft_s": 0.0384, "prompt_tokens": 3110, "cache_query_tokens": 3110, "cache_hit_tokens": 3104},
   {"ttft_s": 0.0383, "prompt_tokens": 3110, "cache_query_tokens": 3110, "cache_hit_tokens": 3104}]}
这张表中有两点值得注意。首先,冷启动TTFT随提示词大小线性增长,在此硬件和模型上大约每1,000个提示词token增加134毫秒,相当于约每秒7,500个token的预填充吞吐量。
这个斜率正是缓存所要消除的东西。其次,无论前缀大小如何,热启动TTFT都平稳地保持在37到39毫秒,因为命中会完全跳过匹配部分的预填充。稳定的前缀越长,命中的价值就越大,这实测证实了本文决策框架为何如此重视前缀大小。在3,110个token时92%的降幅处于OpenAI为其托管缓存宣传的“最高80%”范围的上限,这里的测量是在任何人都可以按小时租用的开源基础设施上完成的。
缓存token计数以16的倍数出现,因为vLLM以16个token为块缓存KV状态;每个热请求上少数未缓存的token是最后的非完整块。包含聊天模板头的块在该端点的所有请求之间共享,这就是为什么即使是“冷”请求也显示16个缓存token。
实测结果2:一个12轮agent会话在第一轮之后保持了98.7%的命中率
这就是本文前面的计算示例所模拟的工作负载:一个稳定的2,080 token系统提示词,然后是12轮累积的对话历史,每轮间隔一秒。
| 轮次 | 提示词token | 缓存token | TTFT |
|---|---|---|---|
| 第0轮(冷) | 2,084 | 16 | 327 ms |
| 第1轮 | 2,110 | 2,080 | 42 ms |
| 第2轮 | 2,136 | 2,112 | 43 ms |
| 第3轮 | 2,163 | 2,128 | 39 ms |
| … | … | … | … |
| 第11轮 | 2,372 | 2,336 | 38 ms |
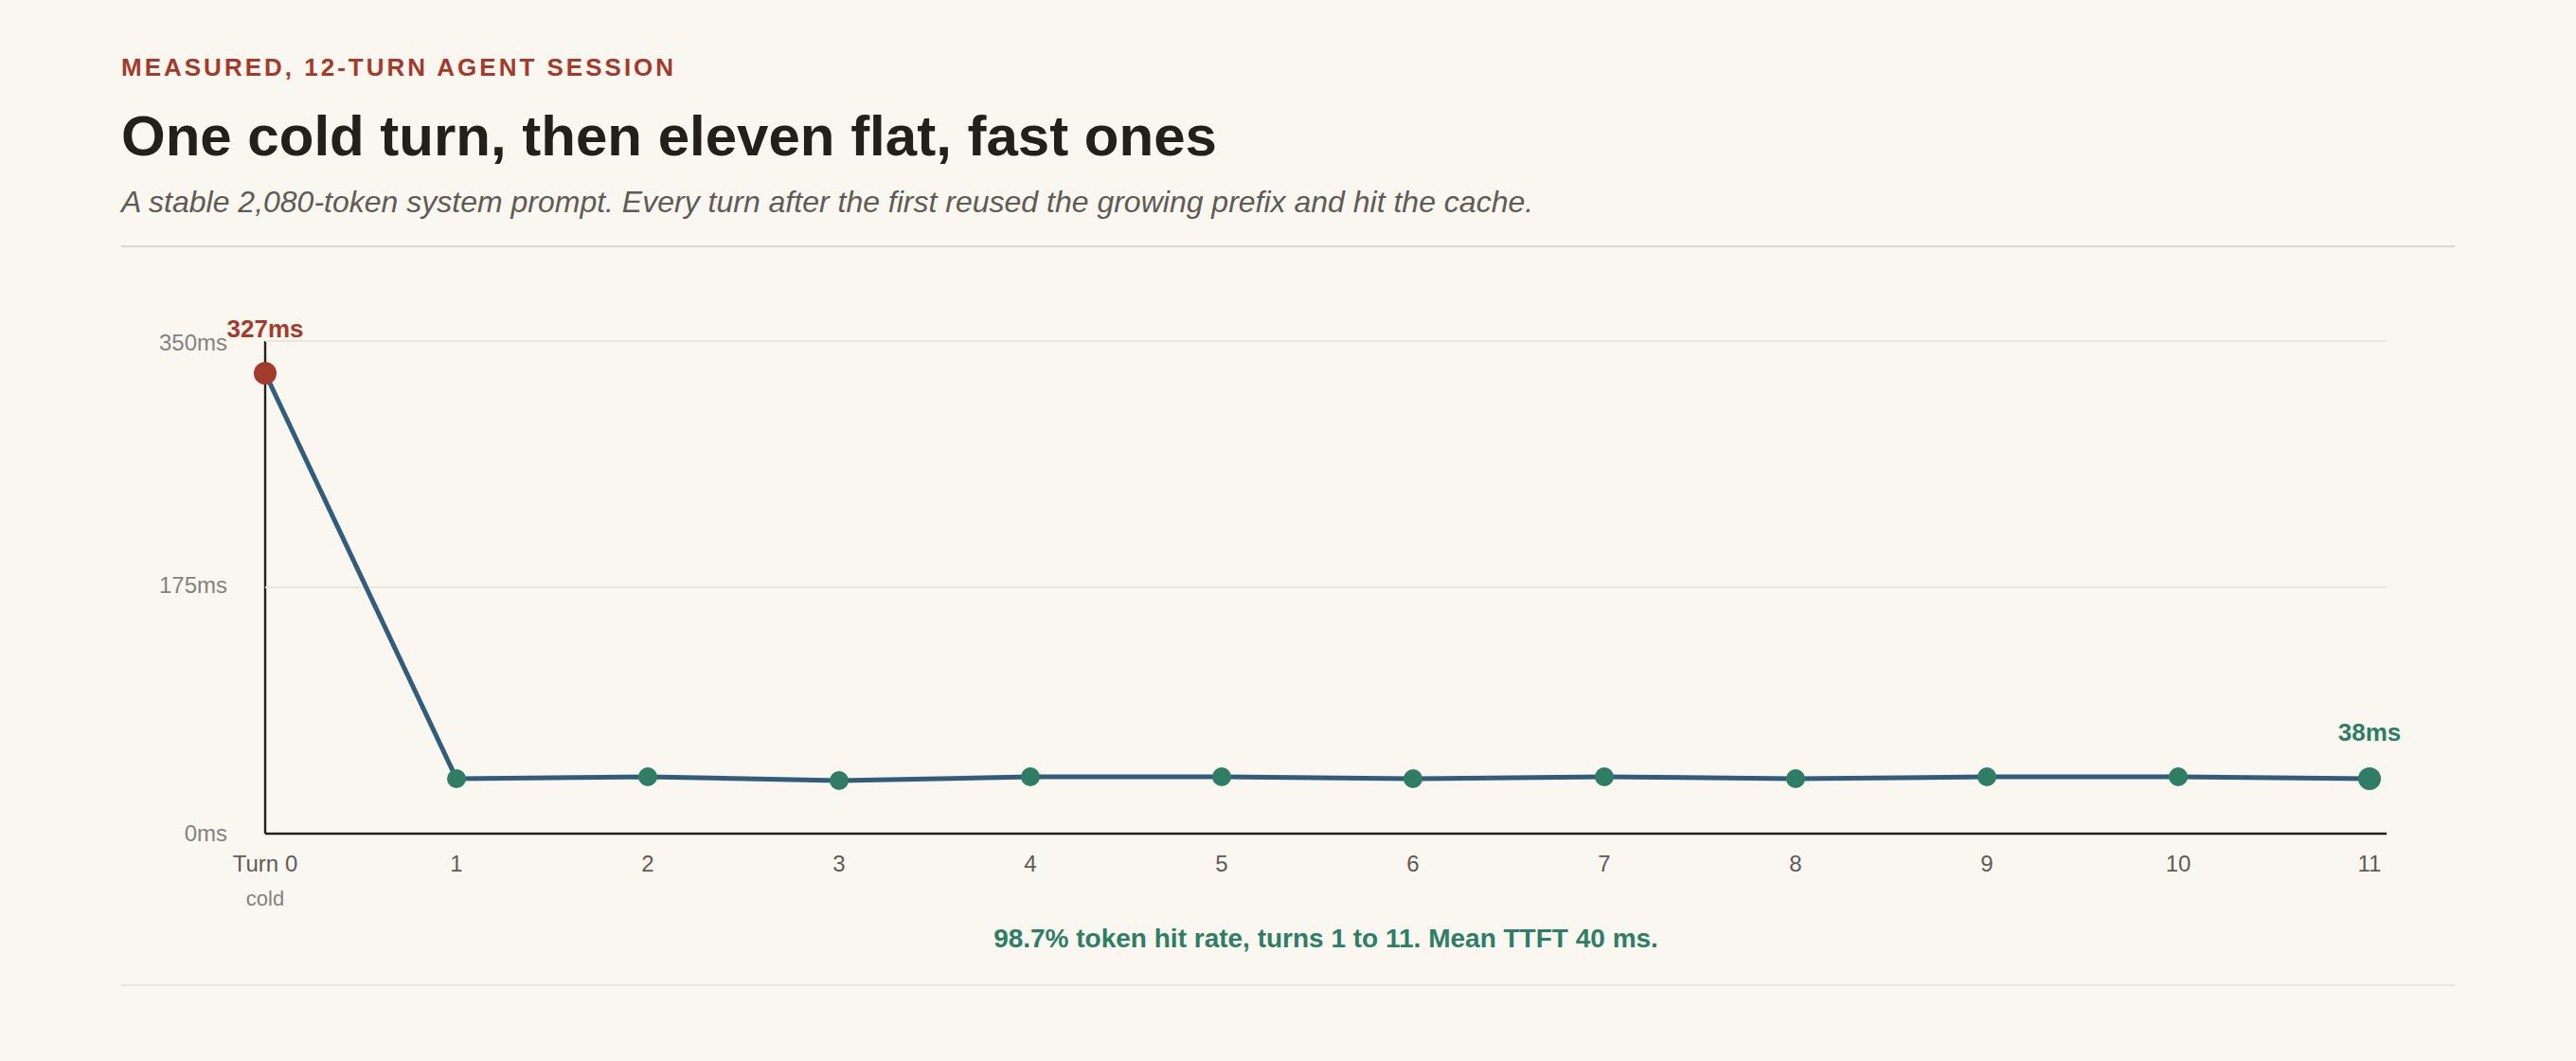 一次冷启动,然后是十一次平稳快速的轮次。每轮都扩展了上一轮的缓存前缀,因此命中率是复利式增长而不是重置。
前四轮和最后一轮的原始记录:
{"turn": 0, "prompt_tokens": 2084, "cache_query_tokens": 2084, "cache_hit_tokens": 16,   "ttft_s": 0.3267}
{"turn": 1, "prompt_tokens": 2110, "cache_query_tokens": 2110, "cache_hit_tokens": 2080, "ttft_s": 0.0416}
{"turn": 2, "prompt_tokens": 2136, "cache_query_tokens": 2136, "cache_hit_tokens": 2112, "ttft_s": 0.0425}
{"turn": 3, "prompt_tokens": 2163, "cache_query_tokens": 2163, "cache_hit_tokens": 2128, "ttft_s": 0.0394}
{"turn": 11, "prompt_tokens": 2372, "cache_query_tokens": 2372, "cache_hit_tokens": 2336, "ttft_s": 0.0377}
在第1轮到第11轮中,token级命中率为98.7%,平均TTFT为40毫秒,而冷启动的第一轮为327毫秒。注意第3轮时缓存的内容:不仅是系统提示,还有累积的对话历史,因为每一轮的提示都是上一轮提示的严格前缀扩展。这种仅追加(append-only)特性使代理循环成为缓存的最佳工作负载,这也是为什么前面示例中“第一轮之后每轮都命中”的模式在这里是测量结果,而非假设。
测量结果3:提示词顶部的一个时间戳将命中率从98.7%骤降至0.7%
同一个12轮会话,仅做一处修改后重新运行:每一轮的系统提示词在稳定的2,080-token块之前都以[request-id: 开头。
| 指标 | 稳定前缀 | 时间戳在前 |
|---|---|---|
| token命中率(第1-11轮) | 98.7% | 0.7% |
| 平均TTFT(第1-11轮) | 40 ms | 326 ms |
| 命中缓存的轮次 | 11/11 | 0/11 |
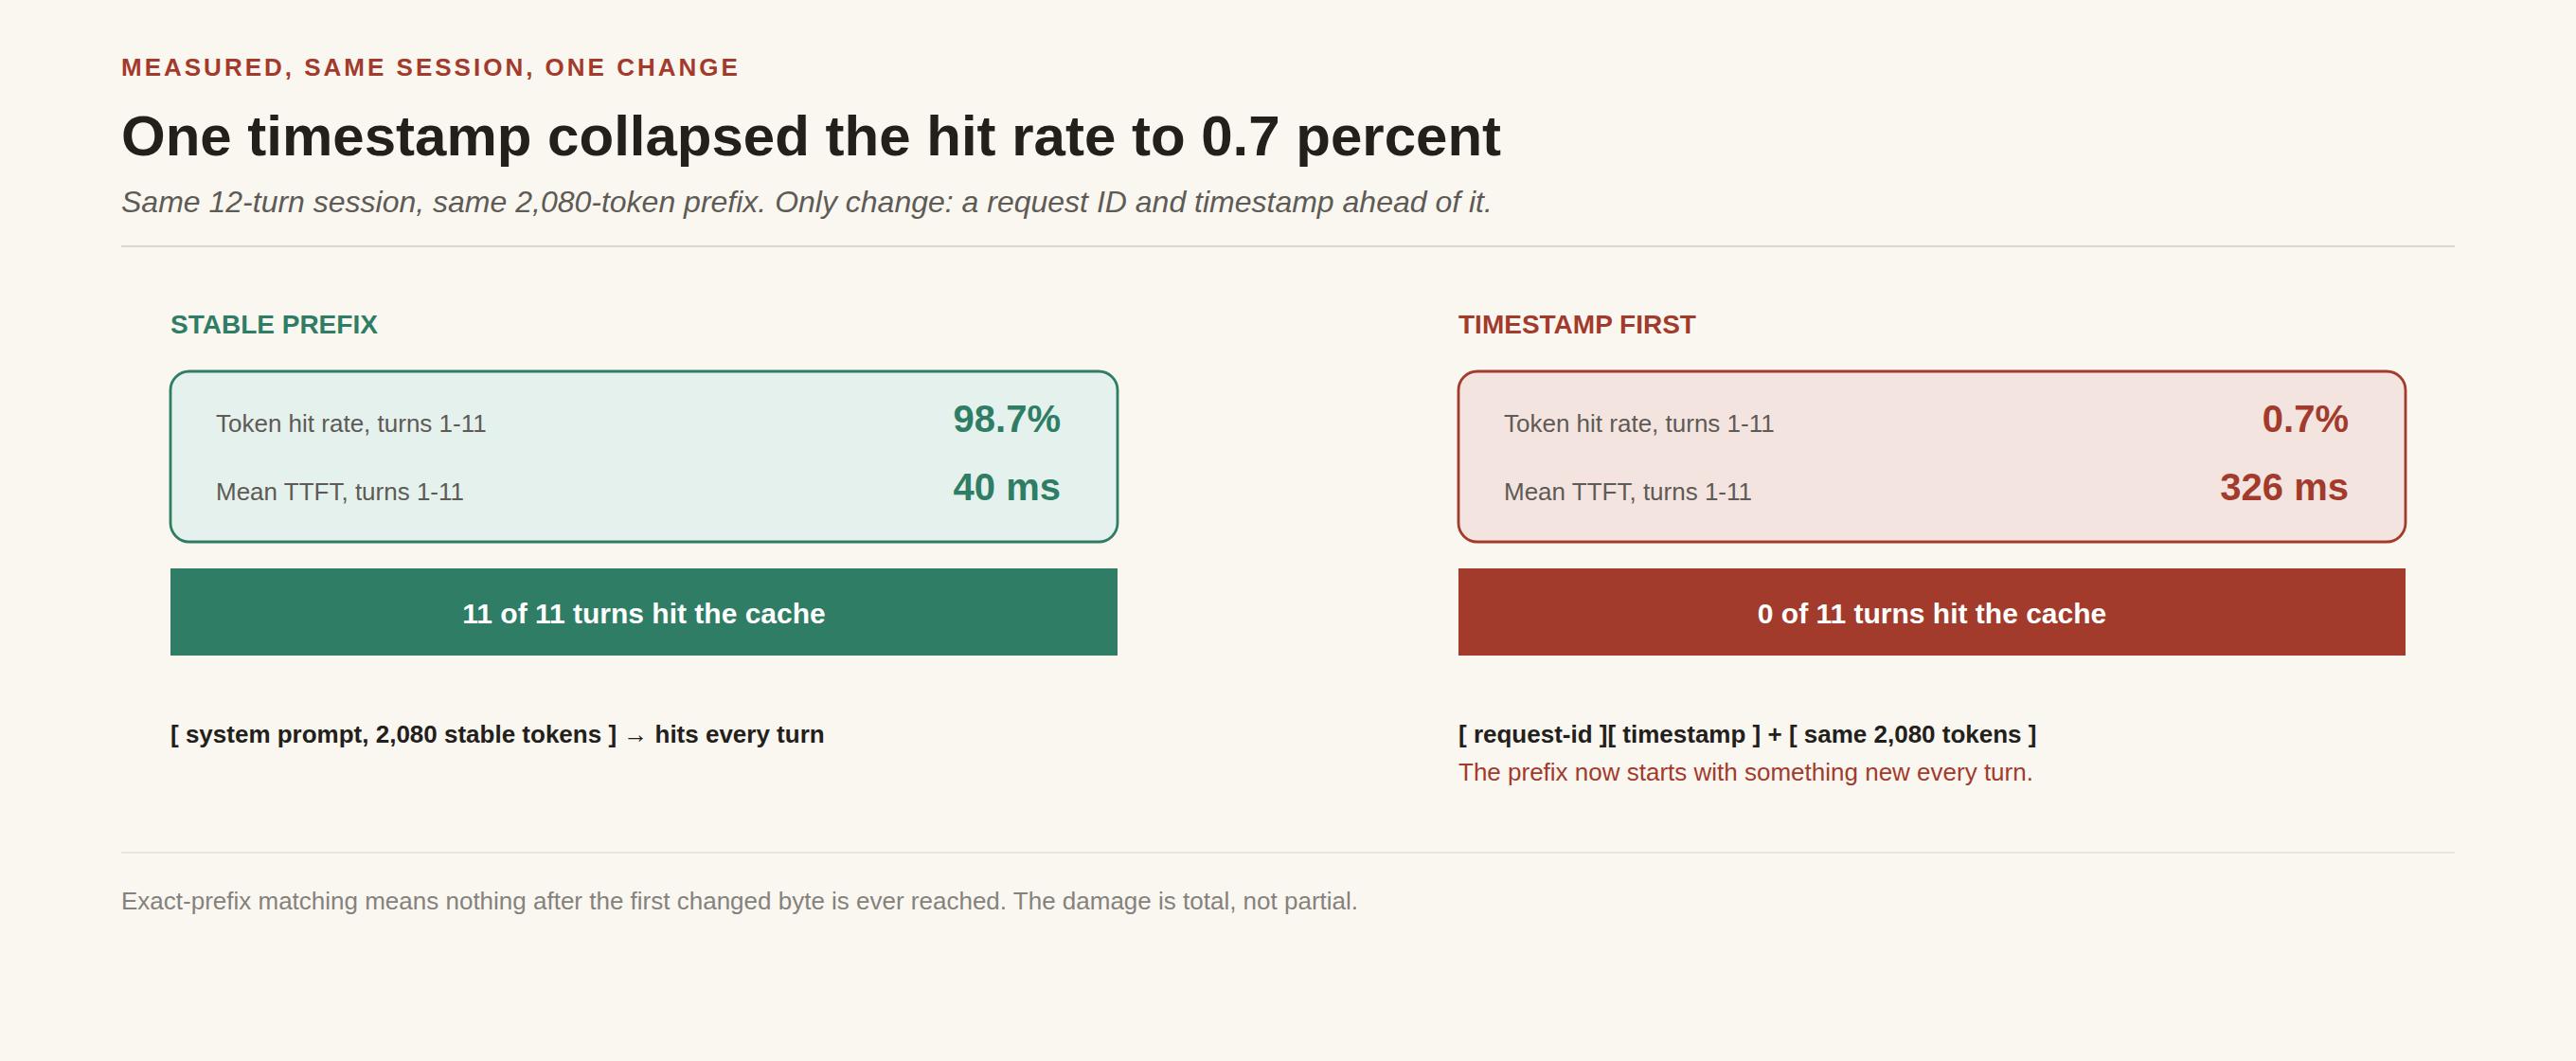 同一会话,同一个2,080-token稳定块,仅一处不同。精确前缀匹配意味着第一个改变字节之后的任何内容都永远不会被命中,因此损害是彻底的,而非部分的。
前四轮的原始记录,与上述稳定前缀记录并排对比。任何一轮中唯一被缓存的token是16-token的聊天模板块;时间戳后面的2,080-token稳定主体永远不会命中:
{"turn": 0, "prompt_tokens": 2122, "cache_query_tokens": 2122, "cache_hit_tokens": 16, "ttft_s": 0.3150}
{"turn": 1, "prompt_tokens": 2152, "cache_query_tokens": 2152, "cache_hit_tokens": 16, "ttft_s": 0.3137}
{"turn": 2, "prompt_tokens": 2176, "cache_query_tokens": 2176, "cache_hit_tokens": 16, "ttft_s": 0.3133}
{"turn": 3, "prompt_tokens": 2202, "cache_query_tokens": 2202, "cache_hit_tokens": 16, "ttft_s": 0.3048}
每一次请求都按完整预填充计费,约为热缓存TTFT的8倍,而在按token计费的提供商那里,每一次请求还要支付完整的输入费用。工作负载的会话深度、请求间隔或前缀大小都没有任何变化。缓存完全是被提示词结构击溃的,而且损失是彻底的、不是部分的,因为精确前缀匹配意味着在第一个改变的字节之后的东西永远不可能被命中。这是生产环境中最常见的缓存错误,而这就是它造成的影响。
测量结果4:1,024-token的最低门槛是商业模型策略,而非引擎限制
一个117-token的系统提示词,总提示词为155个token,远低于商业模型的最低门槛,重复四次:
| 请求 | 缓存token数 | TTFT |
|---|---|---|
| 1(冷启动) | 16 | 49 ms |
| 2 | 155中的144 | 37 ms |
| 3 | 155中的144 | 35 ms |
| 4 | 155中的144 | 37 ms |
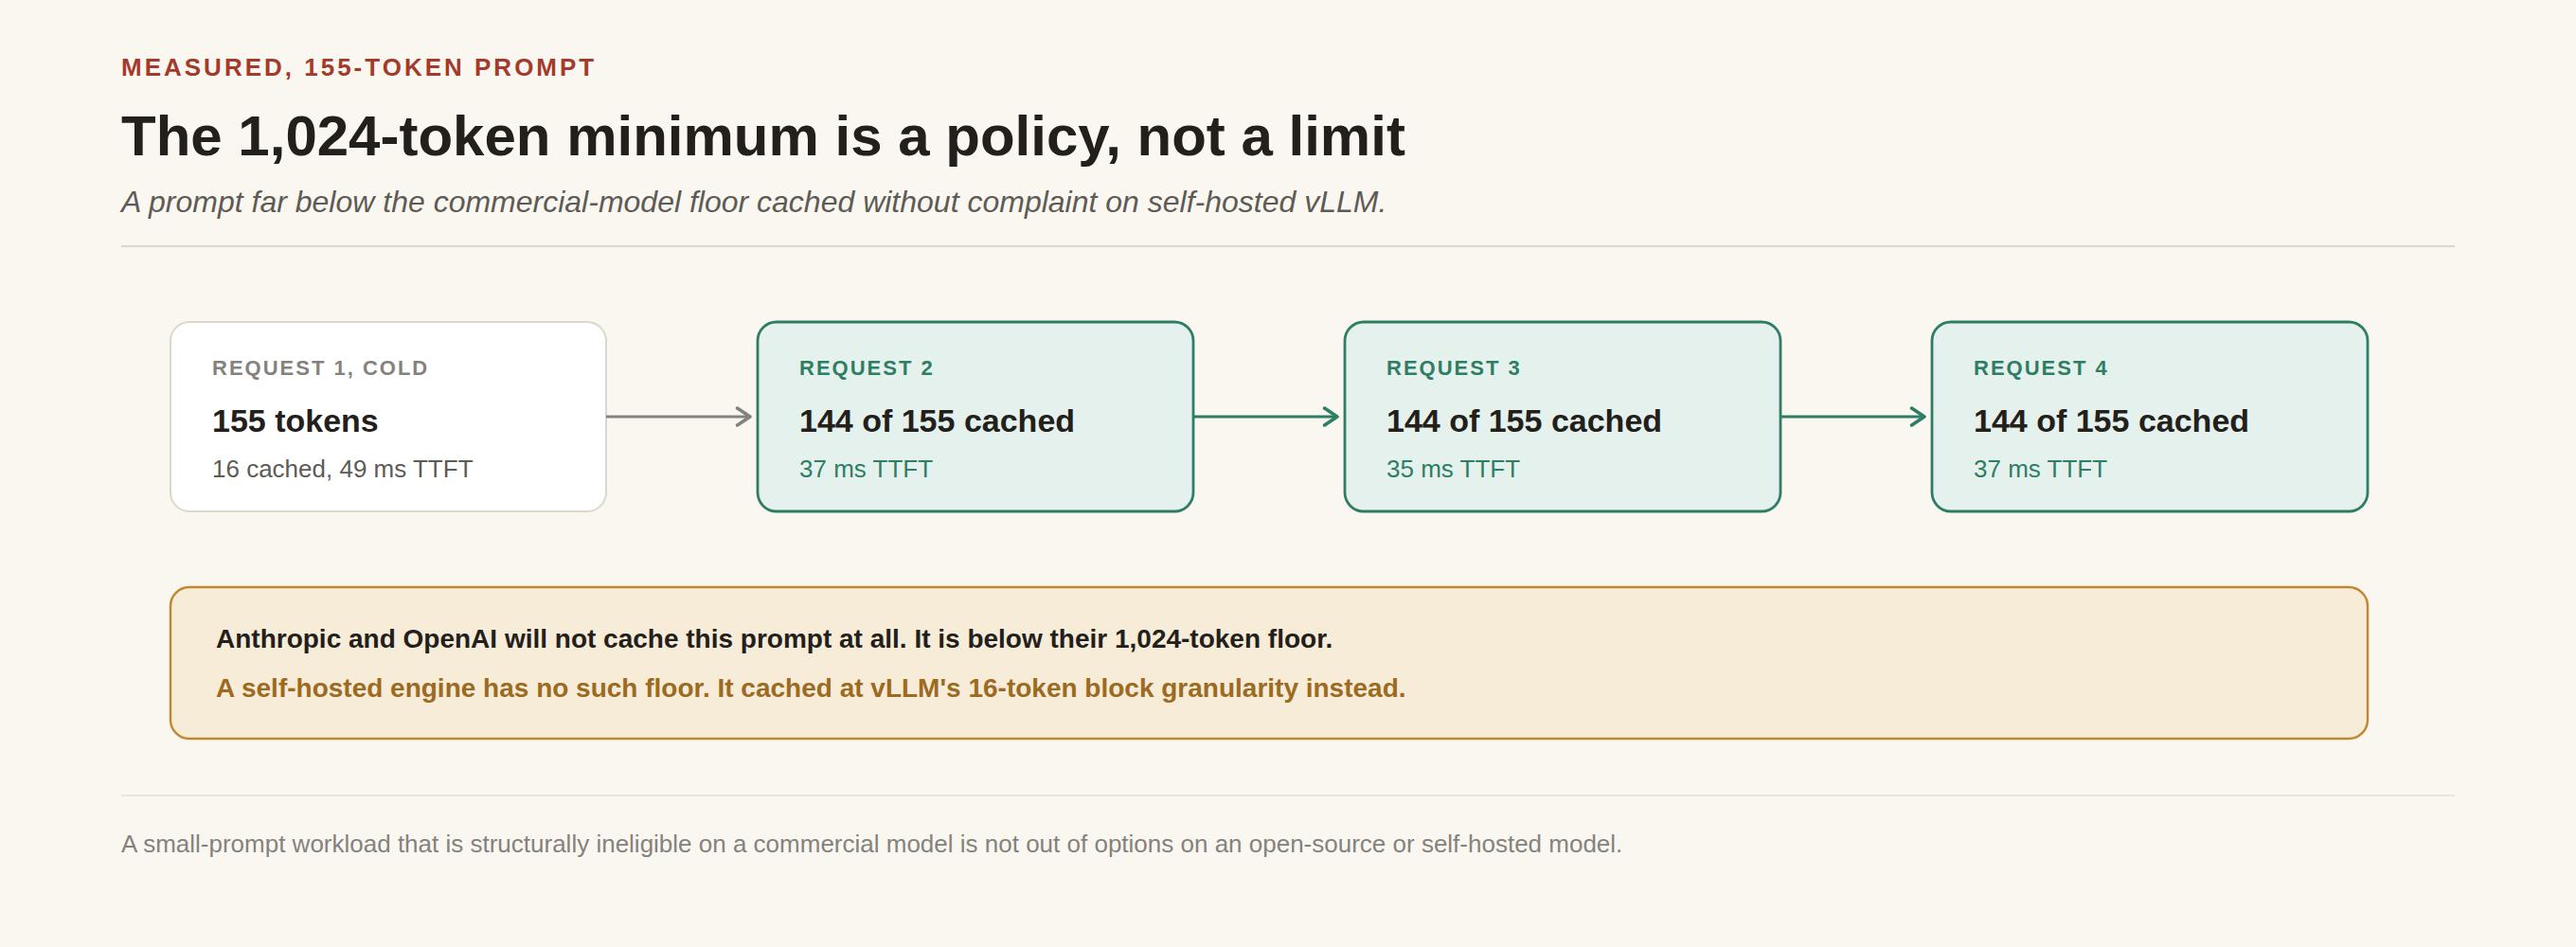 Anthropic和OpenAI根本不会缓存这种提示词,因为它低于它们1,024-token的下限。自托管引擎没有这样的下限,而是以vLLM的16-token块粒度缓存了它。
原始记录:
{"prompt_tokens": 155, "cache_query_tokens": 155, "cache_hit_tokens": 16,  "ttft_s": 0.0491}
{"prompt_tokens": 155, "cache_query_tokens": 155, "cache_hit_tokens": 144, "ttft_s": 0.0368}
{"prompt_tokens": 155, "cache_query_tokens": 155, "cache_hit_tokens": 144, "ttft_s": 0.0352}
{"prompt_tokens": 155, "cache_query_tokens": 155, "cache_hit_tokens": 144, "ttft_s": 0.0367}
vLLM毫无怨言地缓存了它,以16个token的块粒度。Anthropic和OpenAI模型强制要求的1,024个token最小值是一种策略选择,用于决定何时缓存值得进行簿记,而非机制本身的属性。DigitalOcean上有两条路径绕过了这个下限:其托管开源模型,文档显示在214个token时进行缓存;以及自托管引擎,如这里测量的,在155个token时缓存。因此,在Anthropic或OpenAI模型上结构性不合条件的小提示词工作负载并非没有选择;它只需要一个开源或自托管模型。这使之前的硬性限制从“完全不能缓存”变成了“无法在商业模型上缓存”。
测量数据对自托管基础设施成本的意义
在按token计费的服务商那里,缓存命中是一项逐项折扣。在按小时计费的GPU上,核算方式不同:无论缓存是否命中,H200每小时都花费3.44美元,因此节省体现为回收的容量。在测量到的约每秒7,500个token的冷预填充速率下,每百万个缓存提示词token约等于134个GPU秒的预填充工作,而卡不需要重复执行,这些GPU时间可用于处理其他请求的解码。对于延迟敏感的工作负载,更直接的解读是上面的TTFT表:首词时间462毫秒与39毫秒之间的差异,正是用户在完全控制缓存行为的基础设施上实际感受到的差异。
一旦你超出单块GPU的规模,一个重要的扩展注意事项是:这些命中率是在单个副本上测量的,所有请求都落在同一个缓存上。在N个副本之间进行轮询负载均衡时,相同前缀大约有N分之一的机会落到其缓存条目所在的位置,因此这里测量的命中率会相应下降。会话亲和路由(将会话的请求固定到一个副本)是标准的解决方案,DigitalOcean的《高级提示词缓存规模扩展》博客介绍了该架构、用于多任务部署的分层前缀路由,以及共享跨副本缓存何时值得其传输延迟。
针对无服务器推理运行相同测试
下面的DIY测试工具针对DigitalOcean托管的Serverless Inference端点,其中缓存出现在响应usage对象中,而不是在引擎指标中。这里的默认模型是deepseek-3.2,这是一个开源模型,根据DigitalOcean的文档,它会自动缓存,无需cache_control或prompt_cache_retention参数。对于开源和Anthropic模型,需要关注的字段是cache_read_input_tokens;开源模型还额外报告prompt_tokens_details.cached_tokens。对于OpenAI模型,设置prompt_cache_retention(显示为注释)并期望仅在1,024个或更多token的提示上进行缓存。来源:DigitalOcean提示缓存操作方法。
import time
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DO_MODEL_ACCESS_KEY"],
    base_url="https://inference.do-ai.run/v1",
)

STABLE_PREFIX = "..."  # your stable system prompt and tool definitions go here
MODEL = "deepseek-3.2"  # open-source model; caches automatically, no parameters needed


def cached_tokens(usage):
    """Read cached-token count across the fields DO populates per model family."""
    direct = getattr(usage, "cache_read_input_tokens", 0) or 0
    details = getattr(usage, "prompt_tokens_details", None)
    nested = getattr(details, "cached_tokens", 0) if details else 0
    return max(direct, nested or 0)


def run_turn(messages):
    start = time.perf_counter()
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        stream=False,
        # For OpenAI models, opt in to caching (1,024-token minimum applies):
        # extra_body={"prompt_cache_retention": "24h"},
    )
    elapsed = time.perf_counter() - start
    usage = response.usage
    return {
        "elapsed_seconds": elapsed,
        "prompt_tokens": usage.prompt_tokens,
        "cache_read_input_tokens": getattr(usage, "cache_read_input_tokens", 0),
        "cached_tokens": cached_tokens(usage),
    }


def agent_workload(turns=20, delay_seconds=2):
    history = [{"role": "system", "content": STABLE_PREFIX}]
    results = []
    for i in range(turns):
        history.append({"role": "user", "content": f"Turn {i}: continue the task."})
        result = run_turn(history)
        results.append(result)
        # capture the real assistant response so the prefix extends append-only:
        history.append({"role": "assistant", "content": "..."})
        time.sleep(delay_seconds)
    return results


def long_gap_workload(turns=5, delay_seconds=400):
    # For OpenAI models with prompt_cache_retention, a delay beyond the retention
    # window tests the interarrival failure mode. Open-source caches are unbounded
    # but best-effort, so a miss after a long gap is possible but not guaranteed.
    return agent_workload(turns=turns, delay_seconds=delay_seconds)


if __name__ == "__main__":
    print("Agent workload:")
    for r in agent_workload():
        print(r)
    print("Long-gap workload:")
    for r in long_gap_workload():
        print(r)
在上面的代码块中,将 MODEL 替换为 Anthropic 模型(并添加 cache_control 标记)或 OpenAI 模型(并取消注释 prompt_cache_retention),以在同一端点上比较不同模型家族的缓存机制。
决策框架
何时使用缓存:
- 你稳定、重复的内容超过模型的最低可缓存长度,Anthropic 和 OpenAI 模型为 1,024 个 token。DigitalOcean 上的开源模型和自托管引擎没有此最低限制。
- 你的会话深度超过了模型定价的盈亏平衡点
h*,在 Anthropic 的 5 分钟层级上为 1 次命中,在其 1 小时层级上为 2 次命中,而在任何无缓存写入费率的模型(大多数 OpenAI 模型和 DigitalOcean 上的所有开源模型)上实际为 0 次命中。 - 你的请求在彼此的缓存 TTL 内到达。对于 OpenAI 模型,你可以将
prompt_cache_retention设置为最长 24 小时;开源缓存没有上限,但为尽力而为。 - 你在运行具有固定工具定义和大型稳定上下文的智能体或编码工作负载,这种场景下会话深度和前缀大小同时对你有利。上面实测的 12 轮智能体会话正是在这些条件下保持了 98.7% 的 token 命中率。
- 你使用具有托管缓存费率的开源模型(DeepSeek V3.2、Qwen 3、GLM 等),缓存是自动的,无需任何参数;或者你在 GPU Droplet 上使用 vLLM 自行托管任何开放模型,前缀缓存默认开启,且没有最小前缀长度限制。
以下情况无需使用缓存:
- 你的提示词小于 1,024 个 token,并且你使用的是 Anthropic 或 OpenAI 模型。在这种情况下,无论多少会话深度或时机都无法解决这个问题,不过开源或自托管模型没有这样的下限。
- 你的会话足够浅,或者流量足够稀疏,以至于在缓存过期之前无法超过
h*,而使用的是收取缓存写入溢价的模型(Anthropic 和 GPT-5.6)。 - 你的提示词在每次请求中都会以破坏精确前缀匹配的方式变化,无论大小或频率如何,都会使该机制失效。
为缓存设计你的提示词:
将稳定内容放在前面,易变内容放在最后。按此顺序:系统提示词、固定工具定义、长静态参考资料、缓慢变化的对话历史,然后是当前用户消息。绝不要将时间戳、请求 ID 或任何每请求变量放在你想要缓存的内容之前,因为精确前缀匹配意味着第一次变化之后的任何内容永远不会被命中。
这个排序原则在我审阅的每个提供商的文档中都是一致的,也是在努力改善低命中率的团队的生产案例研究中最常见的单一实现错误。这也已不再只是本文中报告的错误:上面实测的破坏前缀测试运行在原本完全可缓存的会话顶部放了一行时间戳,结果命中率从 98.7% 下降到 0.7%。
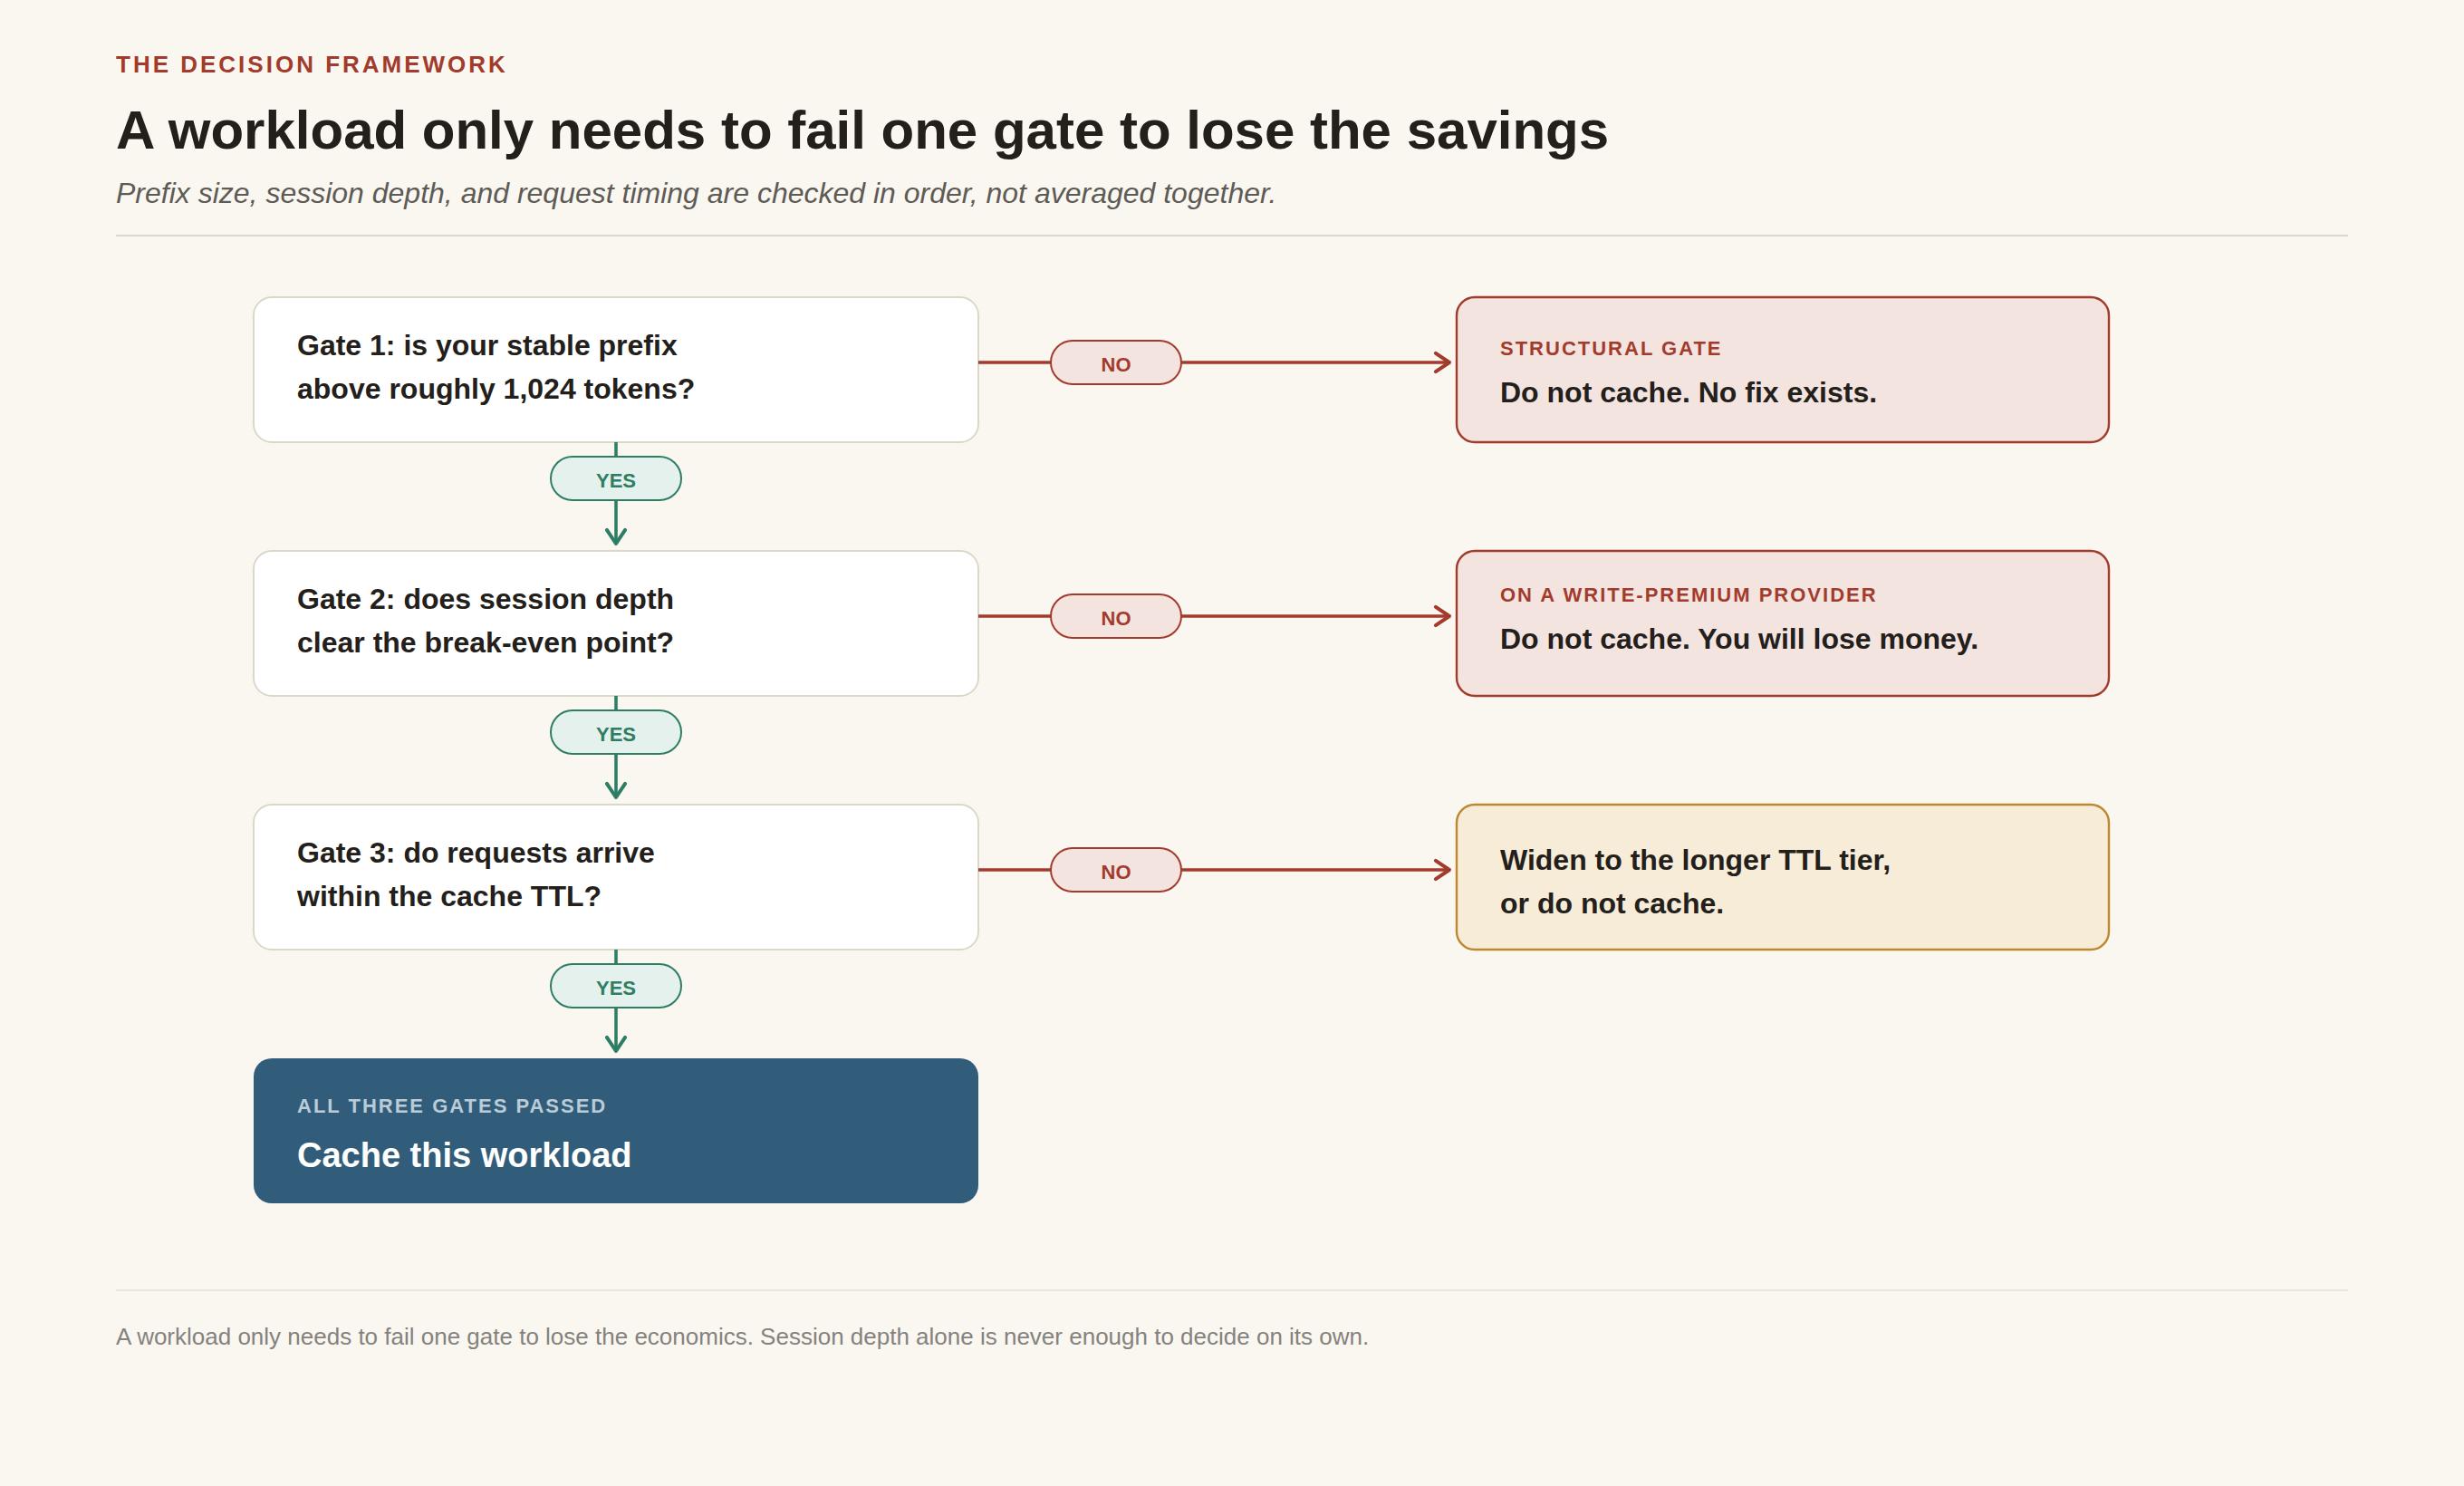 三个门,按顺序检查。一个工作负载只需失败一个就会失去经济效益,这就是为什么仅凭会话深度,而不检查前缀大小和时序,不足以做出决定。
提示缓存和模型路由是耦合的
如果您通过DigitalOcean的推理路由器而非单个固定模型来运行流量,有一个值得直接理解的机制交互,因为它可能悄然破坏本文所述的整个缓存经济效益。
路由器可以根据每个特定请求的样子,为会话中的每个请求选择不同的模型,这在混合工作负载中对于成本治理很有用。但提示缓存仅限于特定模型。如果您的代理第一轮路由到一个模型,第二轮路由到另一个模型,那么第一轮写入的缓存永远不会被第二轮读取,每一轮都支付完整的写入成本,没有累积节省,无论您的前缀和会话深度在其他方面多么符合上述盈亏平衡公式。
DigitalOcean的路由器提供了一个X-Model-Affinity头,专门用于防止这种情况。在第一个请求上将其设置为会话标识符,会使路由器正常路由一次,然后将具有相同标识符的每个后续请求固定到同一模型,跳过路由并保留缓存。根据DigitalOcean自己的文档,在一个15轮的代理循环中,如果90%的输入是缓存的、稳定的前缀,这种会话固定行为与输入令牌成本节省45%至80%相关。来源:DigitalOcean文档中的推理路由器使用指南。
实用规则:如果您路由,请固定。会话固定不是提示缓存的单独优化,而是一旦有多个模型参与,保持缓存经济性完整的机制。
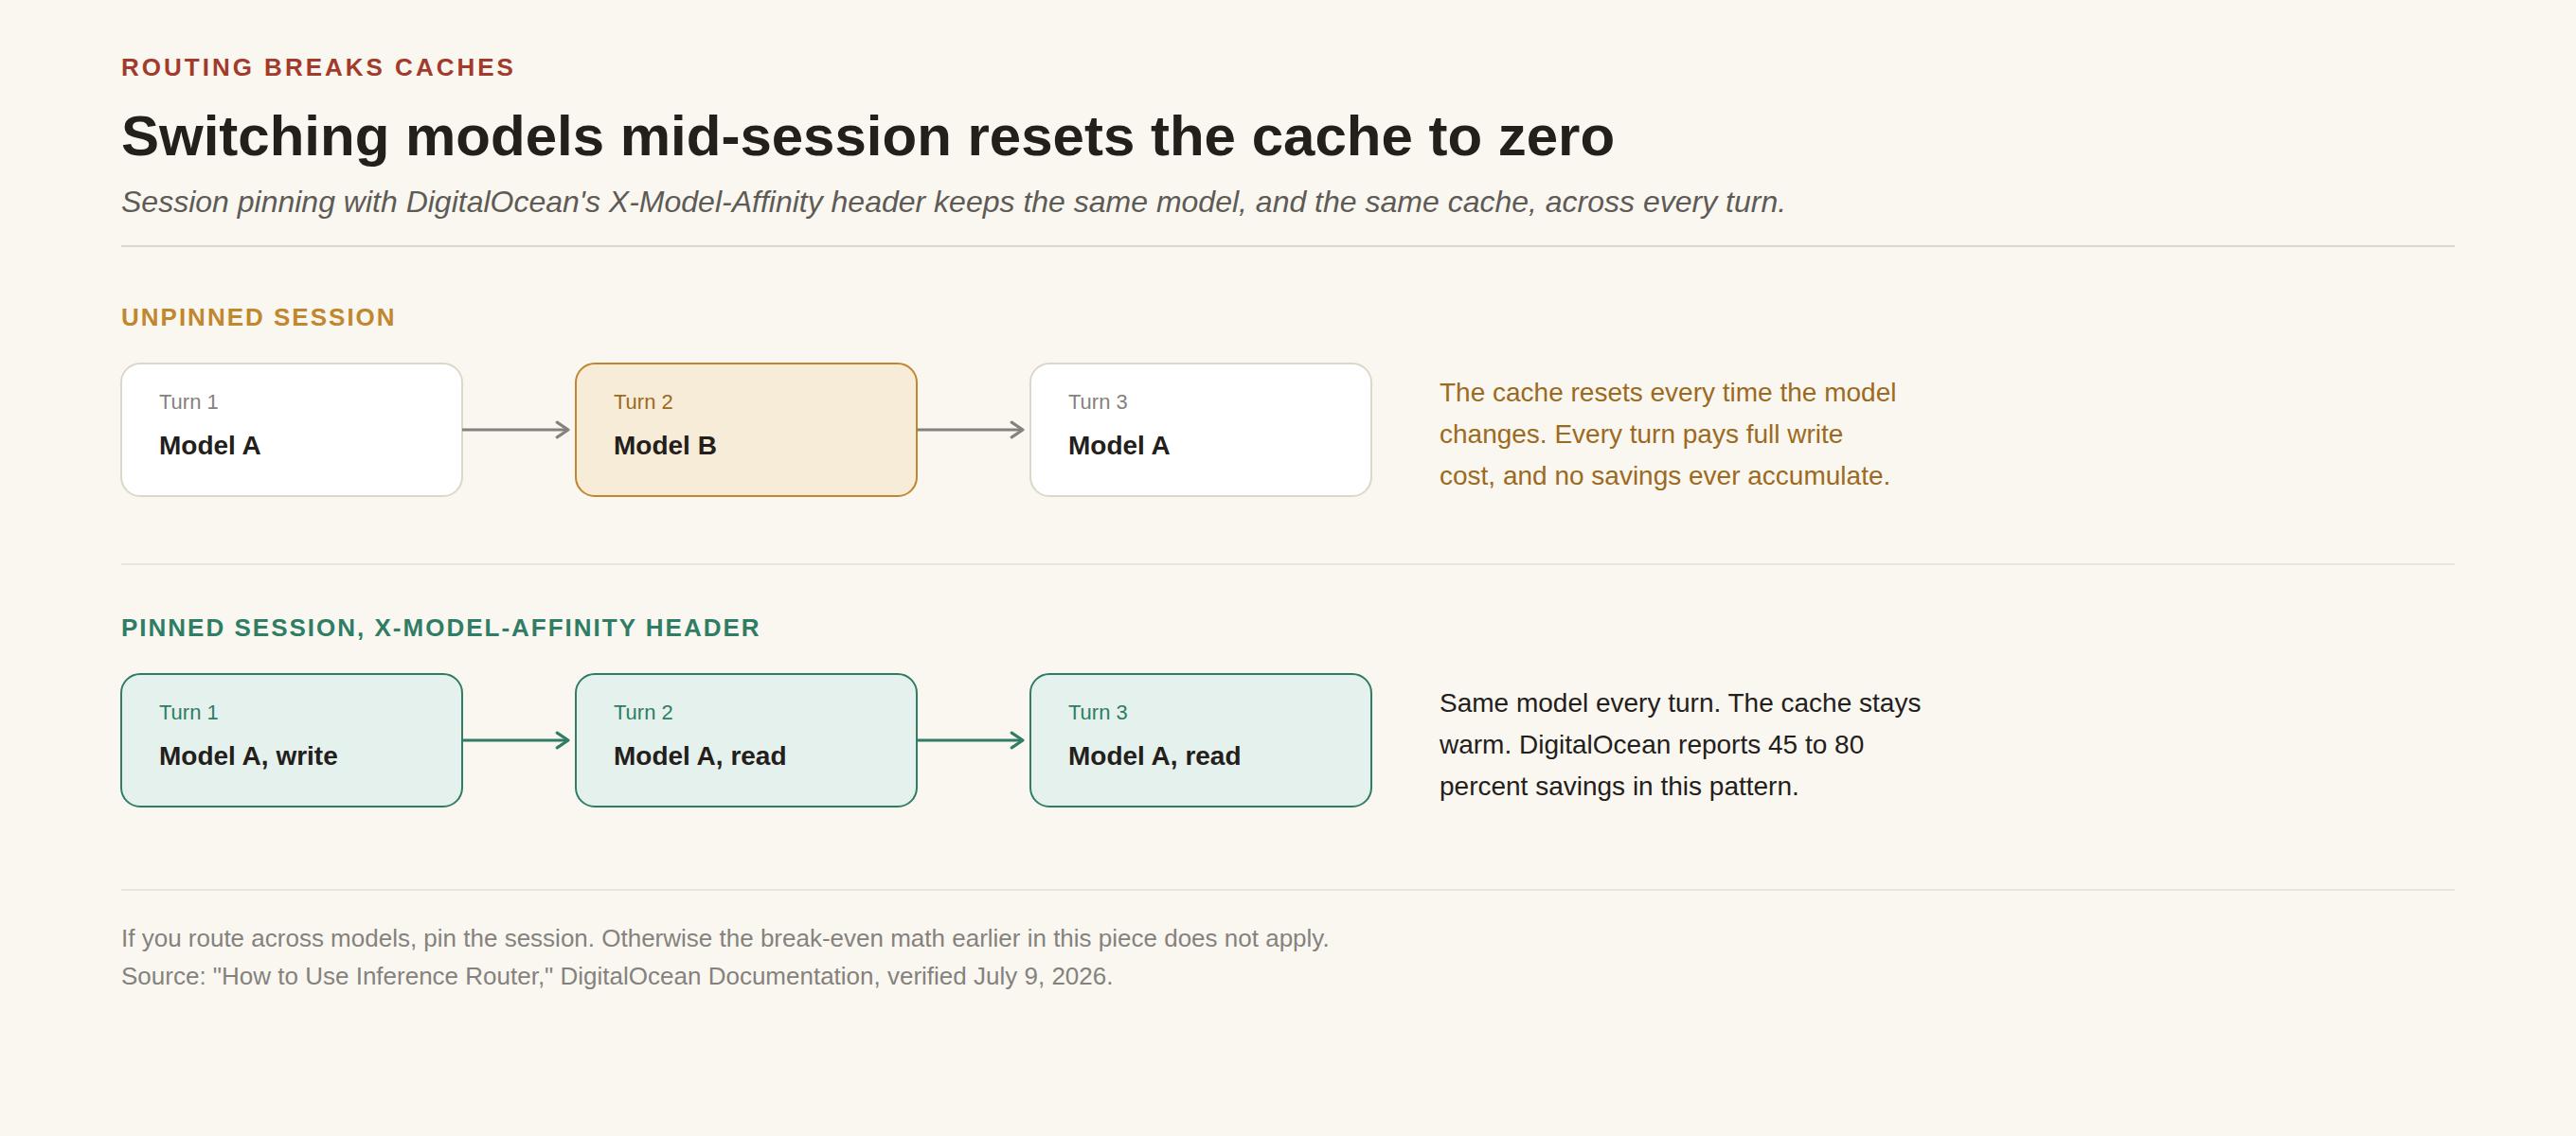 不固定的路由可能会彻底击败缓存,即使工作负载在其他方面通过了上述决策框架中的每个门。
关于此主题的常见问题?
1. 提示缓存会改变模型的输出吗?
不。缓存仅影响输入前缀在内部的处理方式。无论前缀是从缓存读取还是重新处理,生成响应的计算方式都相同,并且提供商表示输出不受是否发生缓存命中的影响。
2. 我可以将提示缓存与批处理结合以获得额外节省吗?
同时提供这两种功能的提供商处可以,并且据报道折扣是可叠加的。请在你的提供商的最新定价页面上确认当前组合费率,因为叠加折扣正是那种会随定价更新而变化的数据。
3. 较短的缓存TTL是否总是意味着较低的风险?
不,这意味着在缓存过期之前收集命中的窗口更窄,之后你必须重新写入。较短的TTL适合间隔紧密、高频率的流量。较长的TTL适合稀疏但仍在一小时内重复的流量,代价是更高的写入溢价和更高的盈亏平衡点,正如本文公式所直接展示的那样。
4. 为什么我测得的命中率与提供商宣传的折扣百分比不一致?
宣传的百分比描述的是成功缓存读取时的折扣。你在整个工作负载中的实际节省取决于你的总请求中有多少比例真正命中,这取决于你的流量特性,而不是提供商的定价表。这正是本文以公式和测试工具而不是百分比开头的全部原因。
5. 开源模型是否支持DigitalOcean无服务器推理中的提示缓存?
是的。根据DigitalOcean的文档,开源模型的提示缓存目前处于公开预览阶段,DeepSeek V3.2、Qwen 3系列和GLM等模型会自动进行缓存,无需cache_control或prompt_cache_retention参数。缓存按账户隔离,没有1,024个token的最低限制,缓存token按折扣读取费率计费(根据模型不同,大约比输入价格优惠46%到80%),且不收取写入附加费。不过,并非每个开源模型都提供托管缓存费率;请查看基础模型列表。
6. 如果我的开源模型没有托管缓存费率怎么办?
自行托管。vLLM、SGLang和TensorRT-LLM都支持副本内的自动前缀缓存,而vLLM默认启用该功能。本文中的实测运行证实了它在DigitalOcean GPU Droplet上无需任何配置即可工作,无需写入附加费,也没有最小前缀长度限制,包括在155个token的提示词上,使用Llama 3.3 70B——这是没有托管无服务器缓存费率的模型之一。代价是您需要自行运维服务栈,并且无论是否有流量,都需要按小时支付GPU费用。
7. 当我扩展到多个副本时,这里测得的命中率仍然成立吗?
并非自动成立。这些数字来自单个副本,其中每个请求都看到相同的缓存。在N个副本之间的轮询负载均衡下,相同前缀命中持有其缓存条目的副本的概率大约为1/N。会话亲和性路由可以恢复大部分收益,DigitalOcean的大规模高级提示缓存一文详细介绍了多副本架构。
8. 如何检查我的请求是否真的命中了缓存?
在DigitalOcean的无服务器推理服务上,读取每个响应中的usage对象:非零的cache_read_input_tokens确认命中,开源模型还会报告prompt_tokens_details.cached_tokens。在自托管的vLLM上,每请求的usage对象不报告缓存token,但/metrics端点暴露了vllm:prefix_cache_queries_total和vllm:prefix_cache_hits_total,对这些计数器在串行请求周围进行差分可以精确归因命中,这正是本文中的测试工具测量它们的方式。
结论
提示缓存是一项工作负载决策。决定它的三个变量——前缀稳定性、会话深度和到达间隔时间——都是可测量的,本文为你提供了公式,可将前两者与任何服务商公布的价格进行核对,还提供了一个测试工具,可根据你自己的真实流量测量第三个变量,以及该测试工具的一次完整运行:在一个运行Llama 3.3 70B的H200 GPU Droplet上,稳定的前缀获得了98.7%的命中率,并将TTFT降低了92%,而提示顶部的一个时间戳几乎抵消了所有这些优势。
缓存专门解决输入token成本问题。它对输出token成本没有影响,后者需要单独的控制,并在关于输出定价的配套文章中进行了介绍。如果你跨多个模型路由请求,通过DigitalOcean的Inference Router进行会话固定,是在路由会话期间保持缓存热度的机制,这两个系统应被视为耦合而非分离的,正如本文的会话固定部分所述。
在你的流量形态上运行该测试工具。你的实测命中率,而不是任何供应商宣传的百分比,甚至不是本文测得的数字,才是决定缓存对你是否划算的依据。
参考资料
DigitalOcean文档和工程内容
- 在Chat Completions和Responses API中使用提示缓存
- 大规模高级提示缓存(DigitalOcean工程博客)
- Inference功能参考
- Inference定价
- 基础模型(哪些模型支持提示缓存)
- Serverless Inference API参考
- 如何使用Inference Router
- 使用Inference Router进行多模型API成本治理
- DigitalOcean Serverless Inference:深度解析
- Serverless架构上的微调LLM
- 在哪里托管你的开源模型(100亿参数以下)
- DigitalOcean推理引擎的新变化
提供商主要来源
- Anthropic:提示缓存文档
- Anthropic:价格文档
- OpenAI:API中的提示缓存(公告)
- OpenAI:提示缓存201手册
- OpenAI:提示缓存指南
- Google:上下文缓存,Gemini API文档



