团队59.1%不如一个61.7%的好评审
热榜上那条 "Your AI said 'fixed' but never ran the tests? I made a plugin that won't let it say 'done'" 底下,有人提了个方案:一个 agent 会撒谎,那就挂三个、挂五个,让它们投票。我看到这条评论的第一反应不是佩服,是烦。因为我一直没想明白一件事——投票到底是在放大正确率,还是只是在平均偏见?如果五个 agent 里三个是弱的,投出来的"多数"凭什么比那个唯一靠谱的更强?
这个问题不能靠感觉回答。我做了个两百行的概率模拟,跑了 2000 轮,专门盯着一个场景:评审团里能力不齐的时候,多数投票会发生什么。结果是 59.1% 对 61.7%——101 人的团队,输给了单独一个好评审,差 2.6 个百分点。下面是完整的复盘。
热榜上那句"多上几个投票"让我不服
那篇插件文章本身没问题,它解决的是"AI 没跑测试就说 done"。问题出在评论区延伸出来的工程直觉:可靠性不够,就堆数量,靠多数投票压住噪声。这个直觉有它的道理,我承认。如果所有评审水平一样、而且都比抛硬币强一点点,人越多确实越准——这一条我在实验里也验证了,n=1001 的时候团队准确率能到 73.5%。
但我见到的真实评审团从来不是齐平的。代码审查里有一个非常懂这块的人,旁边跟三个只看了两眼的人;标注任务里有一个认真标了两小时的,剩下的在摸鱼。这种结构下再套多数投票,等于把"更准的那一方"的票,跟"更不准的那一方"的票,一票一票地等价相加。我甚至怀疑不用等到势均力敌,只要弱的那边多一个人,结果就直接翻过去。
所以这个实验的设计目标很明确:不是证明多数投票有效(它当然有效),而是找它的崩点在哪——能力分裂到什么程度、人数差距拉到一个什么比例,团队就开始比单个好成员还差。这个临界点,凭嘴说是说不清的,得让随机数去跑。
实验设计与代码
模型很简单:每个评审有一个独立正确概率 p,每轮每人各自按 p 掷一次骰子,票多的一方算赢,平票时抛硬币。跑 2000 轮取准确率百分比。我特意让每个人的判断完全独立——这是模型里最强的假设,后面我会回头说它的问题。
第一组测人数效应,所有人 p 都一样,看 n 从 1 涨到 1001 会发生什么。第二组才是重点:50 个 p=0.60 的好评审,加上 51 个 p=0.42 的弱评审,一共 101 人,平均能力 50.9%——整体看只比抛硬币强不到一个点。然后拿这个混合团队,去对比单独一个 p=0.60 的评审。
import random
random.seed(42)

TRIALS = 2000


def team_rate(probs):
    # simulate one panel of voters, return majority-vote accuracy in percent
    wins = 0
    n = len(probs)
    for _ in range(TRIALS):
        yes = 0
        for p in probs:
            if random.random() < p:
                yes += 1
        if yes * 2 > n:
            wins += 1
        elif yes * 2 == n and random.random() < 0.5:
            wins += 1
    return 100.0 * wins / TRIALS


print('Jury voting simulation: 2000 trials, n voters, majority wins')
print('-' * 66)
for n in (1, 11, 101, 1001):
    print('  n=%4d  all p=0.51    team accuracy = %5.1f%%'
          % (n, team_rate([0.51] * n)))
print('  n= 101  all p=0.55    team accuracy = %5.1f%%'
      % team_rate([0.55] * 101))
print('-' * 66)
good, weak = [0.60] * 50, [0.42] * 51
mix = team_rate(good + weak)
one = team_rate([0.60])
print('Mixed: 50 voters p=0.60 + 51 voters p=0.42, n=101, mean 50.9%')
print('  single good voter    = %5.1f%%' % one)
print('  full mixed panel     = %5.1f%%' % mix)
print('-' * 66)
print('Verdict: %.1f pts worse than one good voter; the weak half wins'
      % (one - mix))
写这段的时候我改过一版:本来想按"能力加权"再算一遍,被我砍掉了。因为我想先看清楚最朴素的多数投票能烂到什么程度。如果连基线都站不住,加权什么的都是后话。
真实运行结果
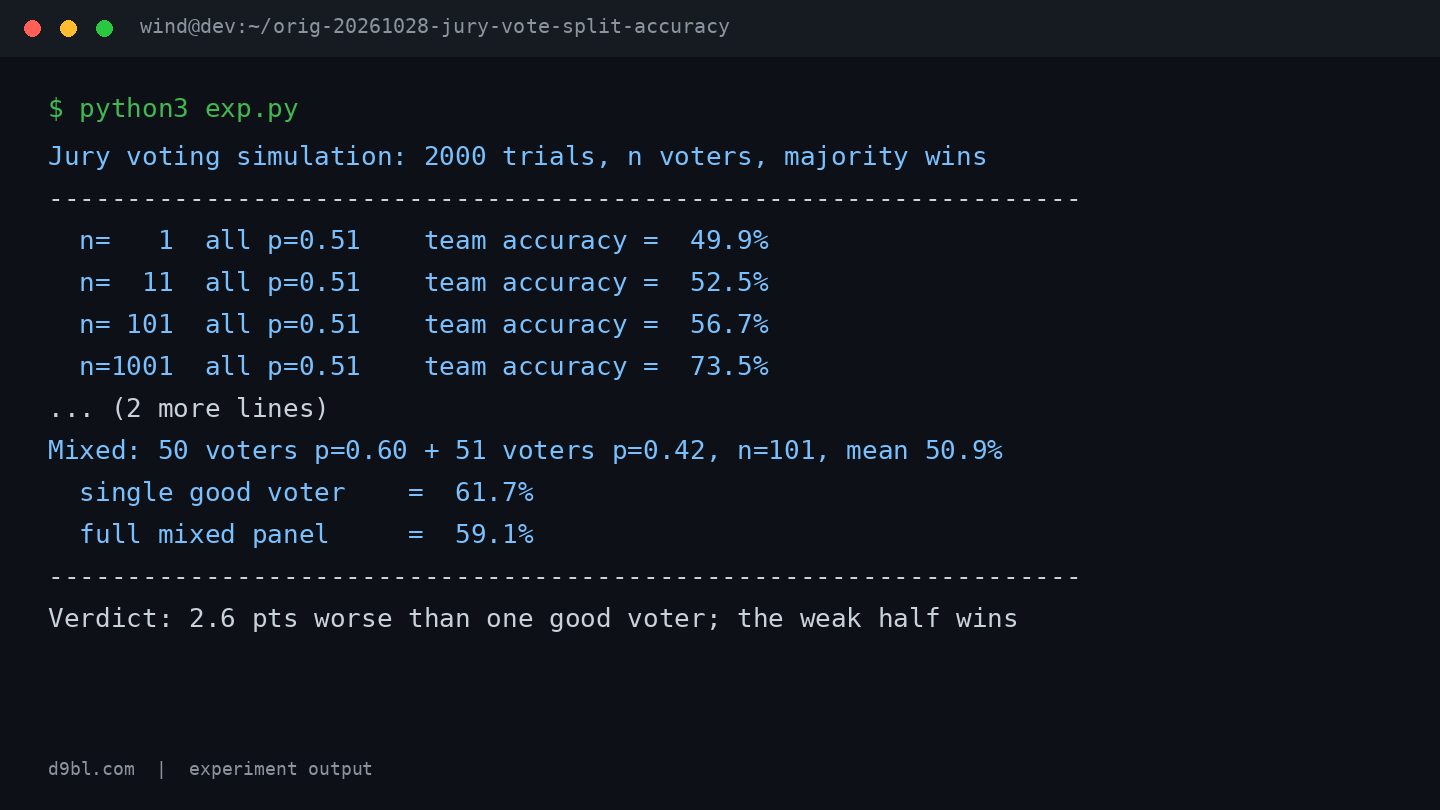
人数效应这一组没给我惊喜,但把规模写得很清楚。p=0.51,n=1 跑出 49.9%,n=11 是 52.5%,n=101 是 56.7%,n=1001 直接跳到 73.5%。能力只比抛硬币高一个点,凑够一千人就能有七成三的准确率。把单人能力提到 p=0.55、n=101,准确率是 86.0%。同样是 101 个人,个体只强了 4 个点,团队成绩能从 56.7% 拉到 86.0%——多数投票对"个体略优于随机"这件事的放大是极其陡峭的。
然后是分裂的那一组。50 个 p=0.60 配 51 个 p=0.42,面板平均 50.9%,跑出来团队准确率 59.1%。同一个随机种子下,单独一个 p=0.60 的评审是 61.7%。Verdict 那行打印出来的原话是:比一个好评审差 2.6 个百分点,弱的那一半赢了。
注意这 2.6 点是怎么来的。平均能力 50.9% 的面板,如果改成"随机抽一个人来拍板",期望准确率就是 50.9%——这个数字脚本里也印了。多数投票把它拉到了 59.1%,提升了 8.2 个点,机制本身在工作,而且工作得不错。但它拉到的位置,仍然低于那个 61.7% 的个体。多出来的一百个人、翻倍的沟通成本,换来的是一个更差的结果。
反直觉发现与局限
第一个反直觉的地方是那个 49.9%。理论上 p=0.51 的单人准确率就该是 51%,脚本跑出 49.9%。这不是 bug,是 2000 次试验的采样噪声——标准误大概 1.1 个百分点,恰好落在一个标准差以内。我把它留着没改,因为它提醒我:这篇文里所有个位数百分点的差距,都还在噪声的边缘上。59.1 和 61.7 差 2.6 点,方向可信(弱评审占多数会拖后腿),但精确到小数点的排序,重跑一次种子可能就会动。
第二个反直觉的地方更硬:只有一个人数差。50 对 51,弱的那边只多一个,局面就整个翻过去。我原本以为要弱方多出十几个才会有明显塌陷,实际上多数投票的阈值就卡在 50% 这条线上,谁过半谁说了算,和能力没有任何关系。50 个 60% 的人加起来,也压不住 51 个 42% 的人的合力。
局限也很明显,而且是我这个模型最不敢碰的部分:所有人都被假设成独立判断。真实的评审会互相看、会互相说服、会跟着组长走。一旦相关性起来,101 个人很可能退化成一两个人的意见重复 101 遍,多数投票的放大效应立刻打折。另外我这里只测了 p=0.60 和 p=0.42 这一种配比,人数比例也只试了 50/51,没有扫参数空间。换成 60 好 41 弱,结论可能就反过来了——那才是真正该画出来的相图,我还没画。
我的结论
结论落到工程上只有一句话:多数投票的收益来自"个体都略优于随机",不来自"人多"。它的前提是能力齐平,一旦分裂,它就不再做加权平均,而是直接执行人数多数决。你的评审团里只要有一半以上的人水平低于中位线,加人就是在稀释那个真正懂的评审。做代码审查、做标注验收、做 agent 输出仲裁,都是同一个道理。
可执行的做法是先把人分层再投票:能力明显低于均值的成员,与其让他拉低整个多数,不如把他挪出决策圈——哪怕团队从 101 人缩到 50 人。如果你想自己验证这个临界点,把上面代码里的 good, weak = [0.60] * 50, [0.42] * 51 那行改成人数的比例,比如 70 对 31,然后看 mix 会不会反超 one。这个实验我还没跑完,但我知道答案会落在 50% 那条线上,而不是落在能力上。