我用LLM描述了1,245张表格,检索效果变差
目录化步骤本来应该是易得的胜利。你有一个模式,其表名为 ecm_template_link 和 v_pmpm,用户用英语提问,而这两套词汇之间的差距导致了检索失误。于是你让模型逐个表进行指向,得到每个表的一句描述,并将这些描述与表名一起建立索引,此时语料库也会说英语了。 我曾在一个真实的 1,245

Nexpath 评测:AI 提示质量层能否让 AI 编程更安全?
AI 编程工具让从想法到可运行代码变得轻松。 你描述想要的功能,发送提示,几分钟后就能得到文件、组件、逻辑,有时甚至是一个完整的可运行应用。 这种速度很棒,直到提示遗漏了某些重要内容。 也许需求过于模糊。也许没人说明该功能该如何验证。也许现有行为需要保持不变。也许改动听起来很小,但却容易忽视的后果。

Qwen 3.8 在笔记本上能否真正取代 Claude Opus 进行 Agentic 编码?
原文发布于 deepu.tech 。 AI 编程热潮刚兴起时,我仍持怀疑态度。和大多数技术爱好者一样,我尝试过,但当时对模型的编码能力并不印象深刻。我仍然在使用它们,但主要只是 VS Code 的自动补全工具。一切在我使用 Claude Code 的 Opus 4.6 时改变了。那是我第一次感觉到模
我用 100 个线程跑了一场秒杀,没等来超卖,等来了更阴险的东西
100 线程秒杀实测:1500 次请求全部成功、库存一分没超卖、账面却剩 793 件。比超卖更阴险的丢失更新,以及为什么单元测试全绿也发现不了。
测试挂了不用喊人:我给 CI 装了个会自己修 bug 的循环,AI 修完我还得改回来一处
搭一个测试挂了自动喂给大模型、拿 patch 重跑的最小自愈闭环。AI 一次修对公式 bug、保住审批规则,但顺手删了金额舍入——测试全绿不等于修复正确。
AI Agent 拆开看就是 if 语句?我写了个对照实验,发现真正的问题在别处
同一个客服任务,if/else 版和大模型版对照实测:常规消息打平,长尾消息 0% 处理率对比全部接住——但 LLM 赢得并不干净。
克劳德代码时代的自助创业:AI悄然颠覆旧版创业手册
我想讲讲两位创始人的故事,因为我觉得他们的故事能比任何统计数据说得更清楚这个整体转变。 第一位创始人花了四个月时间做 pitch deck。她反复修改幻灯片,次数多到自己都数不清,两次飞往旧金山,参加了十一场投资者会议,感觉都差不多,收到了一堆“我们再聊聊”的邮件,却始终没有后续。终于有一位投资者点
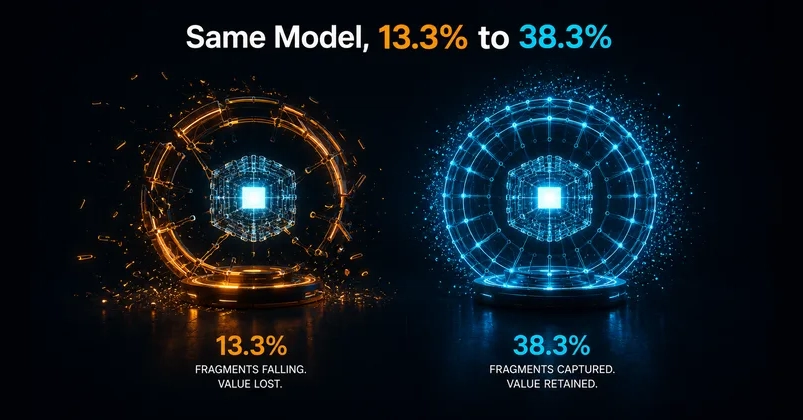
相同模型,13.3%至38.3%
两种 API 配置。模型相同。基准相同。任务集相同。 从 13.3% 提升至 38.3%,仅使用原来六分之一的输出 token。 OpenAI 在 ARC-AGI-3 上发布了关于 GPT-5.6 Sol 的这一结果,这是该领域在过去一年里我一直从第一性原理讨论的问题上所能产生的最干净的自然实验。模
从AI解决方案到知识共享:为社区构建MCP
这是一份针对 周末挑战:慷慨版 的提交 别只问 AI,把答案分享出来。 AI 是软件开发的真正倍增器,也是快速解决技术问题的理想伙伴。 但所有这些知识 — — 我们自己留着,或者说,我们失去了它们。 故事总是止步于此。 提问 → 回答 → 问题解决 — — 对话沉入聊天记录,消失不见。 然后另一个人
Copilot Studio 与 5 种不同的 Agent 构建器
我们都知道微软在 AI 和代理方面一直全速前进,随之而来的是变化(以及重命名 😎),但这也带来了重复和重叠。正是如此,我们在 M365/Power Platform 中得到了 5 种不同的代理构建工具。请注意,我没有包括 Foundry/Azure 构建工具,因为它们更多属于过程代码领域,而 M36