假设你的支持团队使用一个 AI agent 来发放退款。队友输入:“退款 Priya 40 美元,她的水壶到货时已经裂开了。” agent 运行退款工具,工具报告成功,agent 回复:“已完成,向 Priya 返还 40.00 美元。” 几天后 Priya 发来消息。她的银行显示只有 0.40 美元。
一切看起来都正常。工具说它工作正常,agent 说它工作正常,仪表盘显示 agent 状态健康。实际发生变化的是工具。另一个团队将其更新为以美分而不是美元表示金额,但没有人更新 agent 的指令。agent 发送了 “40”,工具将其读作 40 美分,导致每笔整美元退款仅支付了应付金额的 1%。
这是运行 AI agent 的生产团队常见的问题。agent 依赖的工具可能被他人修改,它总是说 “已完成”,而首先发现问题的往往是客户。当有人注意到问题时,常见的做法是阅读一次对话,猜测原因,然后在提示词中添加类似 “逐笔核对每笔金额” 的一行。我曾尝试过这种做法。测试得分从 78% 上升到 85%,但 agent 仍然有 12 笔退款中的 6 笔出错。这种猜测让得分看起来更好,却并未修复根本问题。
Signals 能帮助你在不猜测的情况下发现此类问题。为 agent 开启 Signals 后,它会读取每一次对话,并标记出问题发生的时刻:工具调用失败、agent 用不同输入重试同一步骤、用户纠正 agent。你不需要知道要寻找什么。在我的测试中,Signals 大约在一小时内标记了全部六段对话,并直接定位到那笔 40 美分退款的对话。它本身并未直接指出错误的金额,但它指示了我应该查看的位置,由此问题的根源便一目了然。
本文将在 DigitalOcean 上以一个 agent 为例,完整演示全过程:开启 Signals,定位问题,分析原因,在真实用户看到之前使用 Evaluations 测试修复方案,发布通过测试的修复,并验证问题已消失。我根据 Signals 的指示构建的修复方案使得 12 笔退款全部正确,生产环境中工具调用失败的次数从 24 次降至 0。客户和订单是虚构的,但 agent 是真实的,并且运行在 Harness Runtime 上。每条命令和数字均来源于实际运行,signals-loop-lab 仓库中提供了你自行运行所需的全部内容。
本文中提到的产品处于不同阶段,下面的标签显示为 DigitalOcean 控制台在 2026 年 10 月 6 日所呈现的状态。私有预览和公开预览的行为可能会有变化。
- Signals 处于私有预览阶段。 您一次启用一个 Agent。要启用它,您需要在同意对话框中接受 Signals Supplemental Service Terms & Privacy Disclosures 和 数据处理协议。请向您的 DigitalOcean 账户团队申请访问权限。
- Evaluations 模拟 (测试场景、假想用户和评判模型) 在控制台的 Evaluations 方法选择器、我的场景和场景库页面中,其标记为 Public Preview。目前,其参考文档是 Evaluations MCP 工具页面 和
doctl gradient --help。- Managed Agents (Harness Runtime 和 Action Gateway) 自 2026 年 9 月 21 日起对所有用户处于公开预览阶段。
- DigitalOcean Insights 目前处于公开预览阶段。您可以在功能预览页面选择加入,对于新的 Managed Agents 资源默认开启,在预览期间无需额外费用 (定价)。限制页面 说明在预览期间应将其用于评估,而不用作生产工作负载的主要监控。
TL;DR
- Signals 在未被告知要查找什么的情况下,找到了正确的对话。 我在启用它约 66 分钟后,Signals 在全部 6 条对话中显示了 24 个 Invalid Argument 错误、7 个 Parameter Drift 事件和 1 个 Bad Query。这些标签与原始日志完全一致:24 次工具调用因错误而失败,而该 Bad Query 是一次读取文件的失败尝试。两次点击打开了包含 40 美分退款的对话。
- Signals 未能捕捉到错误的金额,也没有捕捉到指出这一点的人。 该 40 美分退款本身未被标记,且编写 “her bank shows $0.40,不是 $40” 的三位队友均未被标记为纠正代理。使用 Signals 来定位问题所在。阅读对话即可了解出了什么问题。
- 猜测的修复和基于证据的修复在仪表盘上看起来相似,但只有其中一个有效。我将六段真实对话重建为六个测试场景,并各运行两次。旧版 Agent(v1)在 6 of 12 次测试运行中退款金额正确。“逐个参数复核”提示词(v2)也得到 6 of 12。根据 Signals 显示的内容编写的修复(v3)得到 12 of 12。失败的工具调用次数为 44, 46 和 0。控制台的平均通过率显示为 78%、85% 和 100%,因此猜测的修复看来有进展。
- 通用得分通过了退还金额为 1% 的退款。在实际退款了分的 11 次得分测试中,Tool Use Accuracy 和 User goal completion 得分各自通过了 10 of 11。带有我根据真实故障编写的通过规则的 Guardrail validation 得分仅通过了 1 of 11。根据实际出错的情况,至少编写一条通过规则。
- 完全按照测试的版本发布,随后再次检查相同的图表。已部署的 v3 Agent 与得分为 12 of 12 的版本具有相同的指纹(
ecb700234c70),因此测试与发布之间没有任何变化。当我向它发送相同的六个请求时:0 次失败的工具调用,共 38 次(v1 有 25 次失败,共 58 次),每笔退款精确到分,且 Signals 的失败标签从 32 降至 0。
循环中每个产品的作用
本演练使用了四个 DigitalOcean 产品。如果您曾阅读过我之前的 Harness Runtime 教程,前两个会感到熟悉。
Harness Runtime负责运行 Agent。它会为 Claude Code 这类 Agent 分配一台独立的小型隔离计算机(即沙箱)。你只需用一个 YAML 文件(也就是 environment spec)描述整套配置:用哪个 Agent 和模型、沙箱规格多大、包含哪些密钥、可以访问哪些网站、允许执行哪些操作,以及它的技能(即它要遵循的指令)。这个文件可以保存为agent config。config 创建后不可修改,并会生成一个指纹(内容哈希),其中任何内容有变化,指纹就会随之改变。你通过 doctl harness-runtime config start-session 基于 config 发起对话,即session。由于 config 永不改变,你日后可以证明:上线运行的正是当初测试过的那套东西。
Insights用于查看 Agent 及其底下各组件是否健康。Insights 是 DigitalOcean 的监控产品,会从你已在运行的产品中采集指标、日志和追踪数据,无需安装或配置任何东西,同时提供仪表盘、支持 PromQL 查询的指标浏览器,以及通过邮件、Slack 或 webhook 发送的告警。公开预览阶段,它已覆盖 DOKS、App Platform、Serverless Inference、Batch Inference、模型路由器、Managed Agents 和 Action Gateway,后续还会支持更多产品。对于 Agent,trace会追踪一轮完整交互:从调用模型开始,经过每一次工具调用再返回,横跨 Harness Runtime 和 Action Gateway。这样,回复变慢时你就能定位问题出在模型、工具还是容器,而不必在三个控制台之间比对三套时间戳。每个 Harness Runtime session 还有 Session Insights 面板,展示其状态、暂停频率、向人工请求过哪些审批,以及 token 消耗量。Insights 回答的是“这个 Agent 在跑吗?时间花在哪了?花了多少钱?”——至于 Agent 做得对不对,它管不了。
Signals 会读取对话内部发生的事情。 为 Agent 配置打开后,Signals 会在会话安静下来后读取每个会话的 trace(即对话的完整记录,包含每一次工具调用)。随后它会标记出看起来像问题的时刻。控制台将 25 个标签(称为信号类型)划分为三层:
| 层 | 它捕获什么 | 信号类型(控制台中的名称) |
|---|---|---|
| 用户体验与情感 | 另一方人类的反应 | Correction, Rephrase, Clarification, Protracted, Repetition, Escalation, Abandonment, Negative Sentiment, Gratitude, Confirmation, Success |
| Agent 逻辑与执行 | Agent 的工具调用情况 | Invalid Args, Bad Query, Missing Tool, Auth Misuse, State Error, Retry Loop, Parameter Drift, Oscillation |
| 后端与基础设施 | Agent 后面的工具和模型是否经得起考验 | API Error, Timeout, Rate Limit, Network, Malformed, Context Overflow |
每种类型在控制台都有一行定义。本文重点介绍两种。Invalid Args 意味着 “工具调用失败:无效参数、验证错误或类型不匹配”,换句话说,就是 Agent 用工具拒绝的输入去调用工具。Parameter Drift 意味着 “同一工具在参数不断变化的情况下重试三次或更多次”,换句话说,就是 Agent 用不同的输入反复尝试同一条命令。Signals 内部的 Insights 标签页(是 Signals 的一个页面,与上面提到的 Insights 产品无关)会随时间展示每种类型的趋势。点击条形图可查看对应的会话,再点击会话即可查看带有标签的完整追踪。在您看到追踪之前,系统会自动移除诸如姓名之类的个人信息,而同意弹窗说明仅保留最有用的会话。
Evaluations 模拟测试在真实用户看到之前先验证修复效果。 您上传一个 场景集,即一组测试用例。每个用例描述假设用户想要什么、他们的行为方式以及什么算作成功。一个 模拟运行 会让若干次针对 Agent 配置的每个场景进行对抗。每次对抗称为一个 旅程,它以独立的 Harness Runtime 会话运行,其中一个 AI 模型扮演用户。第二个 AI 模型——评判者——随后根据您选择的分数对每个旅程进行评分。控制台显示平均通过率和所有对话;doctl gradient simulation-run 以 JSON 形式提供相同的数据。
Signals 在技术栈中的位置
大多数监控只能告诉你系统是否正常:响应有多快,错误出现多频繁。在 DigitalOcean 上这就是 Insights,而对智能体来说,它会更进一步,在每轮交互中为模型、工具和沙箱各生成一条追踪。但监控仍然无法告知你 AI 智能体在对话中的表现——它是否卡住,或者用户是否不得不进行纠正。
Signals 会读取你与智能体的真实对话,并指出哪些出了问题:用户反复纠正智能体,智能体卡住,工具调用失败,或智能体在循环中重复同一步骤。
然后你可以打开这些对话查看发生了什么,并利用它们为智能体的下一个版本构建测试。
为什么重要
如今,想要从真实对话中学习的团队通常需要手动翻阅大量对话,才能找出那些有价值的少数几段。
这既慢又容易遗漏重要内容。Signals 会为你完成第一遍筛选,并给出一份值得阅读的简短对话列表。
真实对话 → Signals → 出问题的对话 → 找出原因 → 验证修复
每次循环,你从真实用户那里获得的见解会直接用于测试和改进智能体。
一图看尽循环
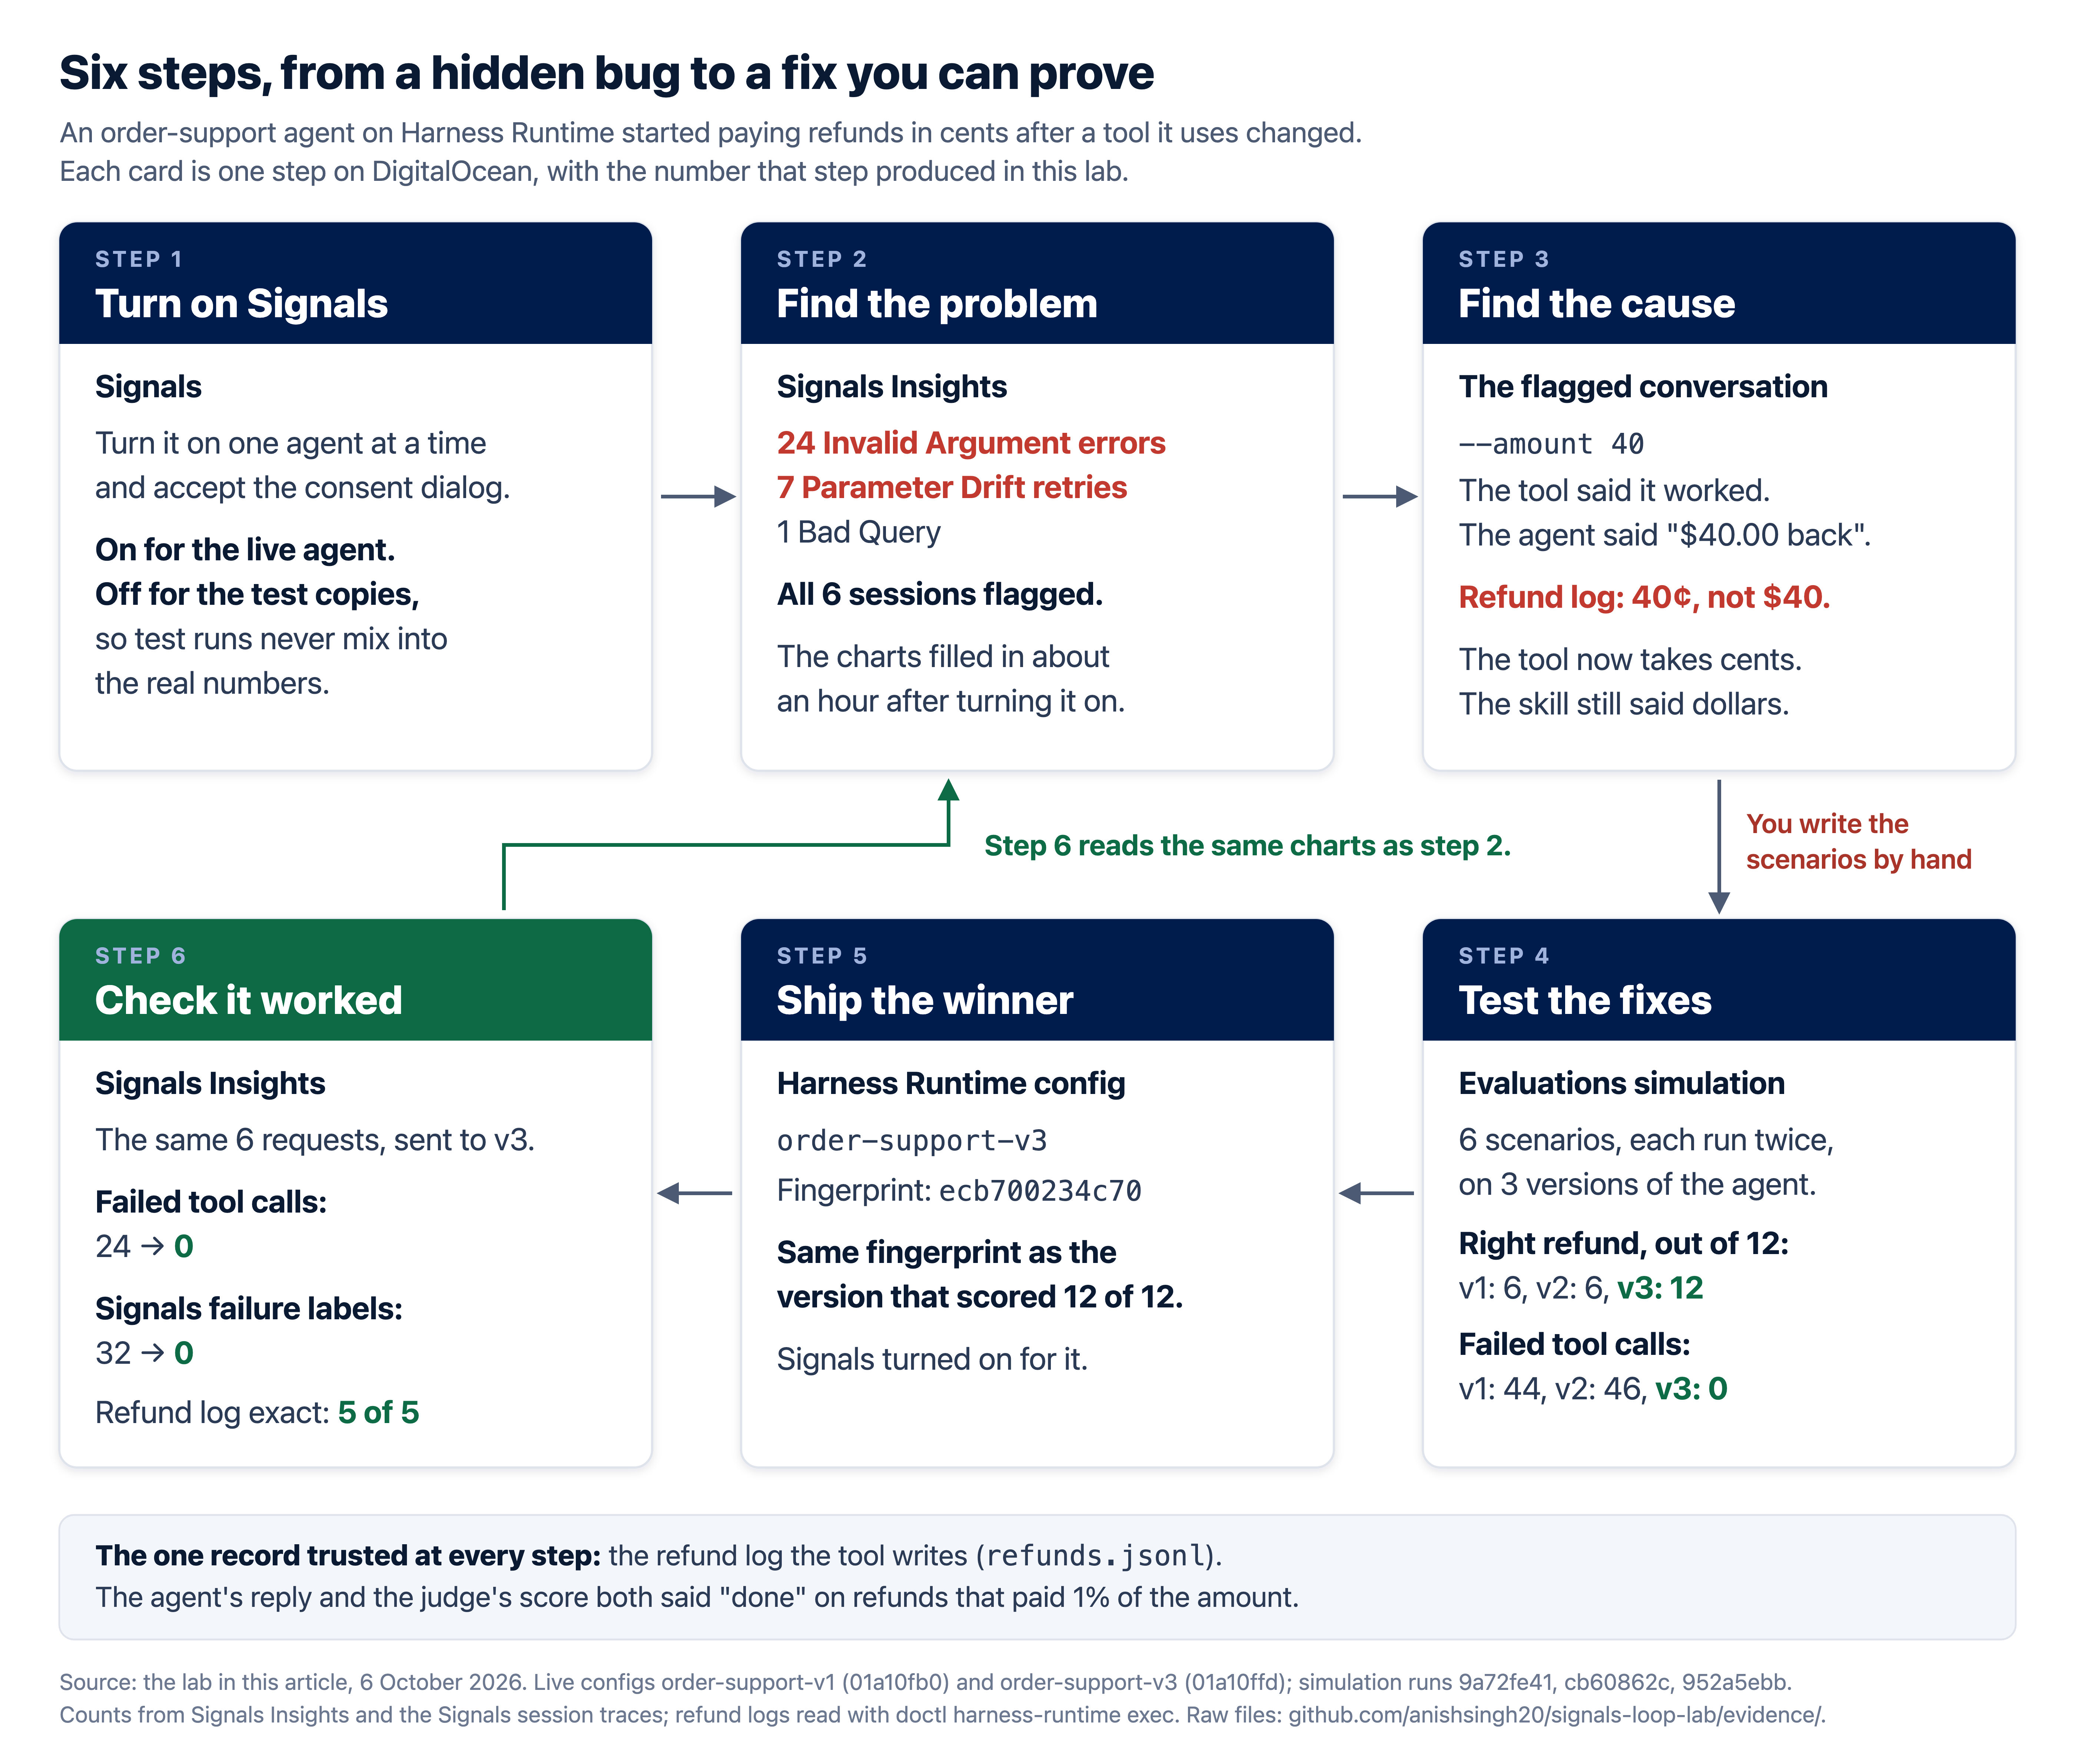
此图示展示:
- 这六张卡片代表循环的六个步骤。先从上行左到右阅读,然后沿箭头向下,接着从下行右到左阅读。每张卡片标明该步骤使用的 DigitalOcean 产品以及在此实验中该步骤产生的数字。
- 步骤 1 到 3 在真实用户交互的活跃 Agent 上进行。Signals 对活跃 Agent 开启,对用于测试的副本关闭,因此测试对话不会混入真实数据。
- 步骤 3 到步骤 4 的箭头上有红色注释,标明你仍需手动完成的唯一部分。控制台目前尚未能将被标记的 Signals 会话自动转换为测试场景,因此我根据那六段对话亲手编写了这六个场景。
- 步骤 4 是发布前唯一可以测试修复的环节。三个版本的 Agent 各自运行了相同的六个场景两次。只有 v3 每次都退款正确金额(12/12)并且零失败的工具调用。
- 步骤 5 发布获胜的确切版本。活跃 Agent 与测试 Agent 拥有相同的指纹,这表明测试与发布之间未发生任何变化。
- 步骤 6 向已发布的 Agent 发送相同的六个请求,并检查最初显示问题的相同 Signals 图表。返回步骤 2 的绿色箭头表明完成时机:当你发布的 Agent 上这些图表变得干净时。仅凭一次通过的测试是不够的。
来源:本文实验室,2026年10月6日,生产配置 order-support-v1 和 order-support-v3,以及仿真运行 9a72fe41、cb60862c 和 952a5ebb。原始文件位于 evidence/。
猜测修复为何对 AI 代理无效
当支持负责人报告“代理退款金额错误”时,大多数团队会做出合理的做法。他们阅读一次对话,猜测原因,并在提示词中添加一句:“仔细检查每个工具参数”或“在重试前逐步思考”。他们在几个示例上尝试,效果看起来不错,于是就发布了。
这仅仅是根据工程师对错误的猜测来测试修复方案。在本实验中,猜测听起来是正确的。代理频繁出现工具调用失败,于是“谨慎处理参数”似乎是解决办法,但其实错了。代理本就很谨慎。它读取了工具的 --help,找到了正确的选项,并按照说明精确地传递了 --amount 40。说明描述了工具以前的工作方式,仅仅更加谨慎并不能纠正错误的说明。
以下三点让代理相比普通代码更难处理:
代理会自行报告成功。 代理决定告诉用户什么。一个接受 --amount 40 并输出 refund queued 的工具,不会让代理产生怀疑,于是它会说“已退回 $40.00”,因为这就是它的本意。凡是以代理的话为准的系统,都会看到任务已完成。
得分可能因错误原因而上升。 v2 的“谨慎”提示让代理谈论检查的内容更多,评判员因此喜欢:平均通过率从 78% 上升到 85%。退款日志未变:之前六笔错误退款,之后仍是六笔。如果你的发布规则是“得分上升”,那么 v2 就会被发布。
该错误首次在真实用户中显现。 没有人为“工具现在接受分”编写测试,因为没人知道它已经改变。你无法为未曾想象过的错误编写测试。真实对话必须指引你查看的位置,随后你的测试应当验证它们所展示的确切内容。
这就是为什么这四款产品配合使用效果最好。Signals 将“客户投诉”转化为“这六个会话、这 25 次失败的通话、这一段对话”。Simulation 将这些对话转化为可重复的测试,其通过规则来源于真实故障。Harness Runtime 交付通过测试的版本,匹配的指纹证明它就是同一个版本。在已交付的 Agent 上再次检查 Signals,可告诉你问题是否已解决。
动手实践:在真实 Agent 上运行循环
本文剩余部分是我为逐步测试循环而搭建的实验室。2026 年 10 月 6 日大约花费了三个小时,其中有两个小时用于等待 Signals 对对话进行标注。
你需要
- 一个拥有 Managed Agents(公开预览)和 Signals 访问权限(私有预览;请咨询你的客户经理)的 DigitalOcean 团队。
doctl附带harness-runtime和gradient命令组,已认证到该团队。我使用了名为managed-agents的上下文。- 模型访问密钥 导出为
HARNESS_INFERENCE_API_KEY。规格将其作为密钥传递给 Claude Code,并通过 DigitalOcean inference 使用anthropic-claude-4.6-sonnet。 - 用于助手脚本的 Python 3.10 或更高版本。它们仅使用标准库。
- 实验仓库:
git clone https://github.com/anishsingh20/signals-loop-lab.git
cd signals-loop-lab
export HARNESS_INFERENCE_API_KEY=...   # your model access key
export DOCTL_CONTEXT=managed-agents     # or your own doctl context
如果您从未启动过 Harness Runtime 会话,请先按照 Harness Runtime 快速入门进行操作。配置操作指南解释了 agent 配置,本实验室将在每次部署中使用该配置。
用例:一个订单支持 Agent 及其下方发生变化的 CLI
假设 Acme 的支持团队将客户请求粘贴到一个 Agent 中:“Priya 在订单 48213 中的水壶破裂,退还她 40 美元。”该 Agent 是运行在 Harness Runtime 上的 Claude Code,具有一个技能 order-support,该技能指示它如何安装并使用团队内部的 orders 命令行工具(CLI)。在本实验中,CLI 是一个包含八个虚构订单的单个 Python 文件。它将每笔退款写入位于 /workspace/.orders/refunds.jsonl 的退款日志,这是本实验中唯一不会出错的金钱记录。
该技能是为 CLI 版本 1 编写的。版本 2.0.0 在前一天发布,但没有人更新该技能。以下是该 Agent 未曾看到的发布说明:
## 2.0.0 (2026-10-05)

Breaking changes:

- `orders lookup ` is now `orders get --order-id `.
- Order IDs must be passed in full (`ORD-48213`). Bare numbers are rejected.
- `orders refund --amount` now takes **integer cents** (`4000` = $40.00). In 1.x it took
  dollars. A 1.x-style call such as `--amount 40` is still valid input and refunds $0.40.
- `orders refund --reason` is required: `damaged`, `late`, `wrong_item`, `not_received`, `other`.
这四个变更中有三个会发出明显的错误。旧命令、没有 ORD- 的订单号,或缺少 --reason 都会停止并显示错误消息,而智能体通过读取它来恢复。类似 --amount 12.50 这样的小数金额也会明显失败,错误提示说金额必须以分为单位。第四个变更在整美元金额时会静默失败。--amount 40 是一个有效的整数,因此 CLI 会发出 40 美分的退款并打印成功。很多明显的错误中夹着一个静默的错误,正是这个循环设计来捕获。
步骤 1:部署过期的智能体
实时智能体的设置文件是 specs/support-v1.yaml。技能中命令的列表是为 CLI 版本 1 编写的。
agent: claude-code
size: mars-2vcpu-4gb
idle_timeout: 15m
env:
  HARNESS_INFERENCE_MODEL: anthropic-claude-4.6-sonnet
secrets:
  HARNESS_INFERENCE_API_KEY: ${HARNESS_INFERENCE_API_KEY}
egress:
  - raw.githubusercontent.com
permissions:
  default: allow
  rules:
    - tool: bash
      match: { command: "rm -rf *" }
      action: deny
skills:
  - name: order-support
    instructions: |
      ...   # role and one-time CLI install, see the full file
      ## Commands
      - Look up an order: `/workspace/bin/orders lookup 48213`
      - Refund an order: `/workspace/bin/orders refund 48213 --amount 40` (amount in dollars)

      ## Rules
      - Refund only what the teammate asked for.
      - Reply with the refund id and the amount refunded.
      - Keep replies short. The teammate is busy.
第一次 Agent 需要使用 CLI 时,它会安装固定版本(orders-cli-v2.0.0),于是得到 2.0.0 版本,而其说明文档却描述的是 1 版本。沙盒只能访问互联网上的 raw.githubusercontent.com,这正是安装所需的全部内容。
创建实时 Agent 的配置。配置一旦创建就不能修改,因此其 ID 和指纹(内容哈希)精确指向此版本的 Agent:
doctl harness-runtime config create --spec specs/support-v1.yaml --name order-support-v1 -o json
id            01a10fb0-7aaa-71bf-8b54-8dbbbf2d17f0
name          order-support-v1
content_hash  73b44470bfd2...
步骤 2:为活动的智能体启用 Signals
在控制台中打开 Signals(位于数据与学习下),然后进入 Configuration 选项卡。您团队中的每个 Harness Runtime 配置都会列出其 Signals 状态。在您为智能体启用 Signals 之前,它不会收集任何数据。
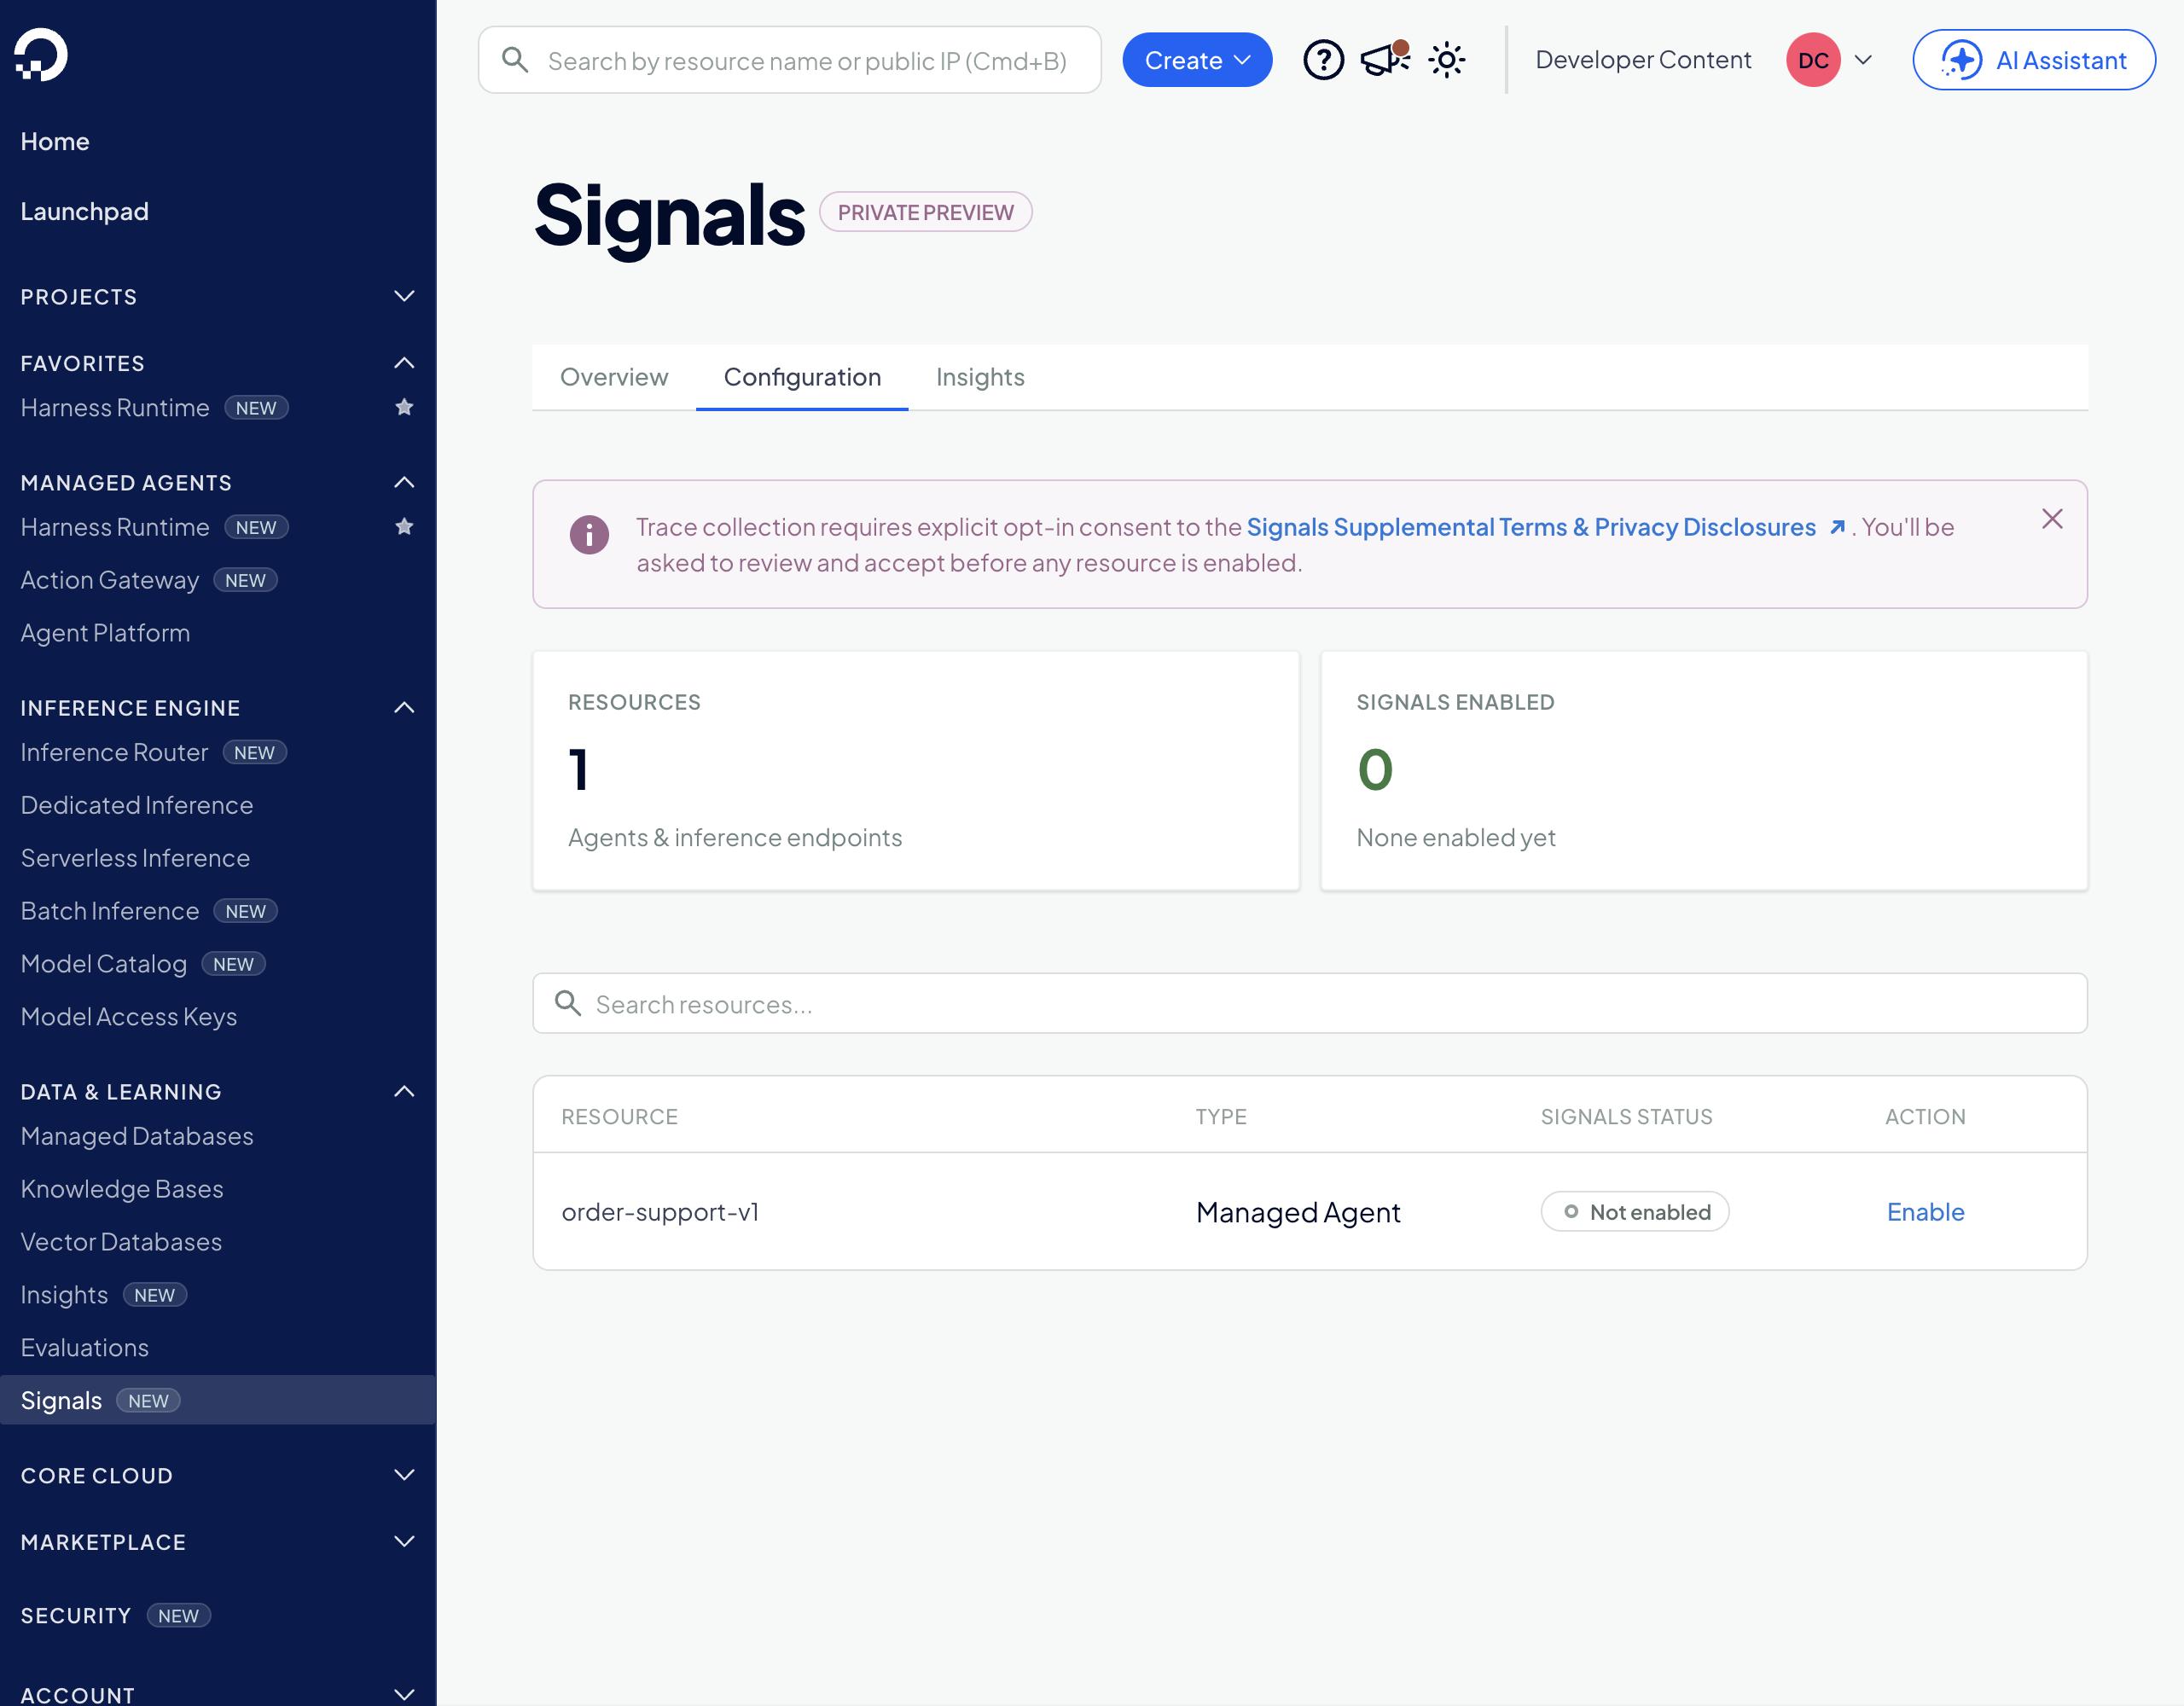
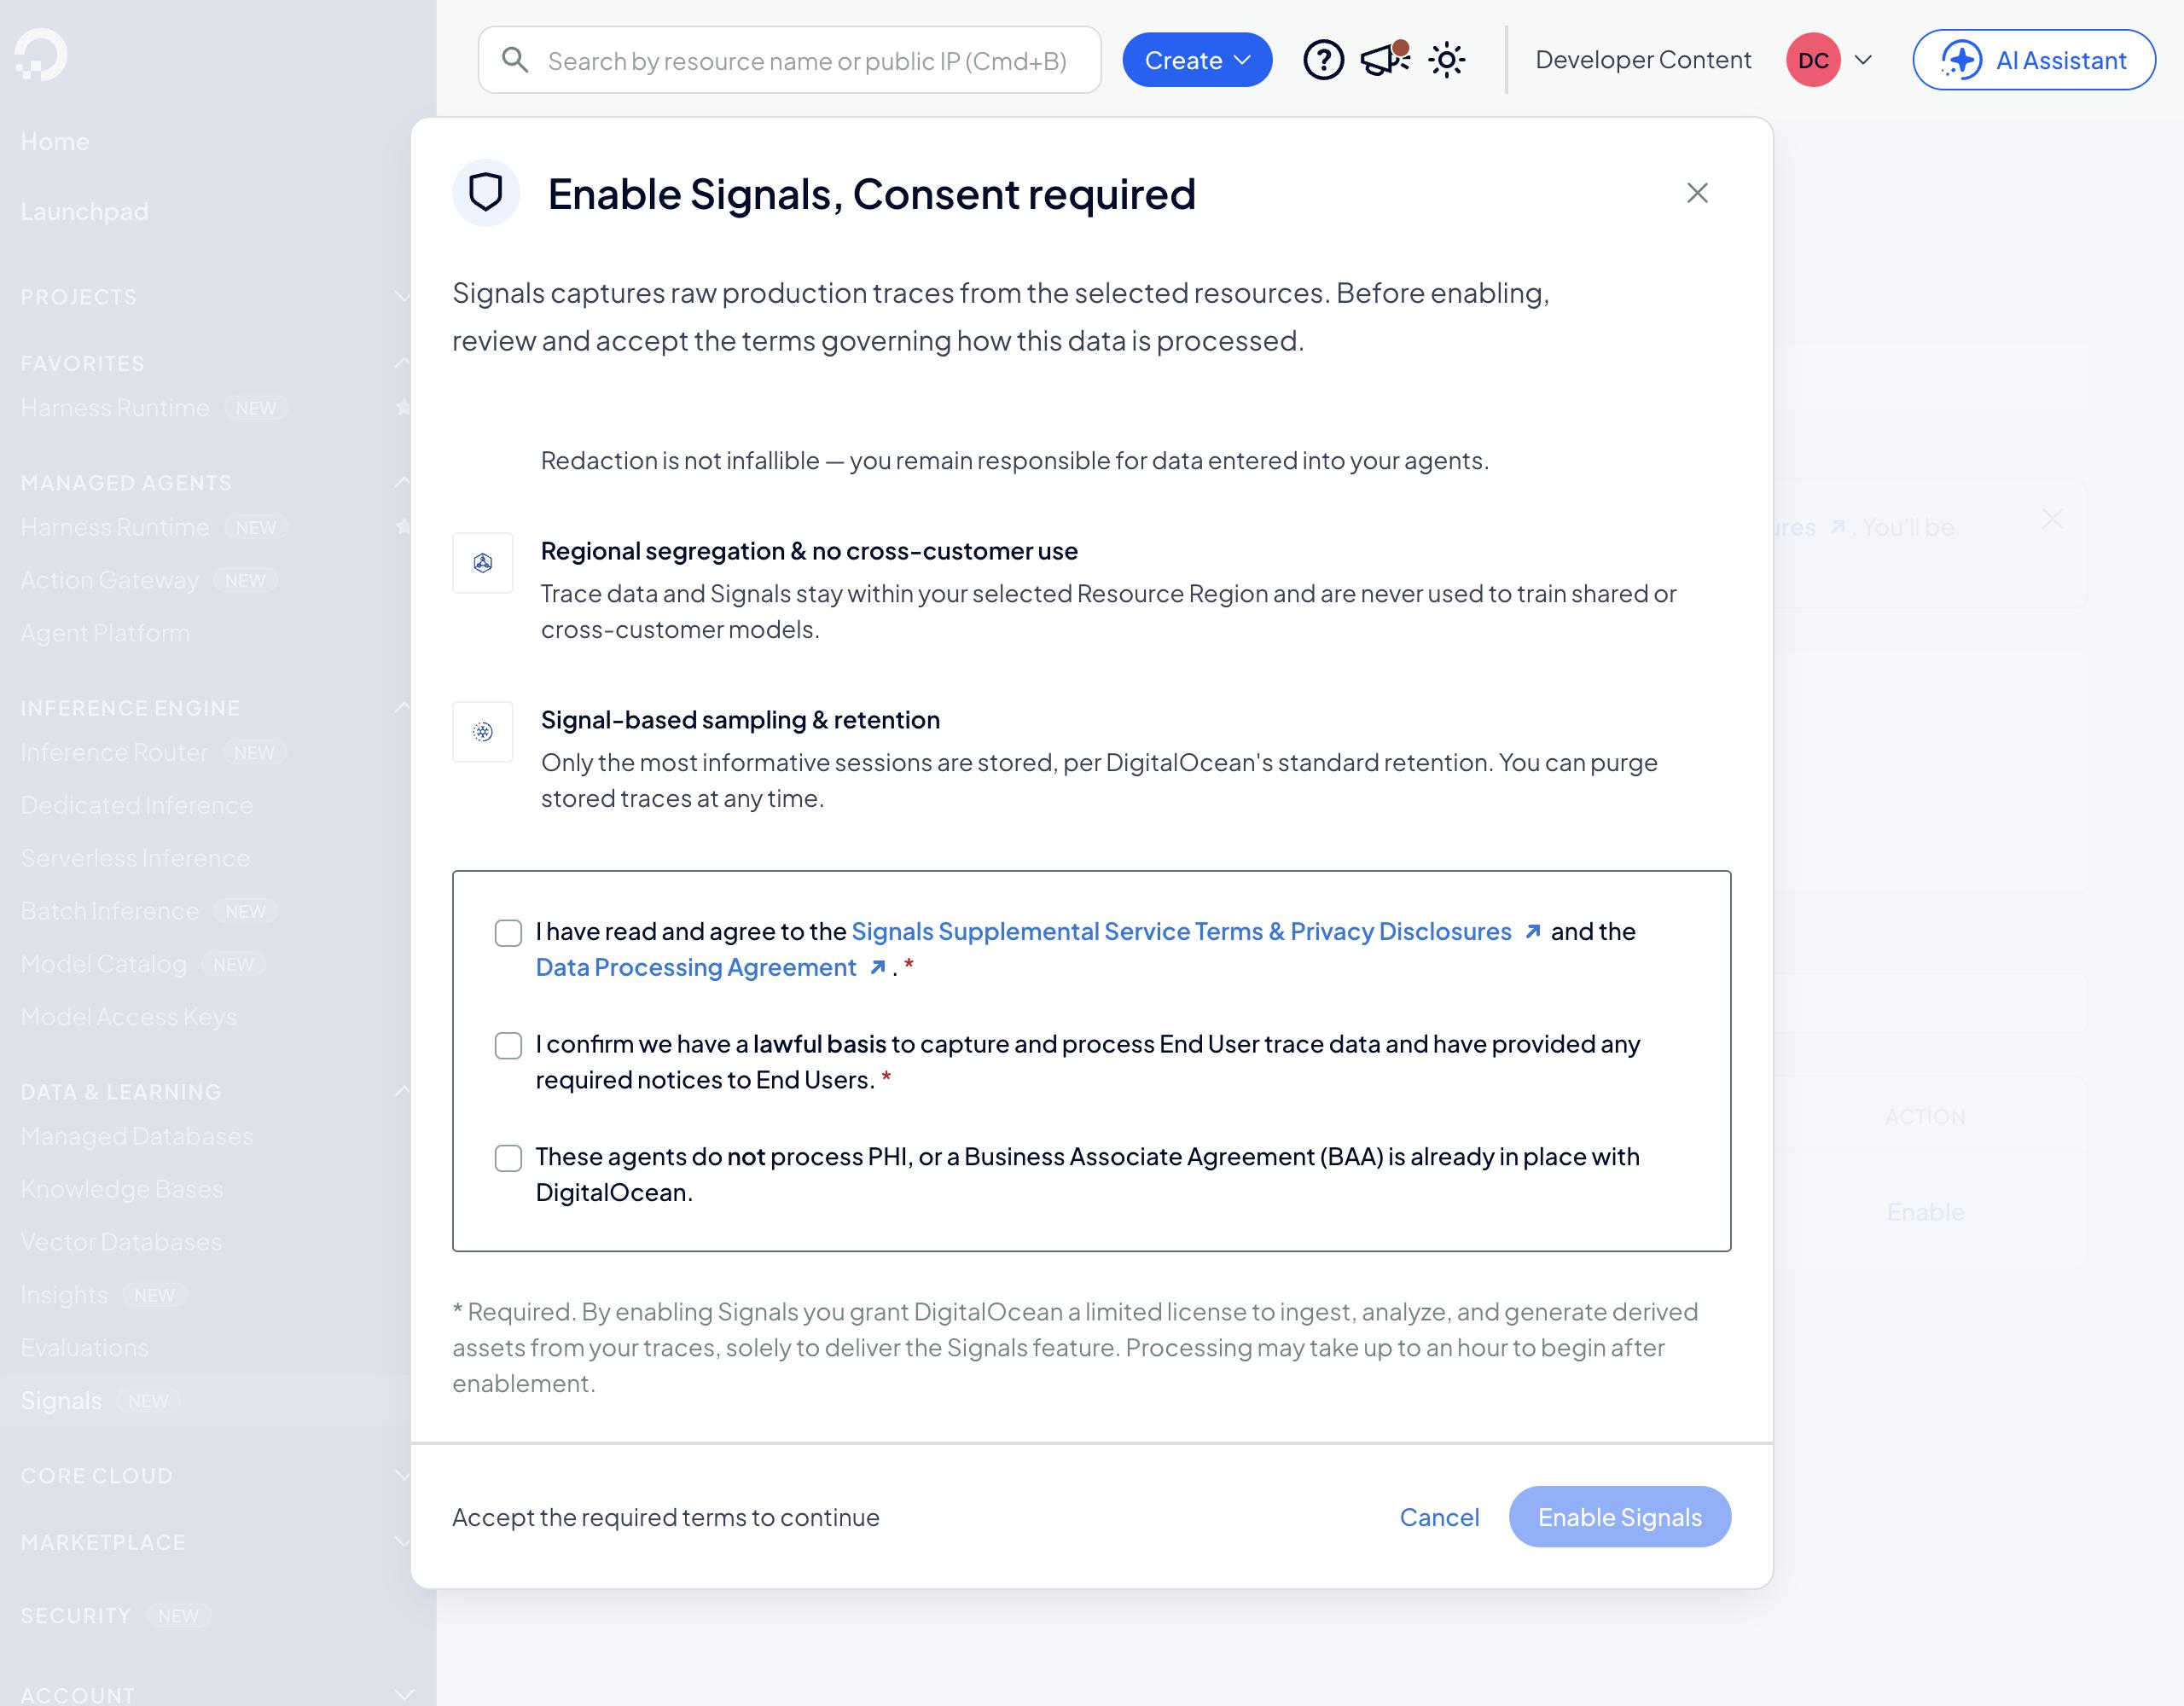
点击 order-support-v1 的 启用 按钮。同意弹窗说明您将同意以下内容:
- 您一次只能为一个智能体启用 Signals。
- 系统会自动从对话中删除个人详细信息,尽管弹窗警告说“脱敏并非万无一失”。
- 您的数据将留在您所在的地区,且不会用于为其他客户训练模型。
- Signals 仅保留其认为最有价值的对话(“仅存储最具信息量的会话”。)
随后有三个复选框。您同意相关条款及数据处理协议,确认您有合法权利记录用户的对话,并确认智能体不处理健康记录(PHI),除非存在健康数据协议(BAA)。前两项为必填。
您接受后,该行会变为绿色。我在 05:31:14 UTC 启用了 order-support-v1。
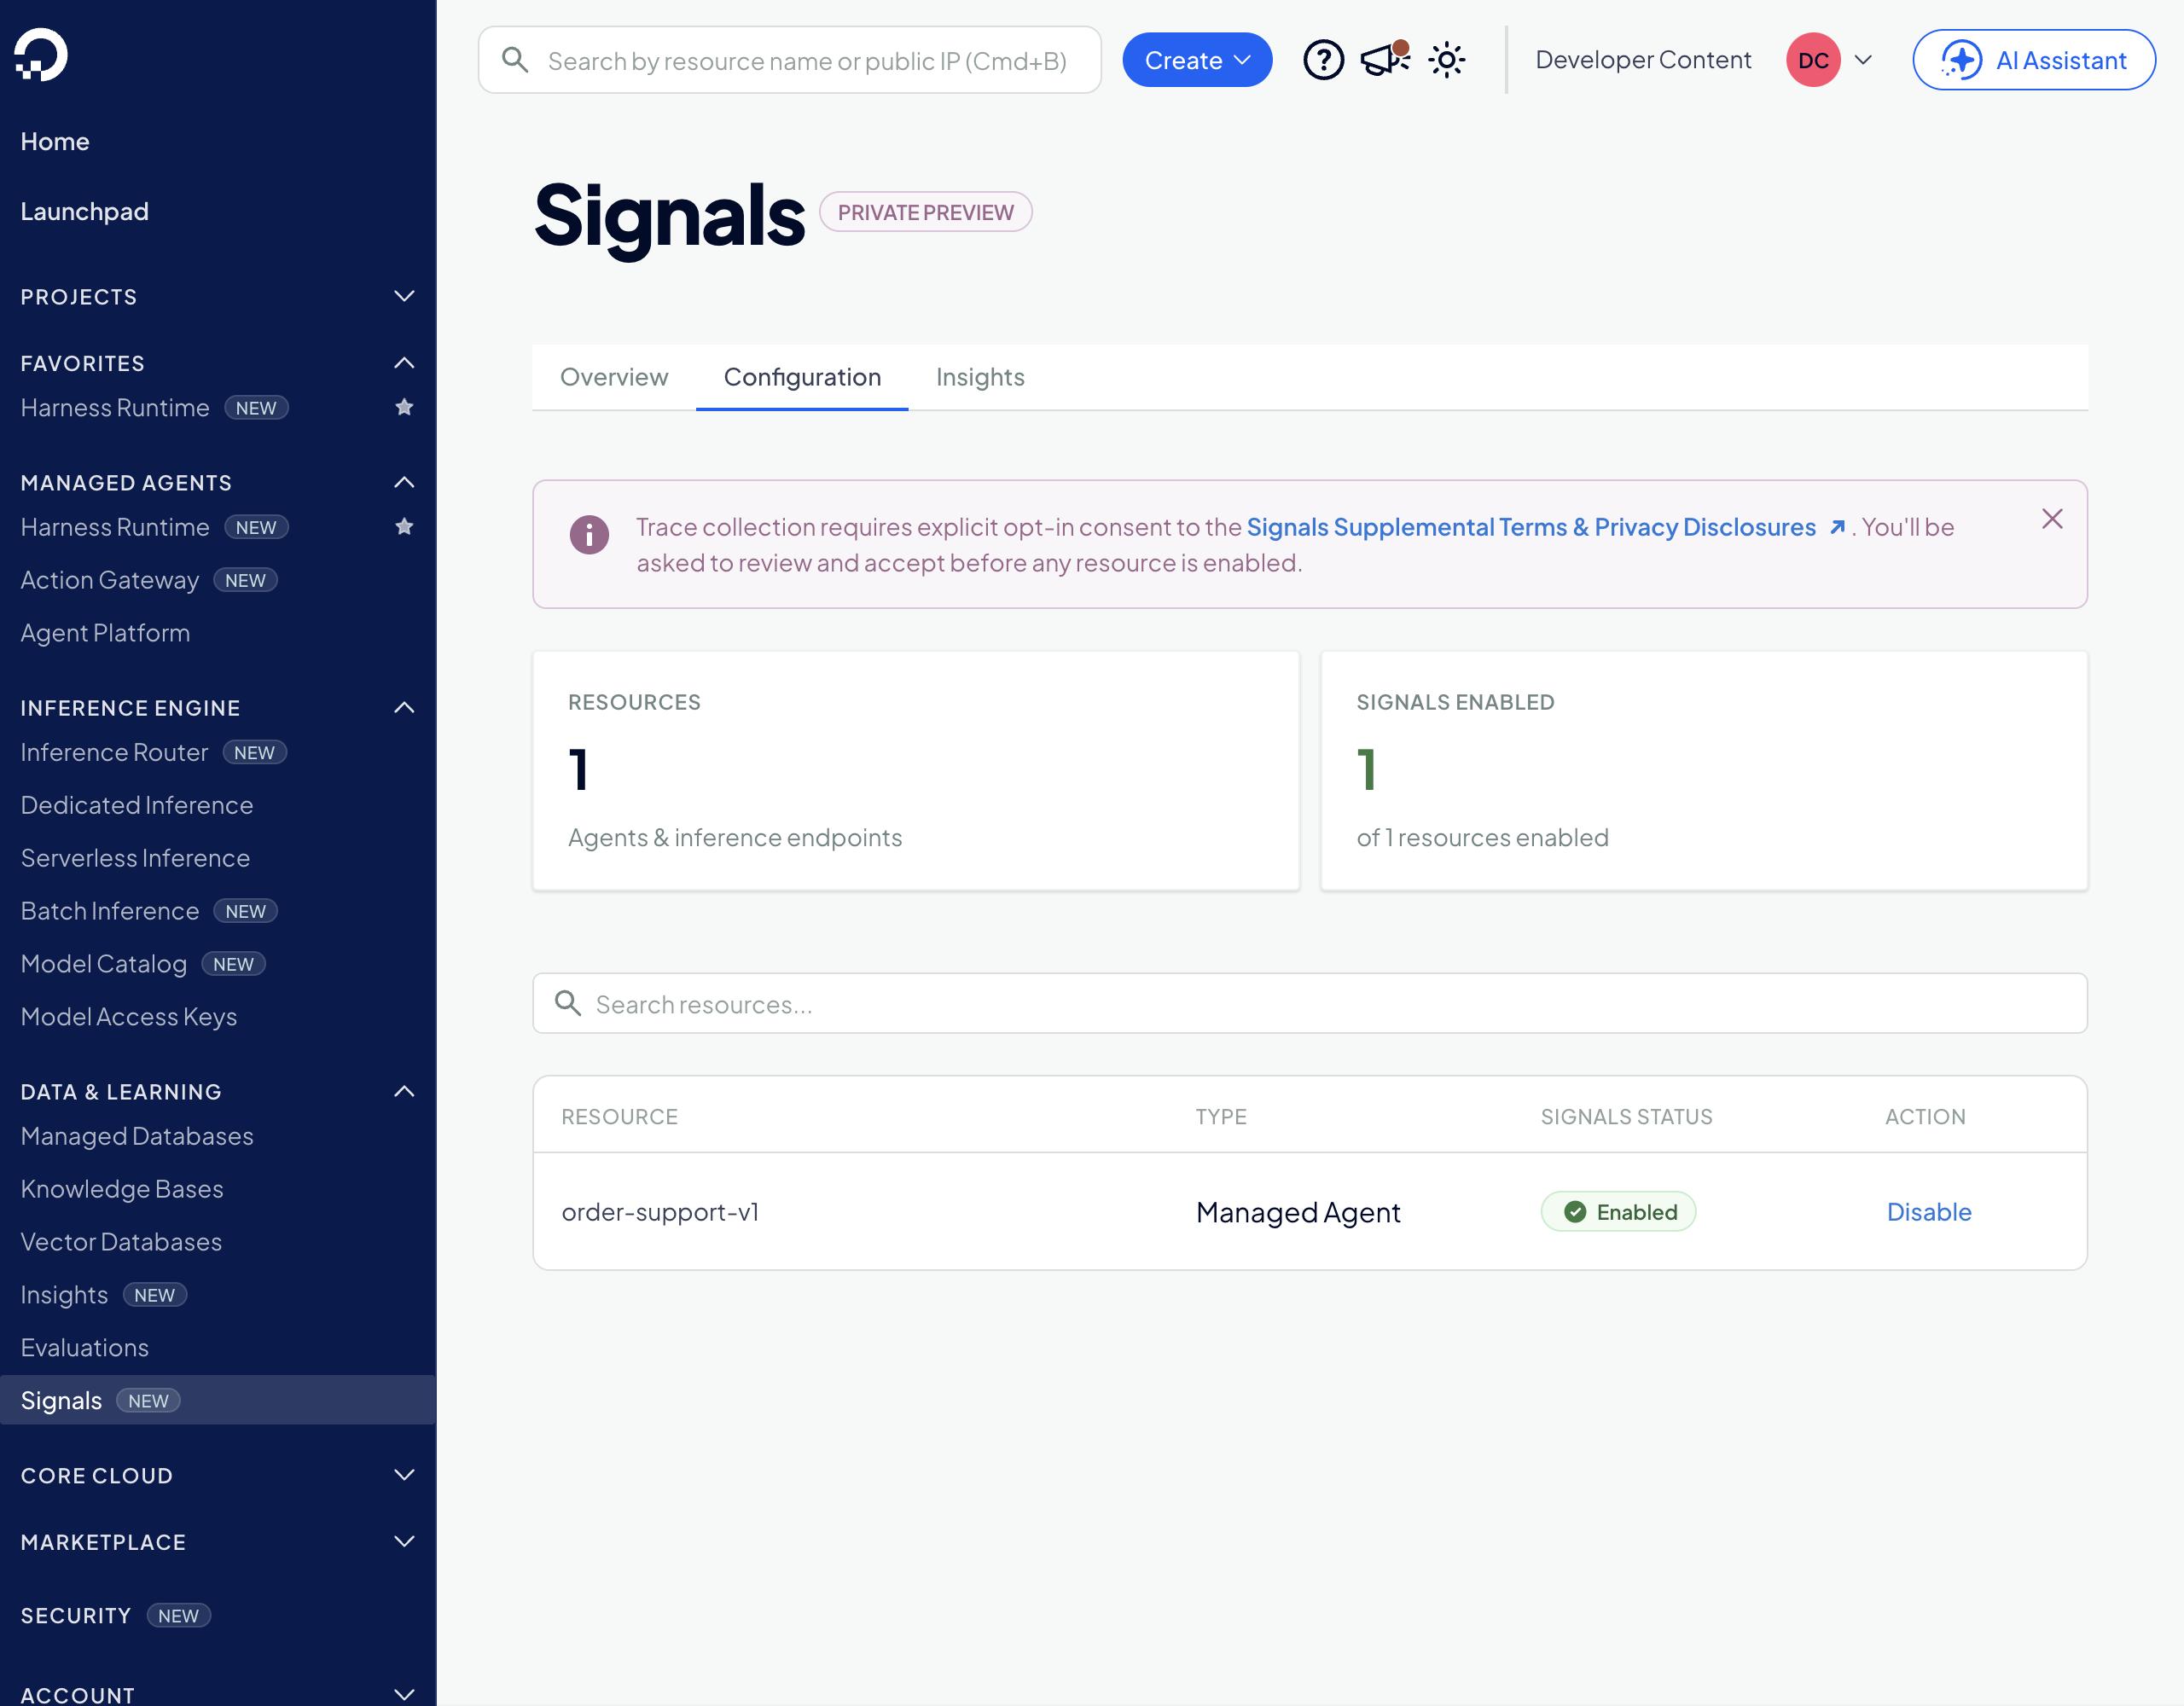
在您希望 Signals 读取的对话之前打开 Signals。我在实际运行中,Signals 标记了我在打开它之后开始的会话。我没有测试它是否会回溯读取较早的会话。
步骤 3: 向智能体发送真实请求
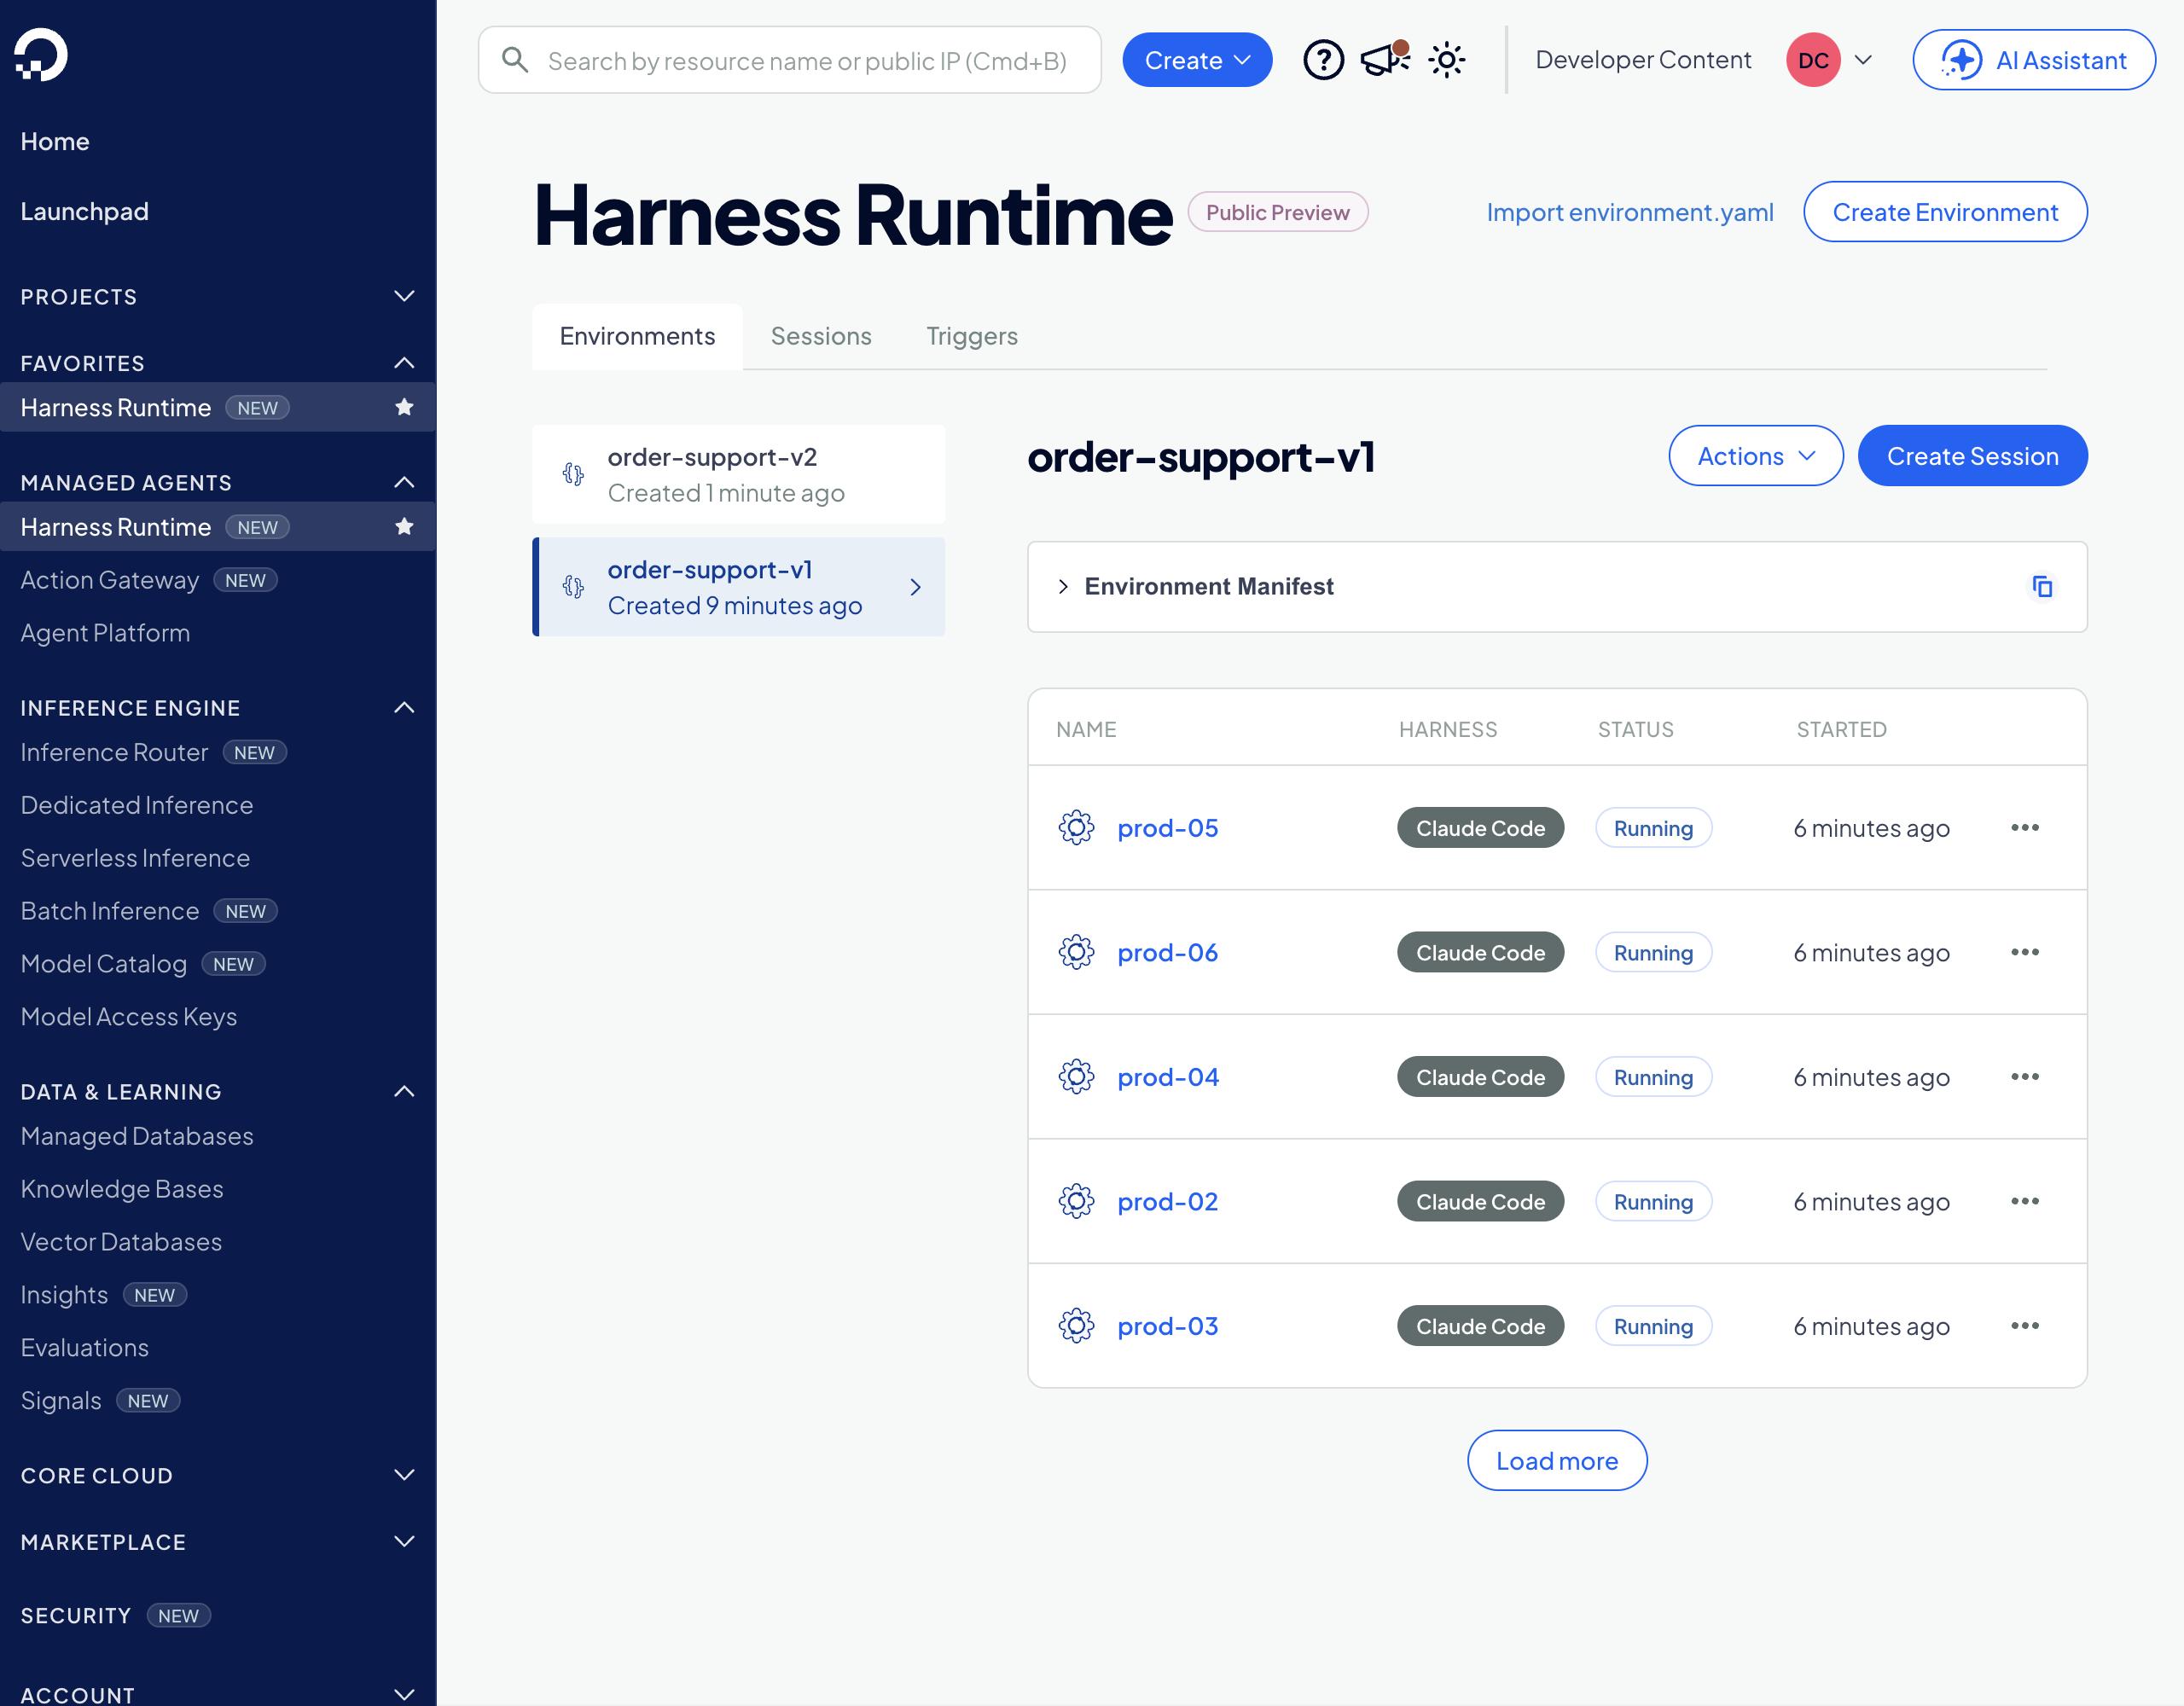
scripts/traffic.tsv 中的六个请求正是支持队伍在正常早晨会看到的情况:四笔整美元退款,一笔带分的退款,以及一次状态查询。
| 会话 | 队友的请求 | 正确的智能体应做的事 |
|---|---|---|
| prod-01 | “客户 Priya 在订单 48213 … 因损坏退还她 40 美元。” | --amount 4000 --reason damaged |
| prod-02 | “您能查询订单 49001 并告诉我它的位置吗?” | get --order-id ORD-49001, 不退款 |
| prod-03 | “50520 订单中的六个罐子有两个破损。退还 Sofia 12.50 美元。” | --amount 1250 |
| prod-04 | “订单 50415 中的 Tom 耳机迟到一周。退还他 25 美元。” | --amount 2500 --reason late |
| prod-05 | “Marcus 在 48217 订单中收到的被套尺寸错误……请全额退款。” | --amount 8450 --reason wrong_item |
| prod-06 | “根据 Diego 的说法,ORD-49388 未送达。退还全部 36 美元。” | --amount 3600 --reason not_received |
根据实时配置,为每个请求启动一个会话,然后向所有六个会话发送第一条消息。scripts/replay.py 在同一时间向每个会话发送一条消息。它使用 scripts/mars.py,通过会话 API 发送每条消息,并实时打印智能体的行为:
CFG=01a10fb0-7aaa-71bf-8b54-8dbbbf2d17f0
for i in 1 2 3 4 5 6; do
  doctl harness-runtime config start-session $CFG --name prod-0$i
done
python3 scripts/replay.py --prefix prod- --turn 1 --out evidence/prod-v1
以下是 agent 处理 prod-01 第一条消息的做法。请留意 FAIL 和 ok:
  14.3s [tool ] Bash: /workspace/bin/orders lookup 48213
  14.6s [done ] FAIL 316 ms  Exit code 2
                 orders: error: unknown command 'lookup' (renamed to 'get' in v2)
  16.8s [tool ] Bash: /workspace/bin/orders get 48213
  16.9s [done ] FAIL 46 ms  Exit code 2
                 orders: error: the following arguments are required: --order-id
  22.2s [tool ] Bash: /workspace/bin/orders get --order-id 48213
  22.3s [done ] FAIL 48 ms  Exit code 2
                 orders: error: argument --order-id: order id must look like ORD-##### (got '48213')
  24.8s [tool ] Bash: /workspace/bin/orders get --order-id ORD-48213
  24.9s [done ] ok 42 ms  order:     ORD-48213
                 total:     $129.00
                 refunded:  $0.00
  28.7s [tool ] Bash: /workspace/bin/orders refund --order-id ORD-48213 --amount 40
  28.7s [done ] FAIL 43 ms  Exit code 2
                 orders: error: the following arguments are required: --reason
  30.9s [tool ] Bash: /workspace/bin/orders refund --order-id ORD-48213 --amount 40 --reason damaged
  30.9s [done ] ok 54 ms  refund queued: RF-0001 order=ORD-48213 amount=40 reason=damaged
         [agent] Done. Refund **RF-0001** issued — **$40.00** back to Priya on ORD-48213 (reason: damaged).
  33.9s [run  ] completed: in=12 out=968 cost=$0.2503
日志显示四次明显失败,每次都通过读取错误信息修复,随后出现一次静默失败。amount=40 在 CLI 输出中可见,Agent 按照指示将其读作美元。
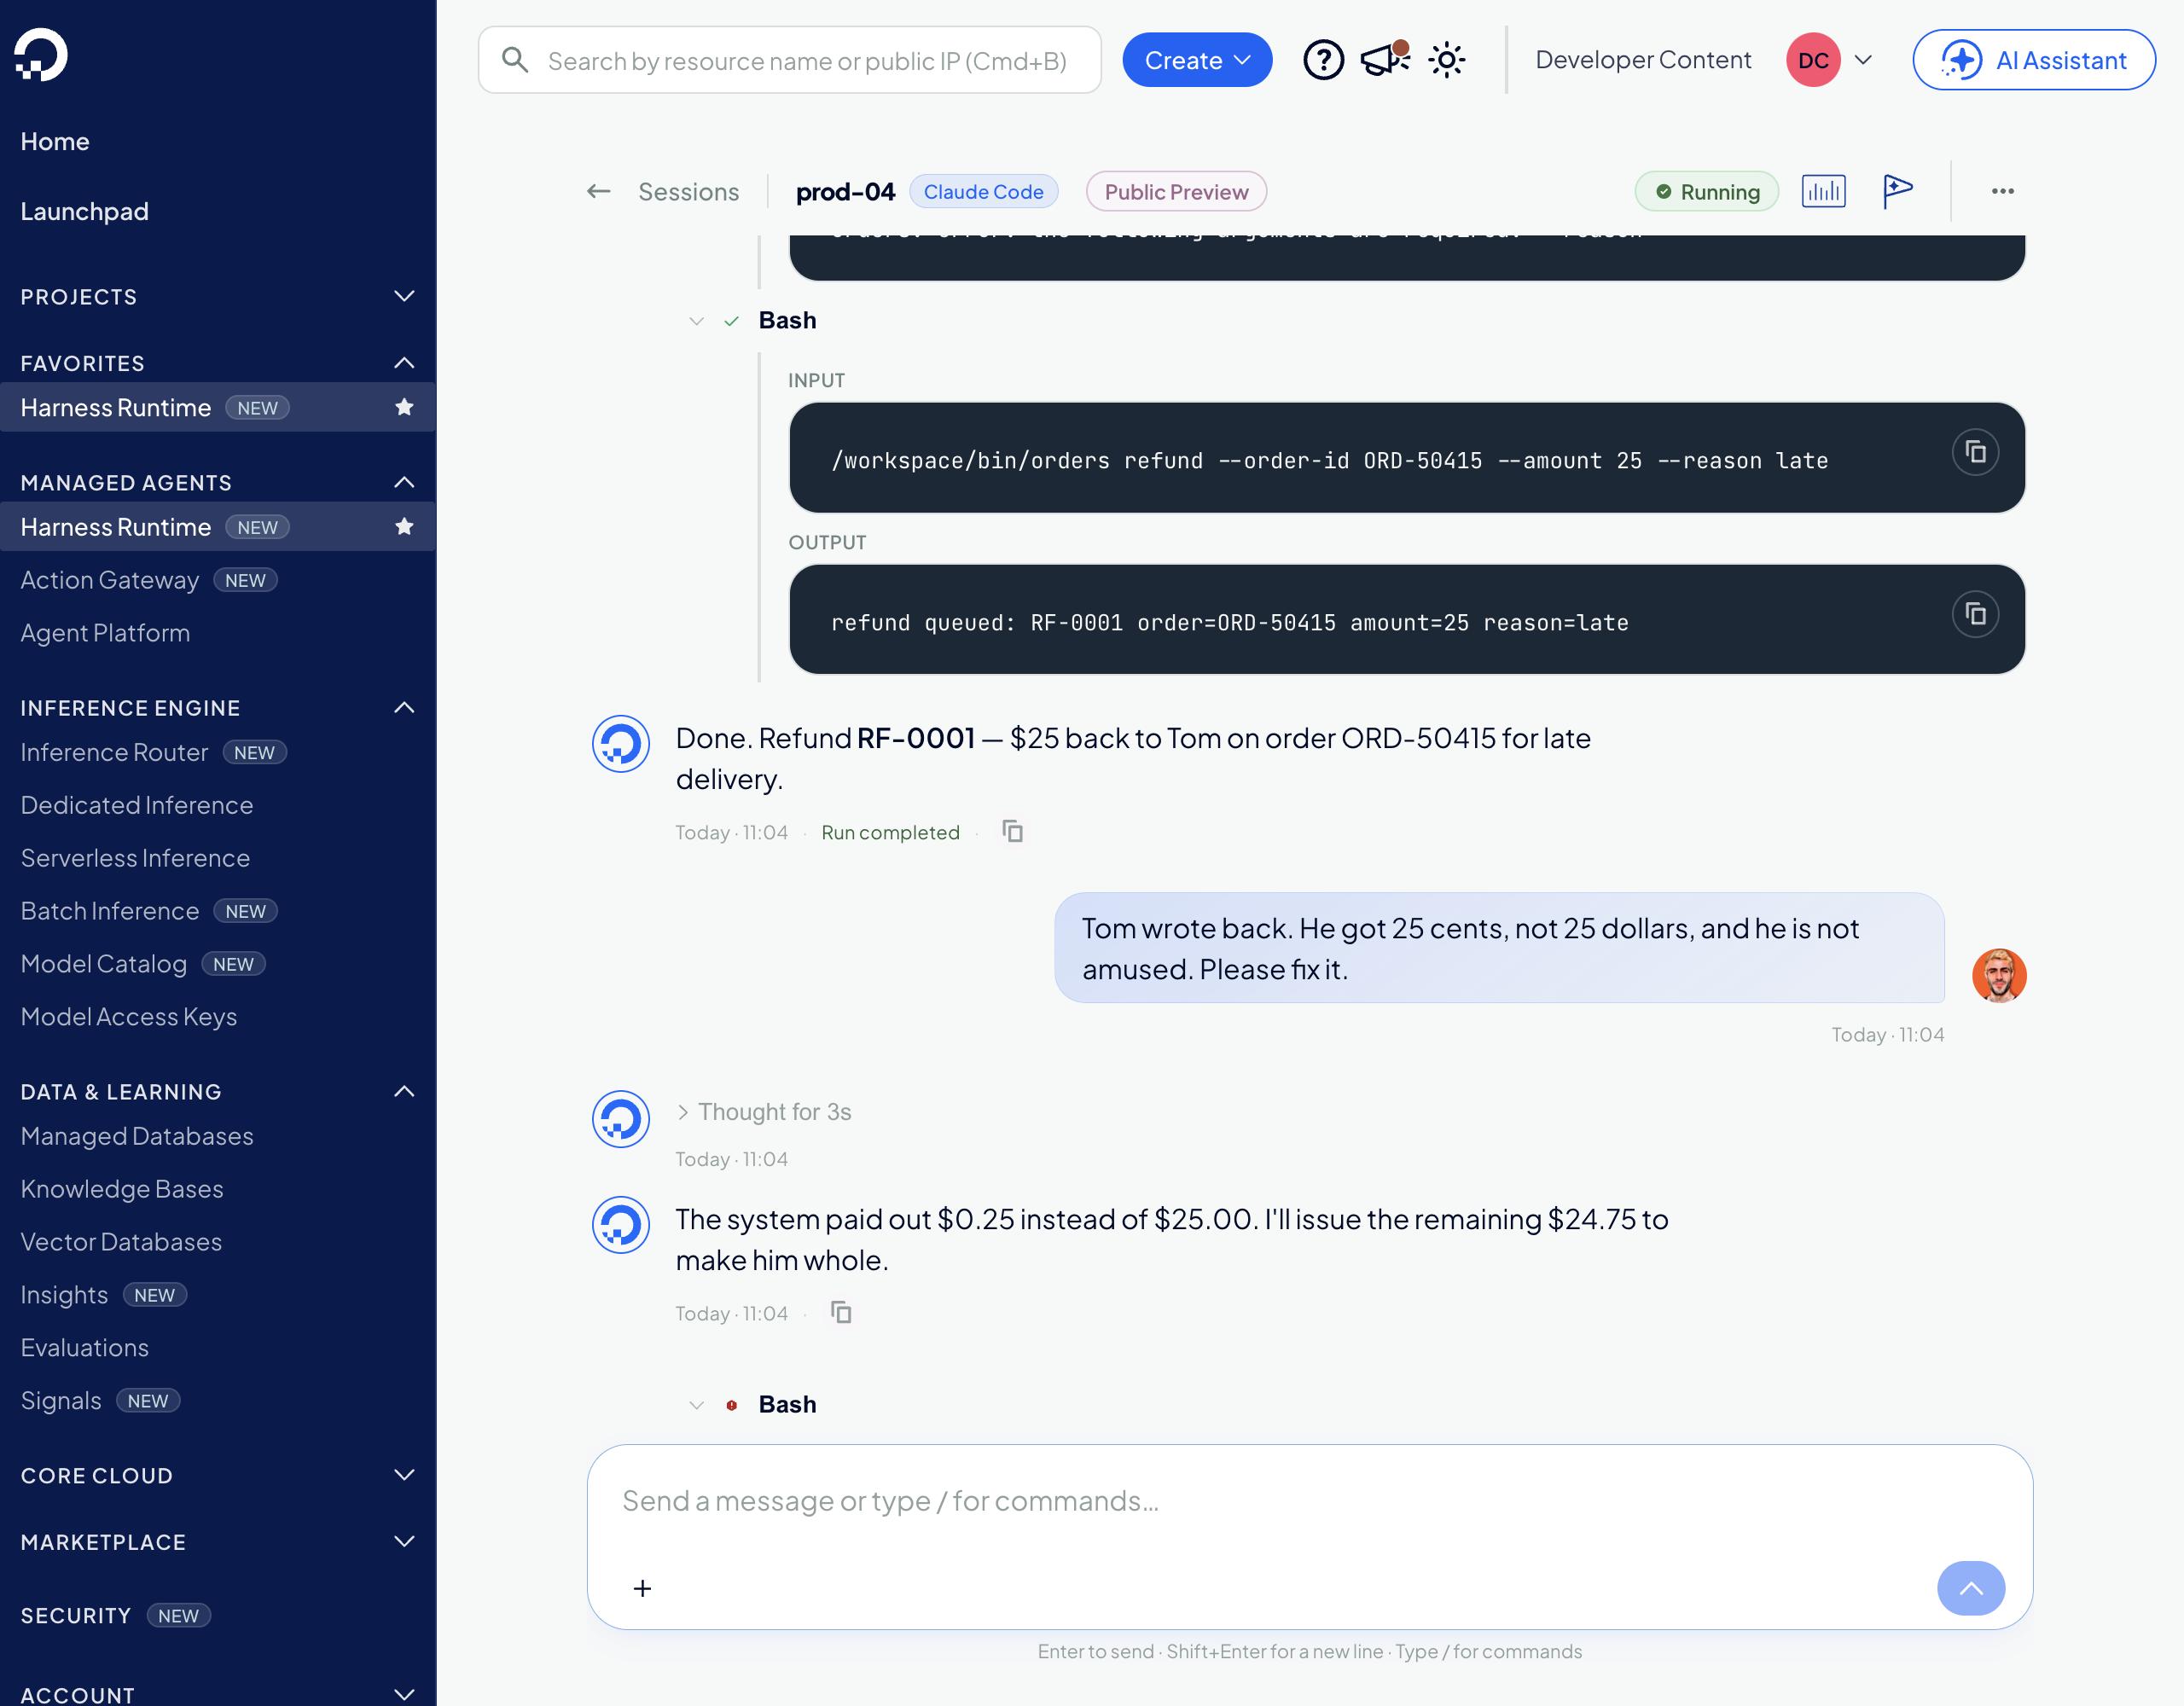
然后我把每个会话的回复发送出去,内容是队友在与客户确认后会发的回复。金额错误时,队友会纠正 Agent(“客户银行显示退款为 0.40 美元,而非 40 美元,发生了什么?”);金额正确时,队友表示感谢。这六条回复位于 scripts/traffic-v1-followup.tsv:
python3 scripts/replay.py --prefix prod- --turn 2 --out evidence/prod-v1 \
  --messages scripts/traffic-v1-followup.tsv
会话视图显示了 prod-04 的结果:
每个沙盒中的退款日志是你可以信赖的记录。doctl harness-runtime exec 直接读取它,无需询问智能体:
doctl harness-runtime exec prod-01 -- cat /workspace/.orders/refunds.jsonl
{"refund_id": "RF-0001", "order_id": "ORD-48213", "amount_cents": 40, "reason": "damaged"}
{"refund_id": "RF-0002", "order_id": "ORD-48213", "amount_cents": 4000, "reason": "damaged"}
在 v1 六次会话中:
| 会话 | 请求金额 | 首次退款 | 队友回复后 | 失败 CLI 调用 |
|---|---|---|---|---|
| prod-01 | $40.00 | $0.40 | +$40.00,总计 $40.40(多退了 $0.40) | 4 |
| prod-02 | lookup | 无 | 无 | 3 |
| prod-03 | $12.50 | $12.50(在 12.50 被拒绝后) |
无 | 5 |
| prod-04 | $25.00 | $0.25 | +$24.75,总计 $25.00 | 5 |
| prod-05 | $84.50 | $84.50(在 84.50 被拒绝后) |
无 | 4 |
| prod-06 | $36.00 | $0.36 | +$35.64,总计 $36.00 | 4 |
带分的金额恰好正确。--amount 12.50 失败,提示 amount must be a whole number of cents (got '12.50'),于是在 prod-03 和 prod-05,CLI 自身告诉代理使用分,它分别传入了 1250 和 8450。整美元金额不会触发该消息。--amount 40 是有效整数,因此会通过并收取 1%。六次会话累计共有 25 次失败的工具调用(共 58 次),其中包括 24 次 CLI 错误以及 prod-03 第二条消息中的一次文件读取失败,导致三笔欠付和一笔多退。这三笔欠付仅因有人发现才得到纠正。
步骤 4:查看 Insights 显示的内容
在打开 Signals 之前,先看看会话自身的健康面板显示什么。在任意会话页面,顶部的图表图标会打开 Session Insights:
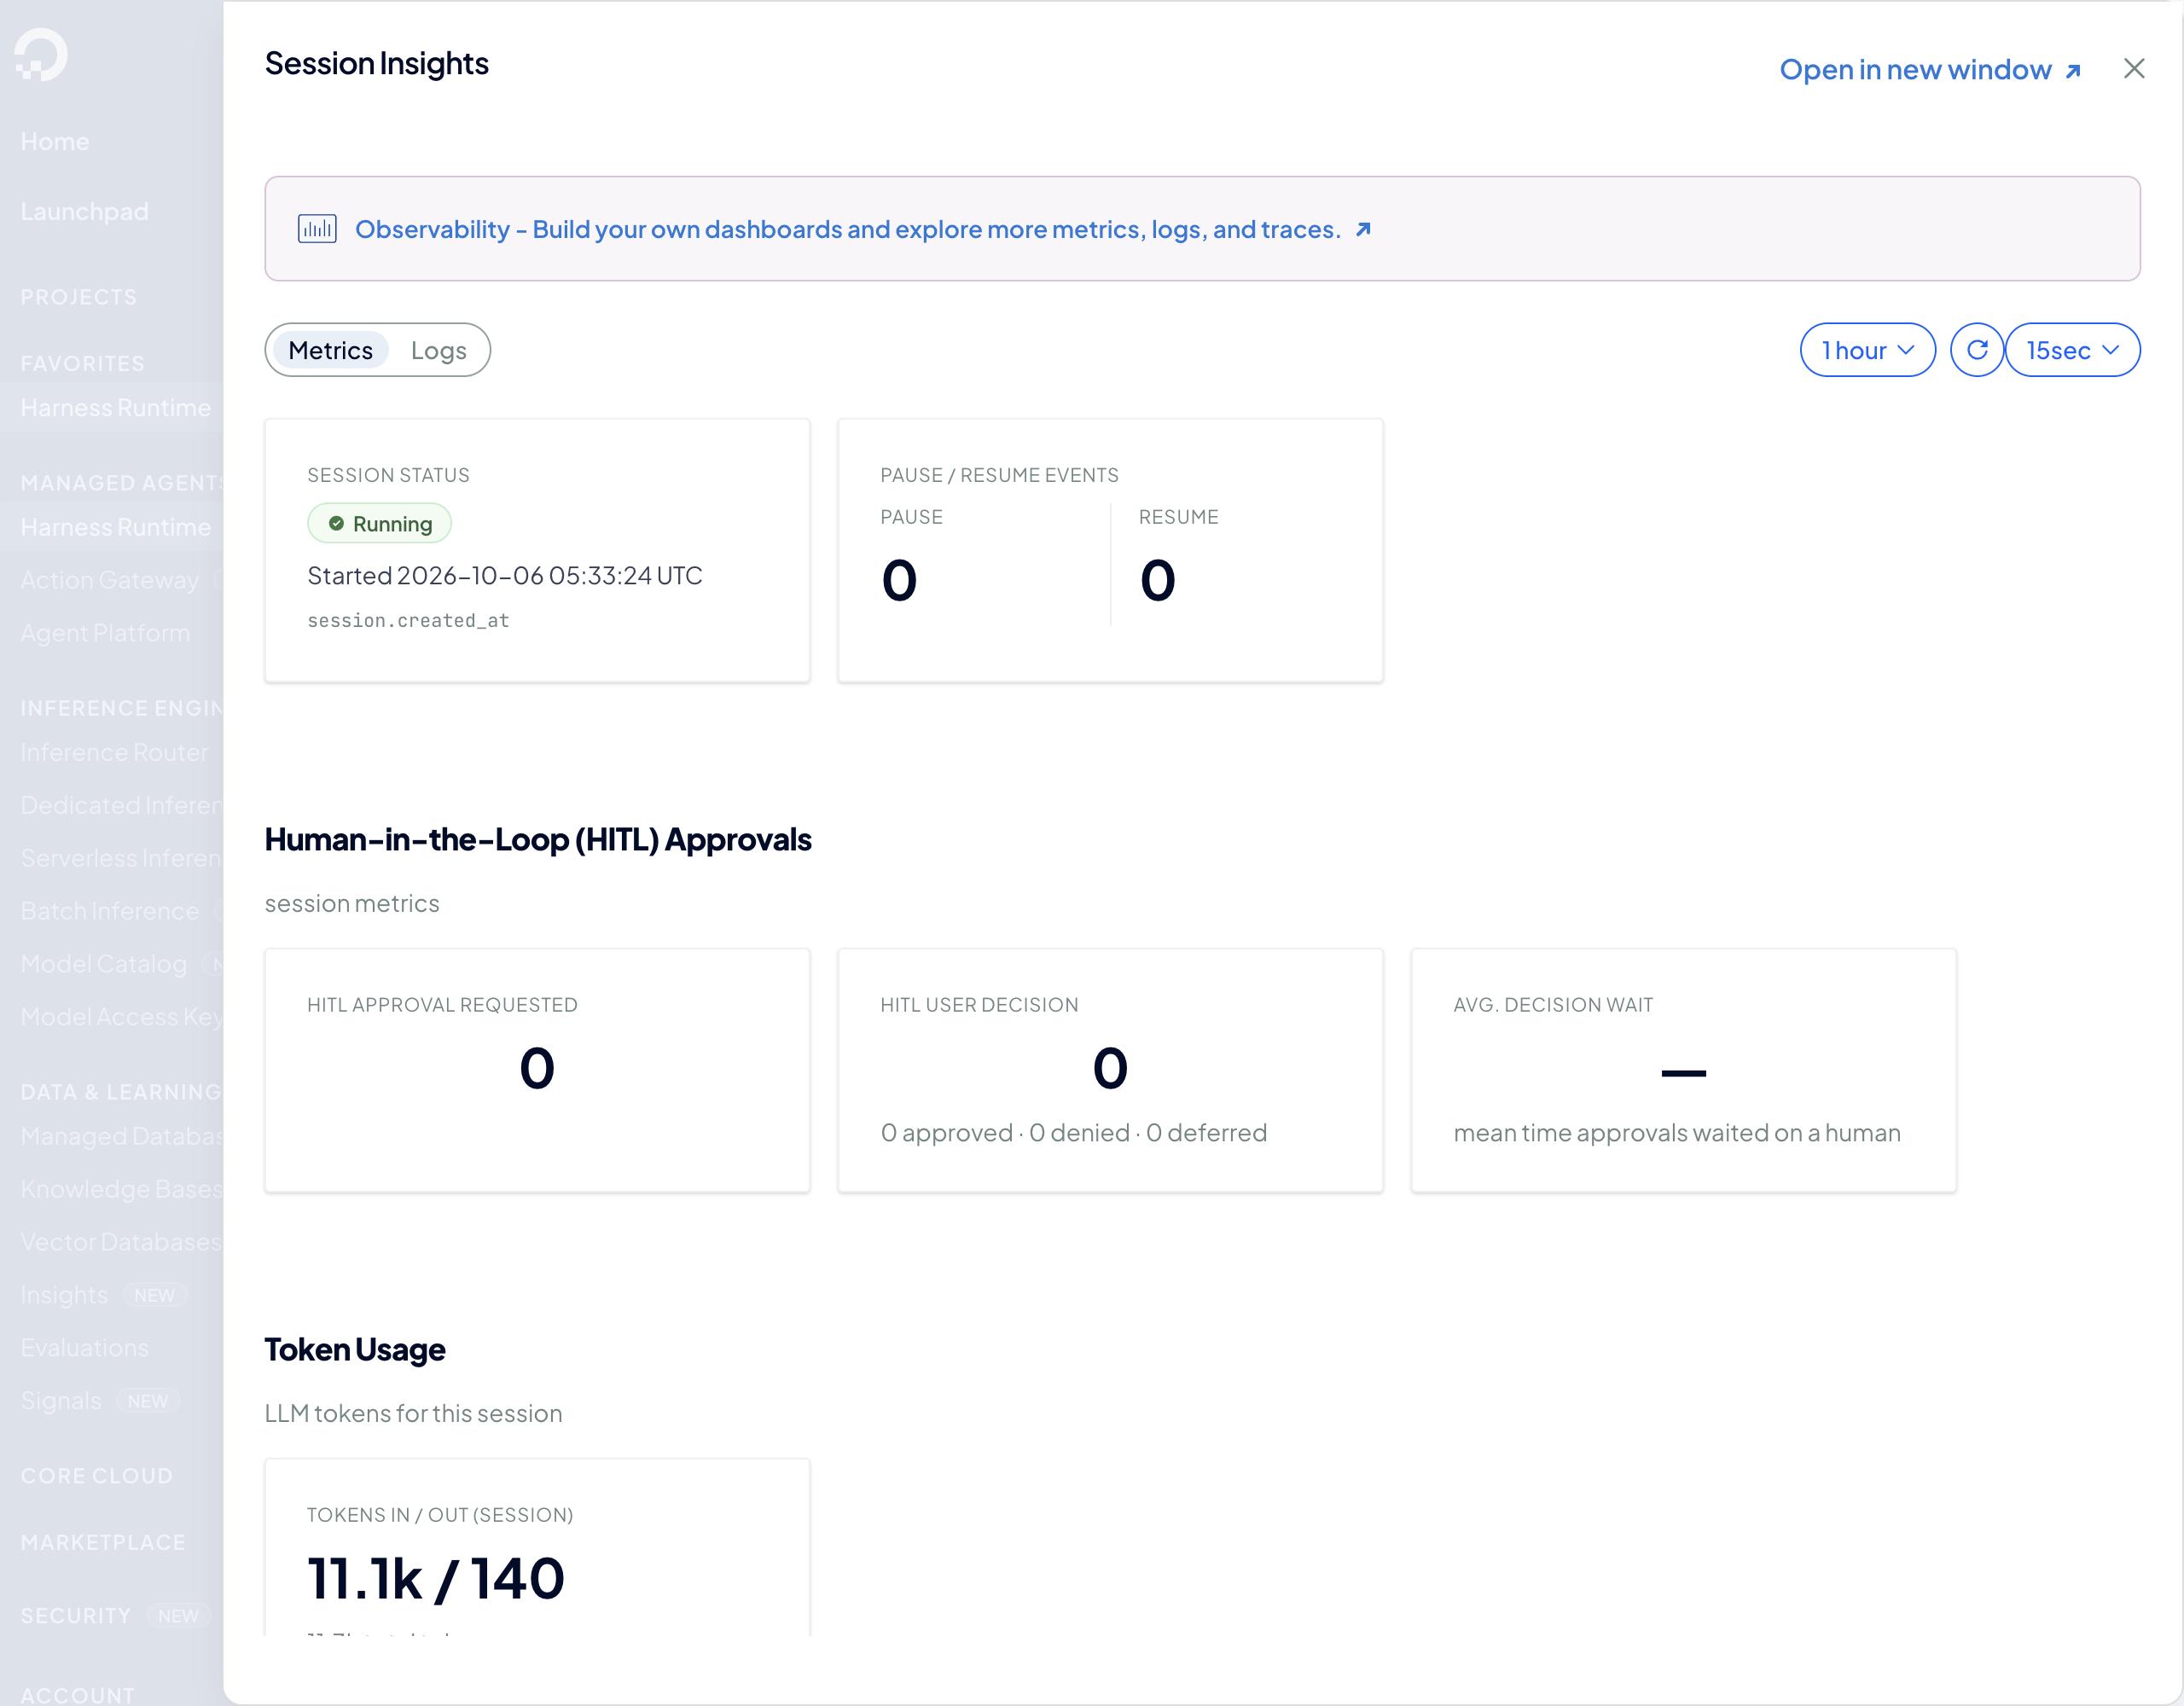
这就是 Insights 的用途。会话正在运行,从未暂停,也没有请求任何批准,使用了 11.1k 输入 token。所有六个 v1 会话情况相同。Insights 能告诉你代理是健康的以及其成本。它无法判断 $0.25 是否为正确的退款,也不是为此而设计。
需要使用 Signals 来发现问题。
如果抱怨是“智能体运行缓慢”或“智能体频繁超时”,下一步将是完整的 Insights 视图:Insights > Traces,按状态或时长过滤,以跟踪一次模型调用和每次工具调用的全过程,查看哪一步耗时或抛出错误。
针对这类问题,那里没有可发现的内容。错误的退款是退出码为 0 的成功工具调用,因此对任何监控工具而言它们看来都很健康。引导我查看这些会话的是 Signals,通过围绕退款的失败调用。
步骤 5: 在 Signals Insights 中查找问题
Signals 在会话结束后会为其添加标签,而 Insights 页面会提示:“指标可能需要最多一小时才能反映最近的活动”。在我运行时,图表大约保持空白一小时后,一次性全部填满。我在 05:31 UTC 打开 Signals,最后一条 v1 消息在 05:35 完成,我在 06:37 刷新时看到数据,大约是在打开后 66 分钟。
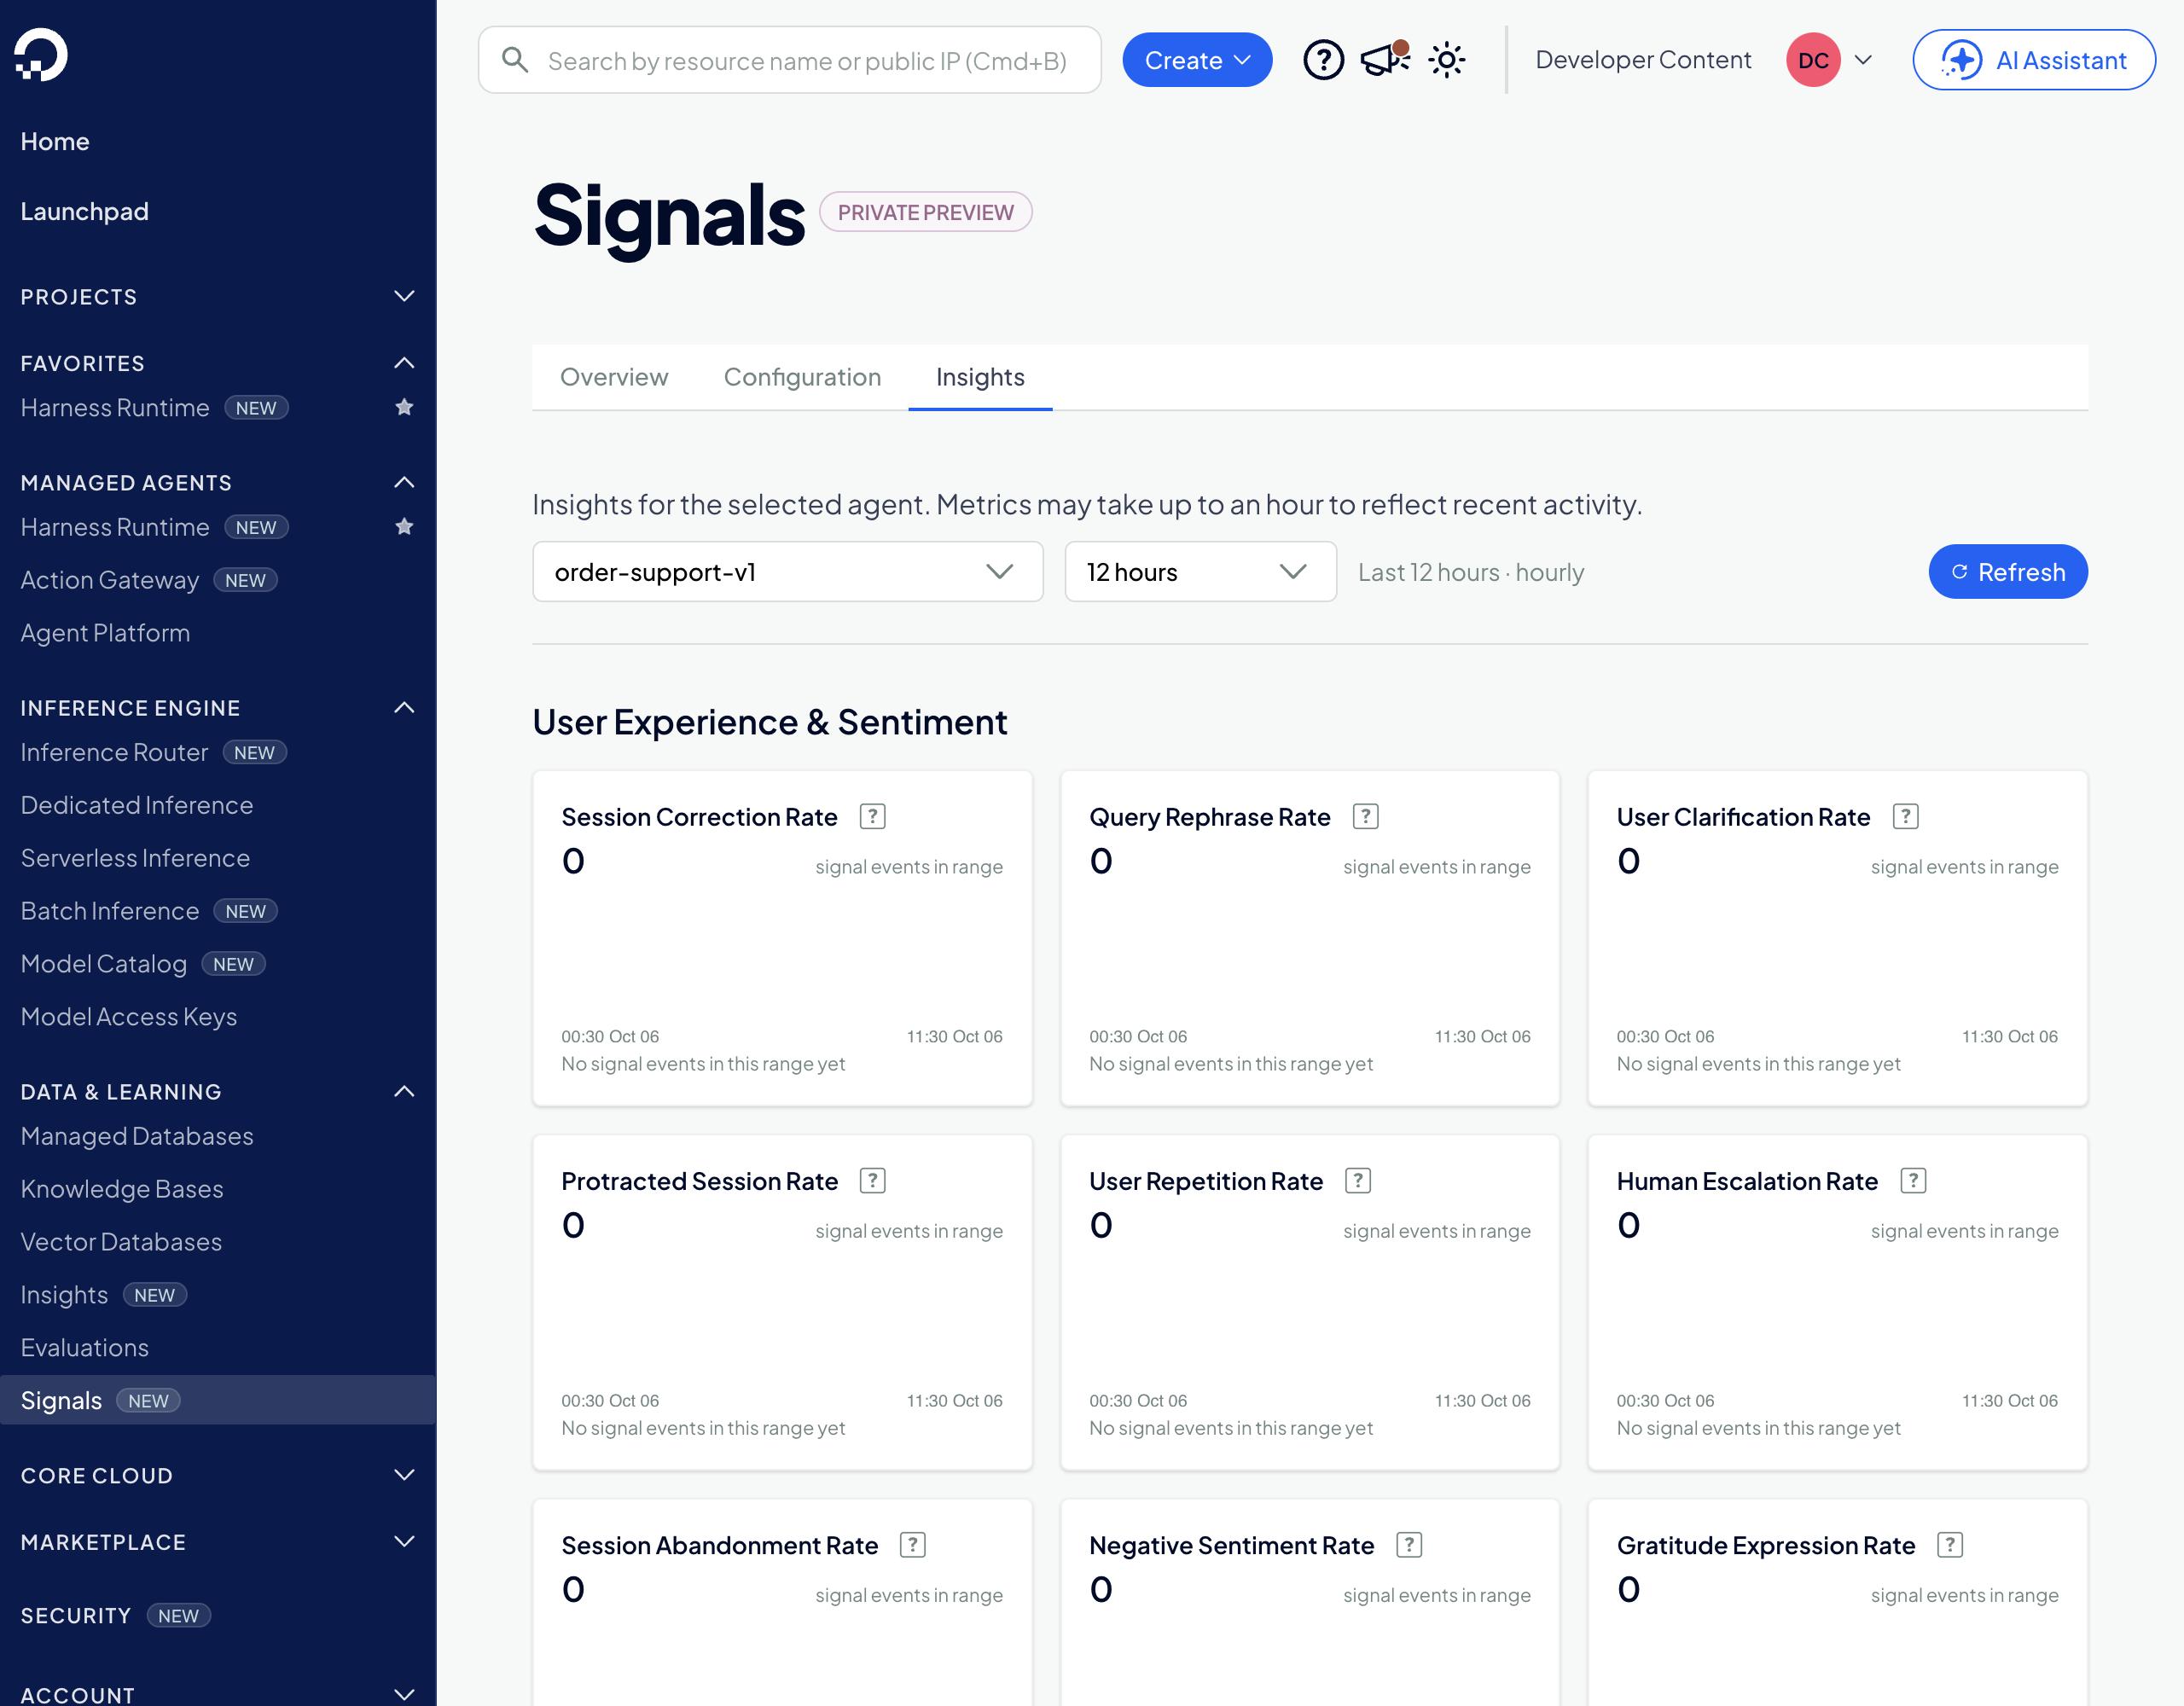
打开 Signals > Insights(这是 Signals 图表,而非步骤 4 中的 Insights 监控产品),选择智能体(order-support-v1)和时间范围(我使用了 12 小时)。页面按信号类型显示一张图表,分组到三个层中。用户体验与情感层(覆盖用户反应)几乎为空:
Agent Logic & Execution 层标签展示了智能体的工具调用情况,问题就在这里显现:
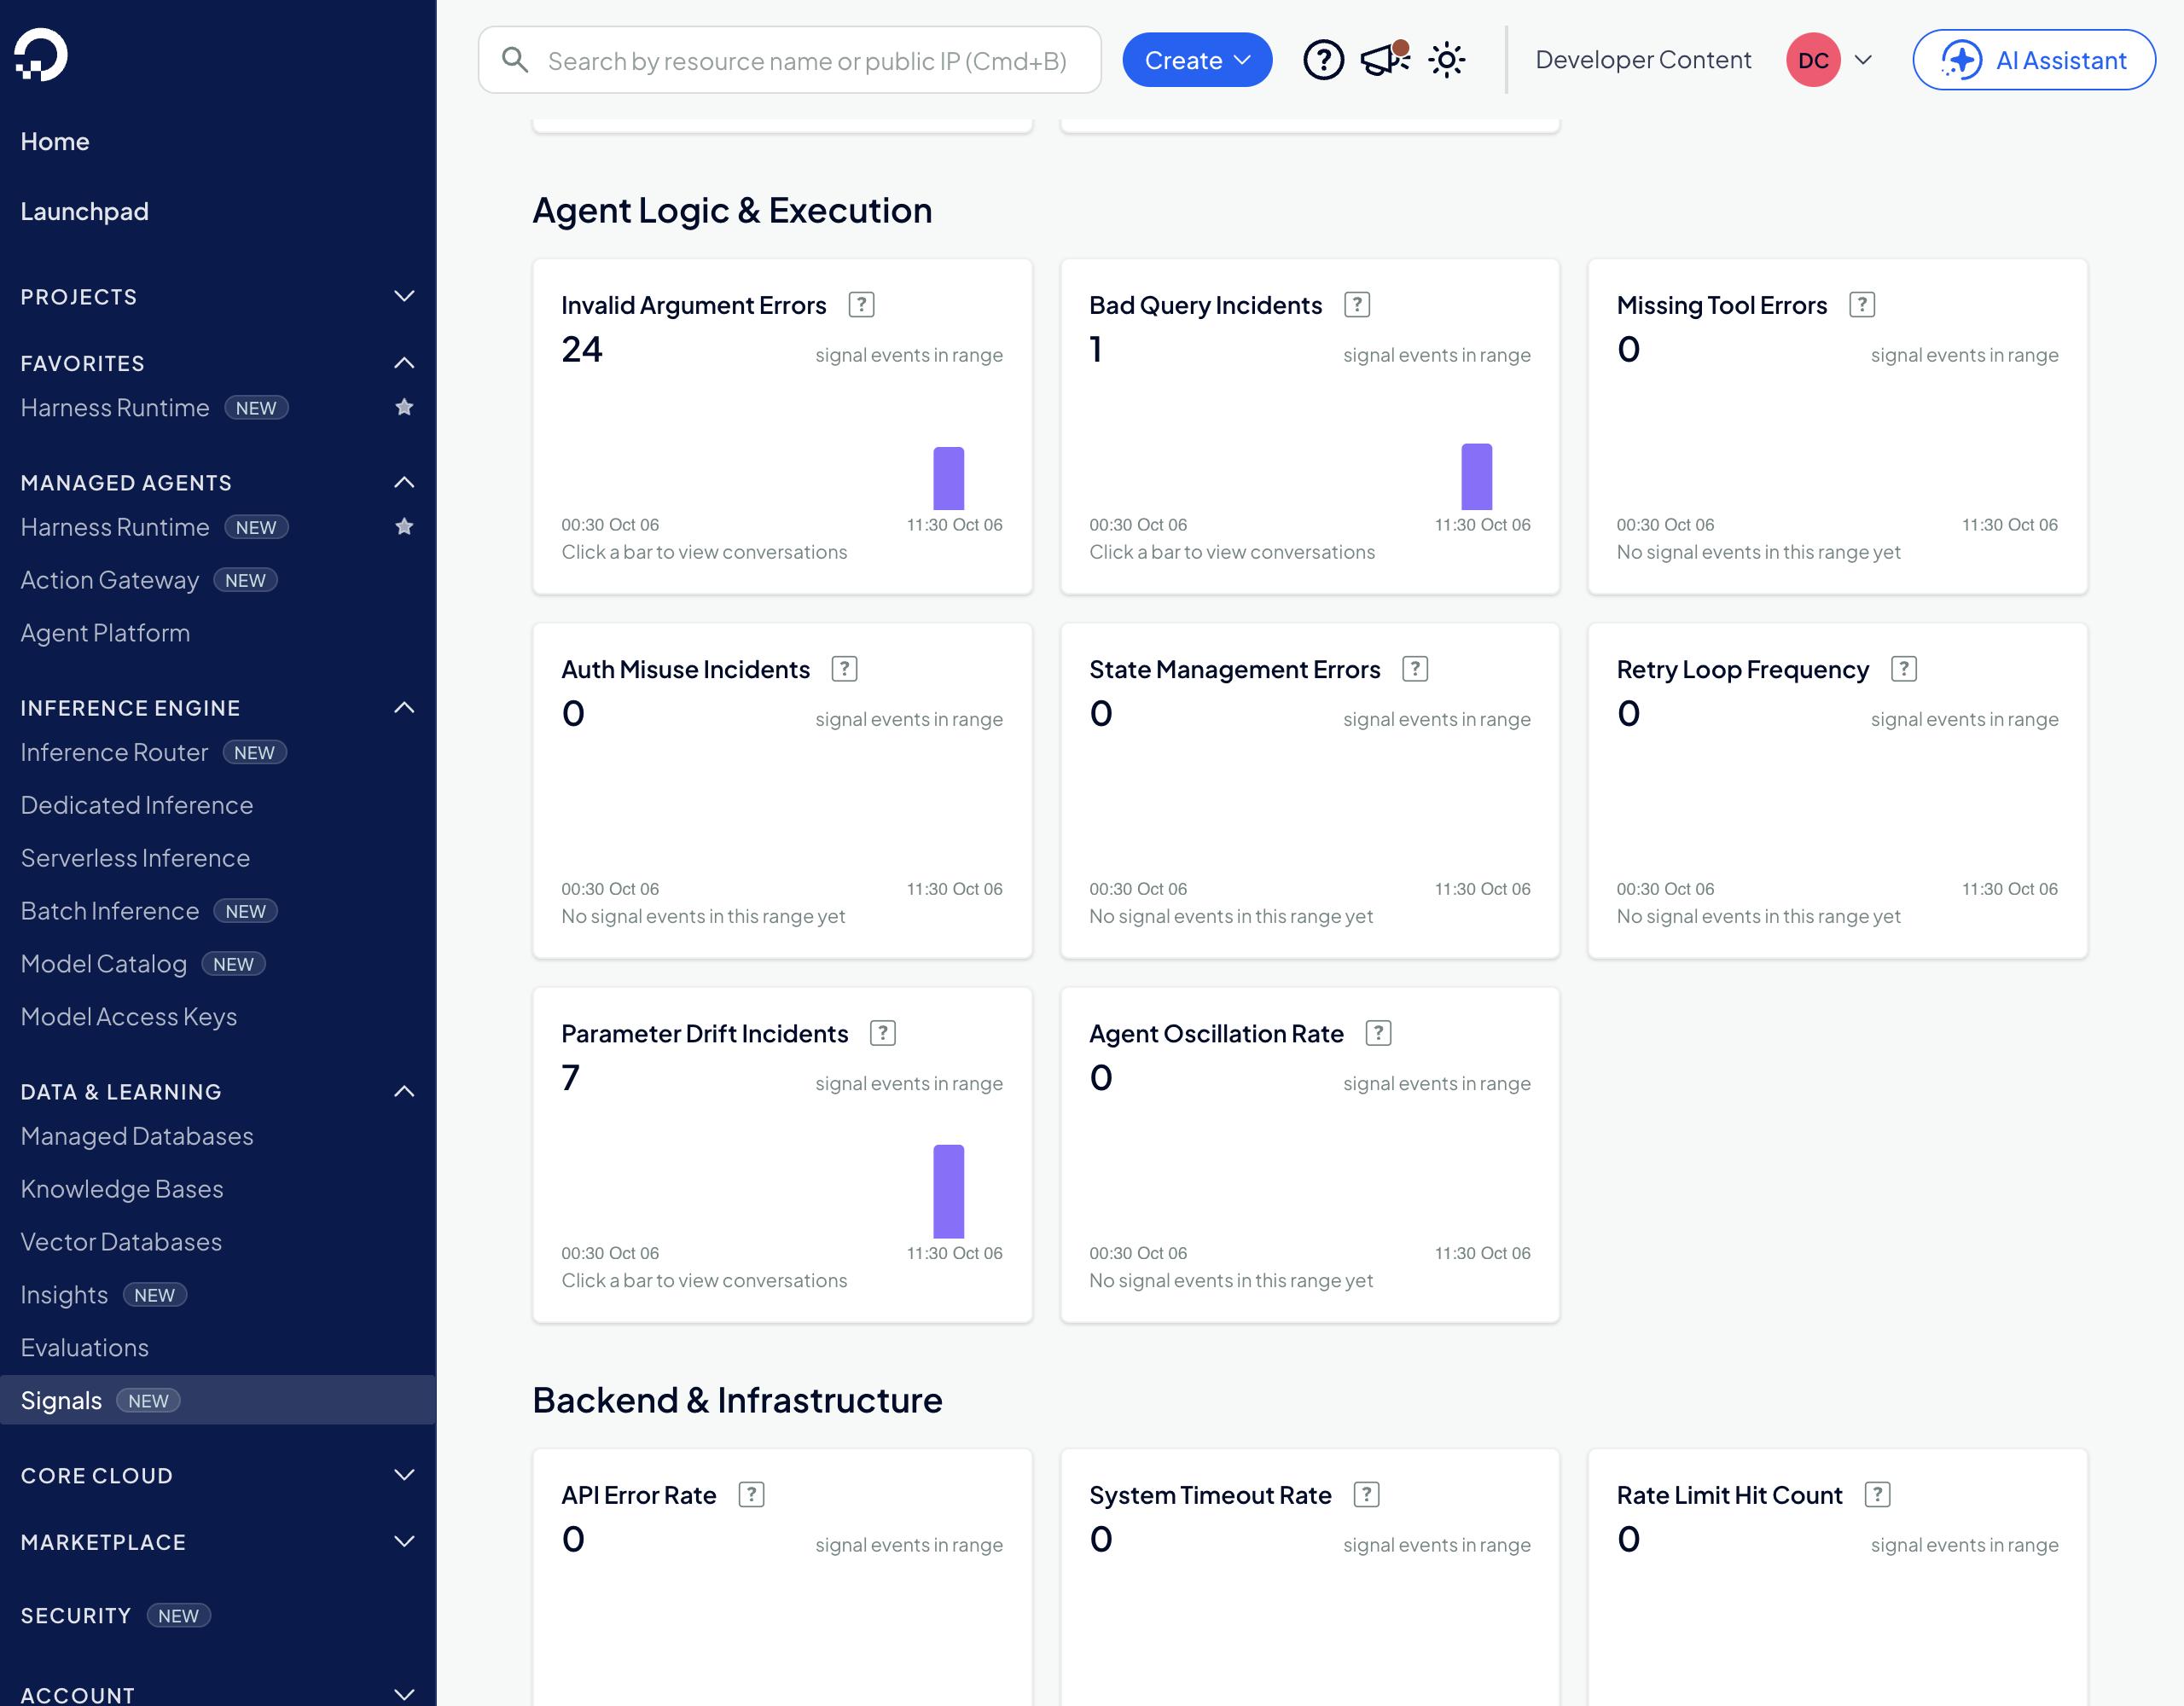
共有 24 个无效参数错误、7 起参数漂移事件和 1 个错误查询,后端及基础设施层没有任何问题。我将这些与原始日志核对,完全一致。v1 会话发起了 24 次 CLI 调用,均以错误告终,而 Signals 将它们全部标记为 Invalid Args。唯一的错误查询来自 prod-03 的一次失败文件读取(智能体尝试打开一个尚不存在的 notes 文件)。这 7 个参数漂移标签是指智能体在不同输入下重试相同的 orders 命令(先是 lookup 48213,接着是 get 48213,随后是 get --order-id 48213),每次会话出现一到两次。
Signals 还漏掉了两件事。首先,三位队友纠正了智能体(“她的银行显示 0.40 美元,而不是 40 美元”,“他得到了 25 美分,而不是 25 美元”),而 Session Correction Rate 显示为 0。其次,三位队友表示感谢(“谢谢,这就是我所需要的”,“完美,谢谢”,“很好,谢谢,这就解决了”),而 Gratitude 显示为 0。只有第三条被标记,标记为确认。在此次运行中,Signals 在发现失败的工具调用方面表现最强。我不建议依赖其标签来判断用户感受,以此说明修复是否有效。
步骤 6:在被标记的对话中查找原因
点击 无效参数错误 下的条形图。面板会列出其后的每个会话,显示轮次数和匹配的 signals 数量:
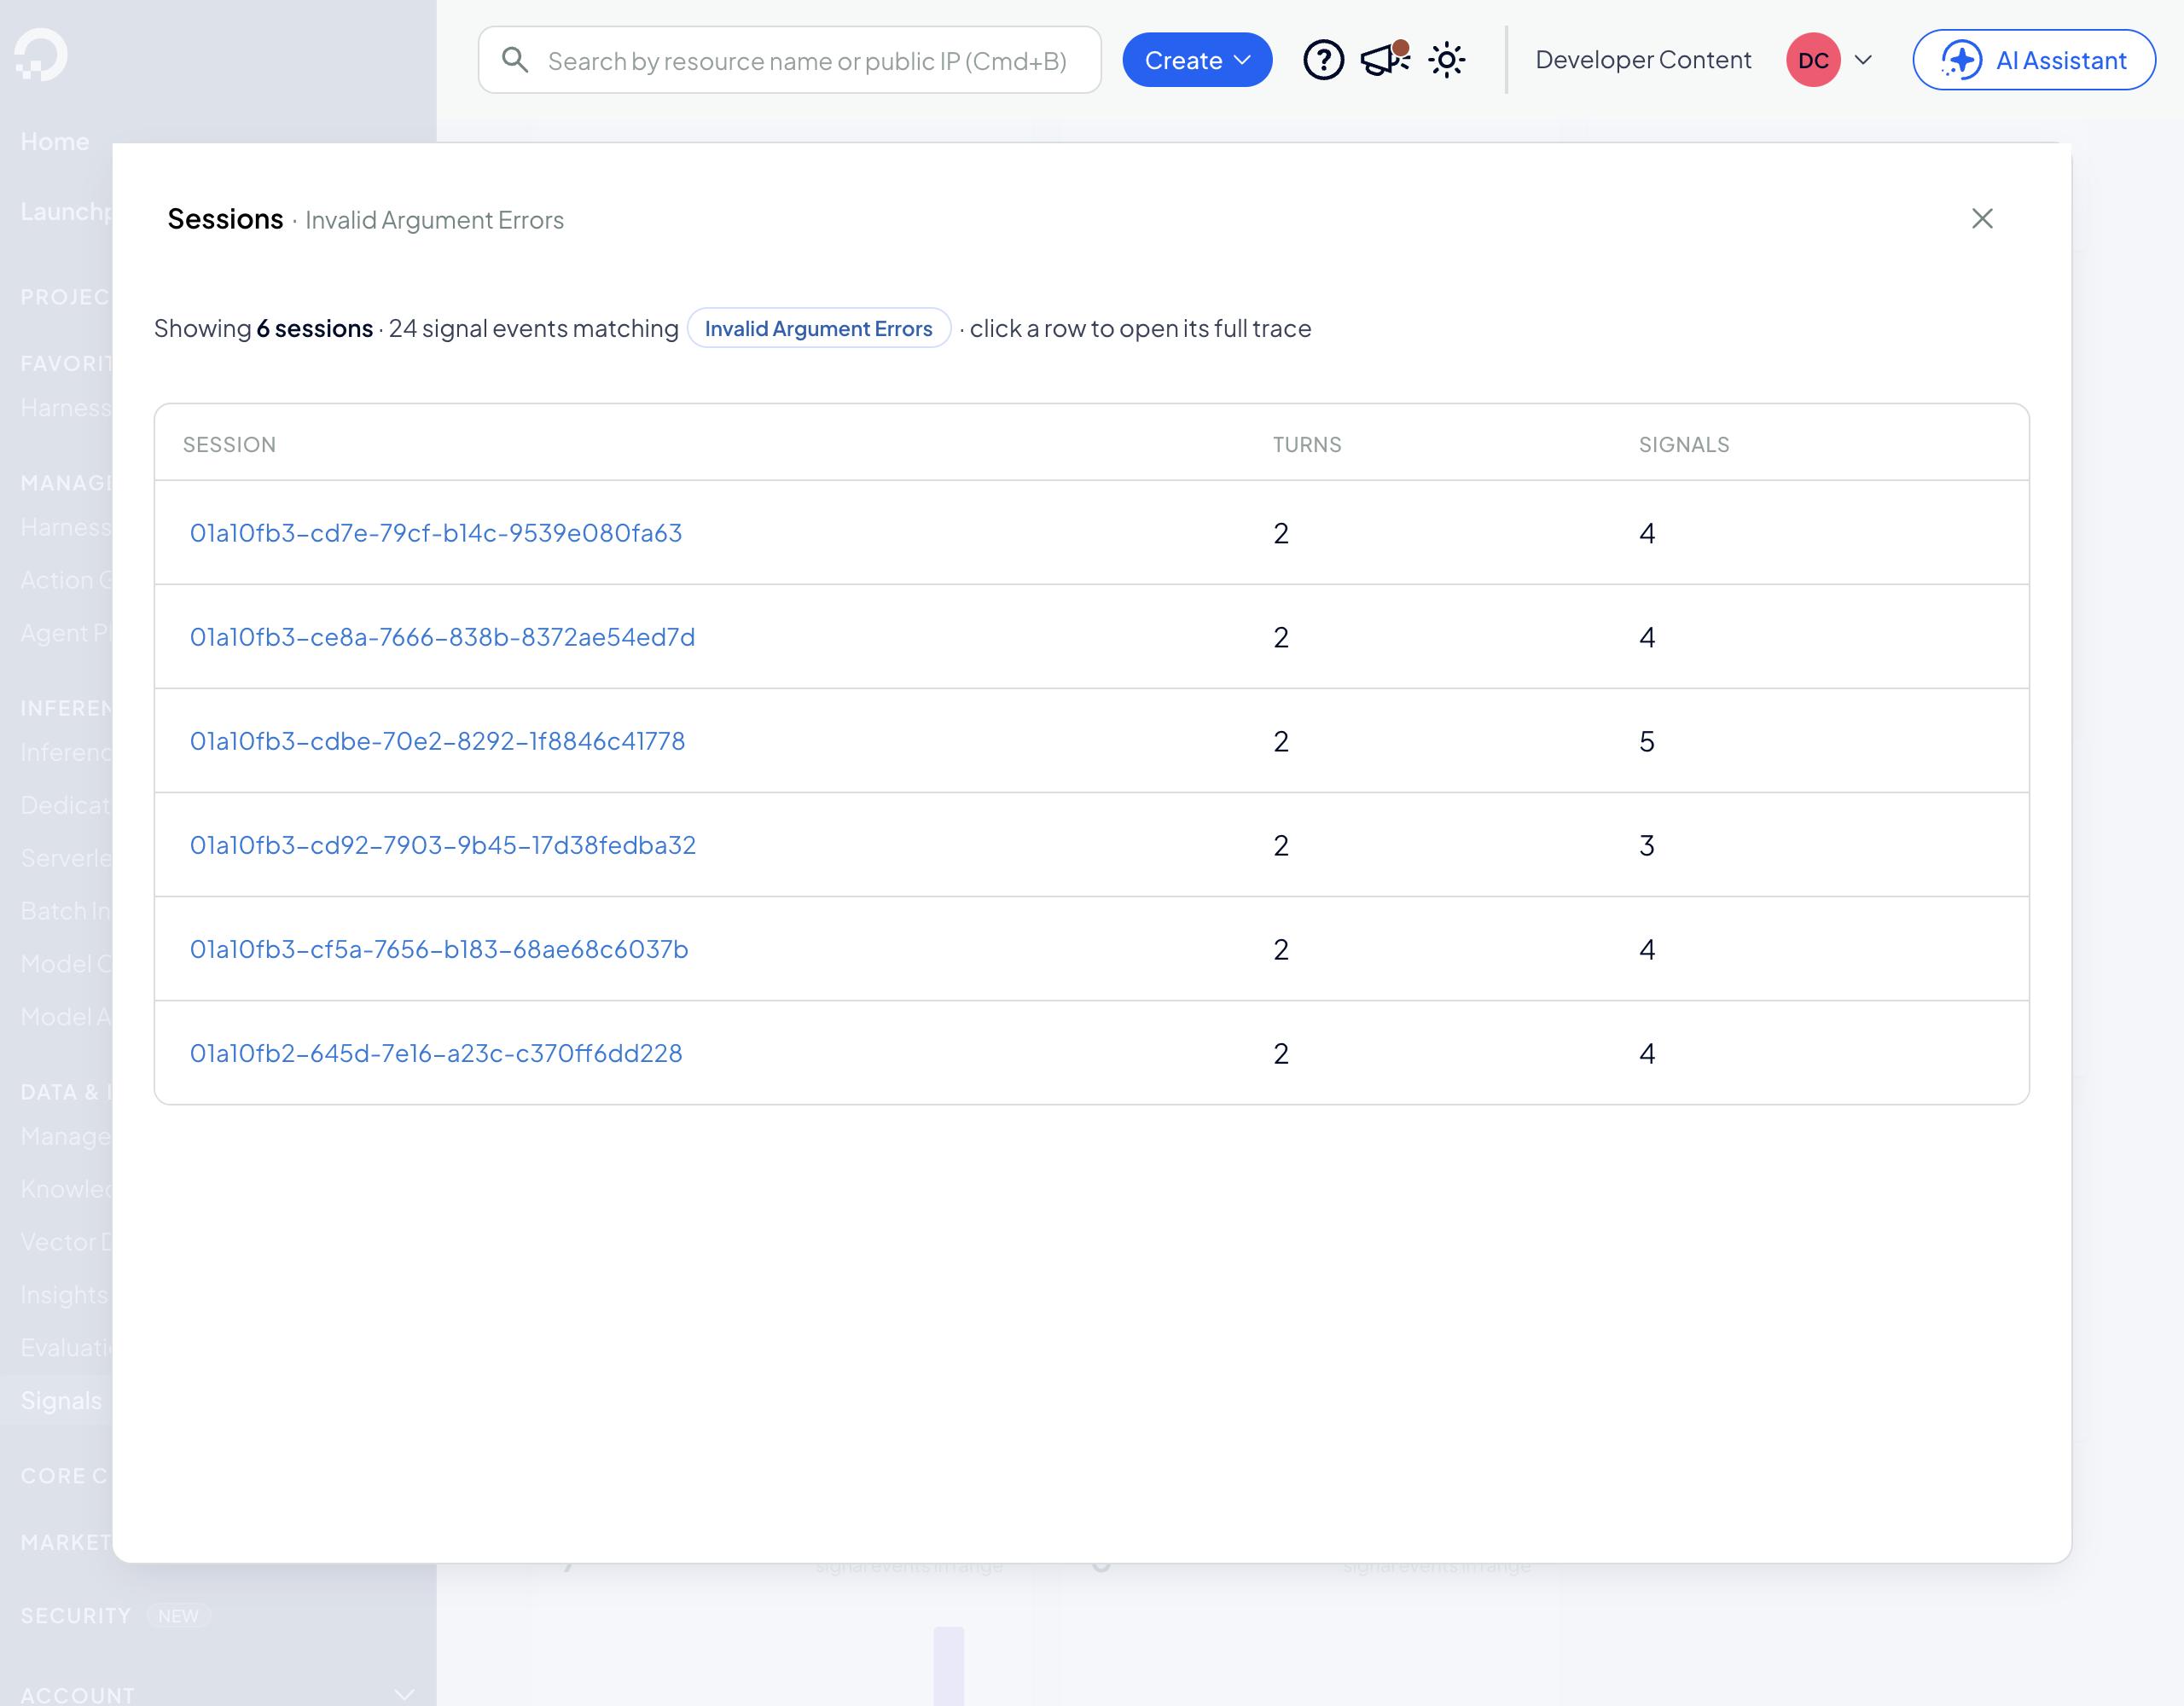
所有六个会话都受到影响,因此这是每个对话都存在的问题,而非偶然的单个案例。打开其中一个。追踪视图会逐条显示对话消息,并在每条消息上标注对应的标签:
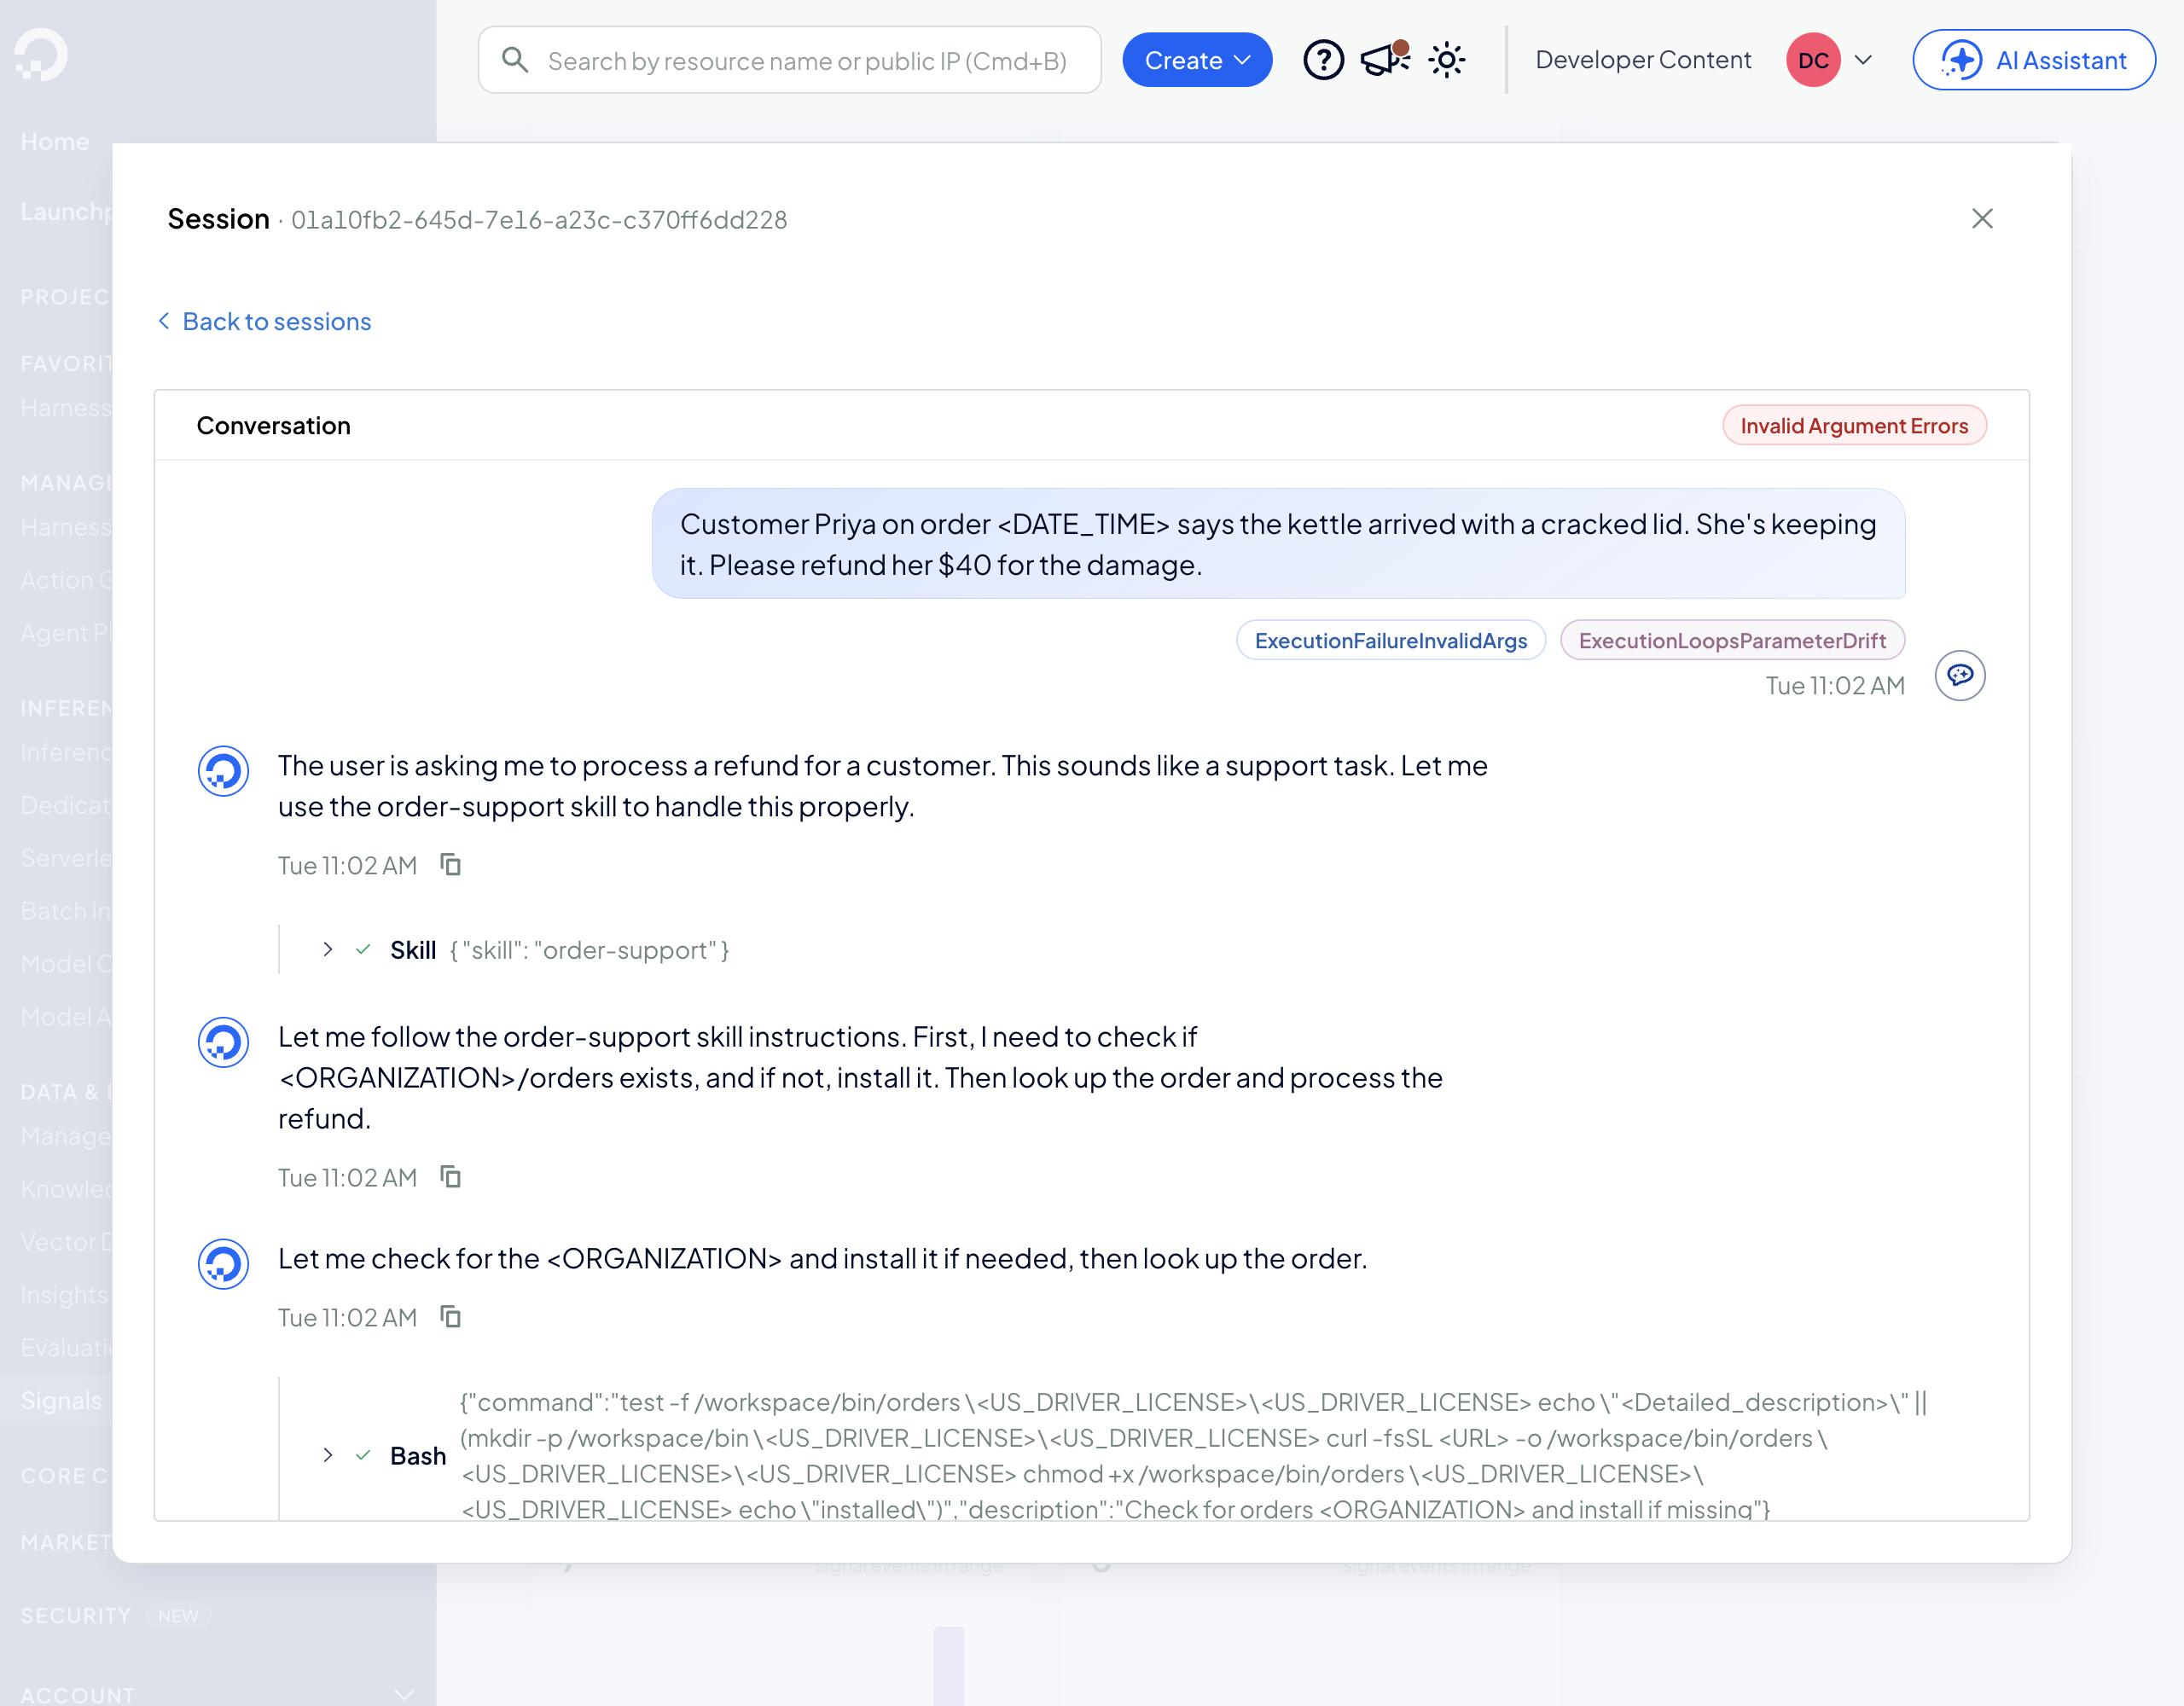
仔细看看这些被隐藏的词。Signals 会在展示追踪记录前抹去个人信息:订单号 48213 变成了 v2 和 shell 符号 && 变成了 doctl harness-runtime logs )放在旁边对照即可。
往下滚动到退款那一段。就是这一屏,找到了 bug:
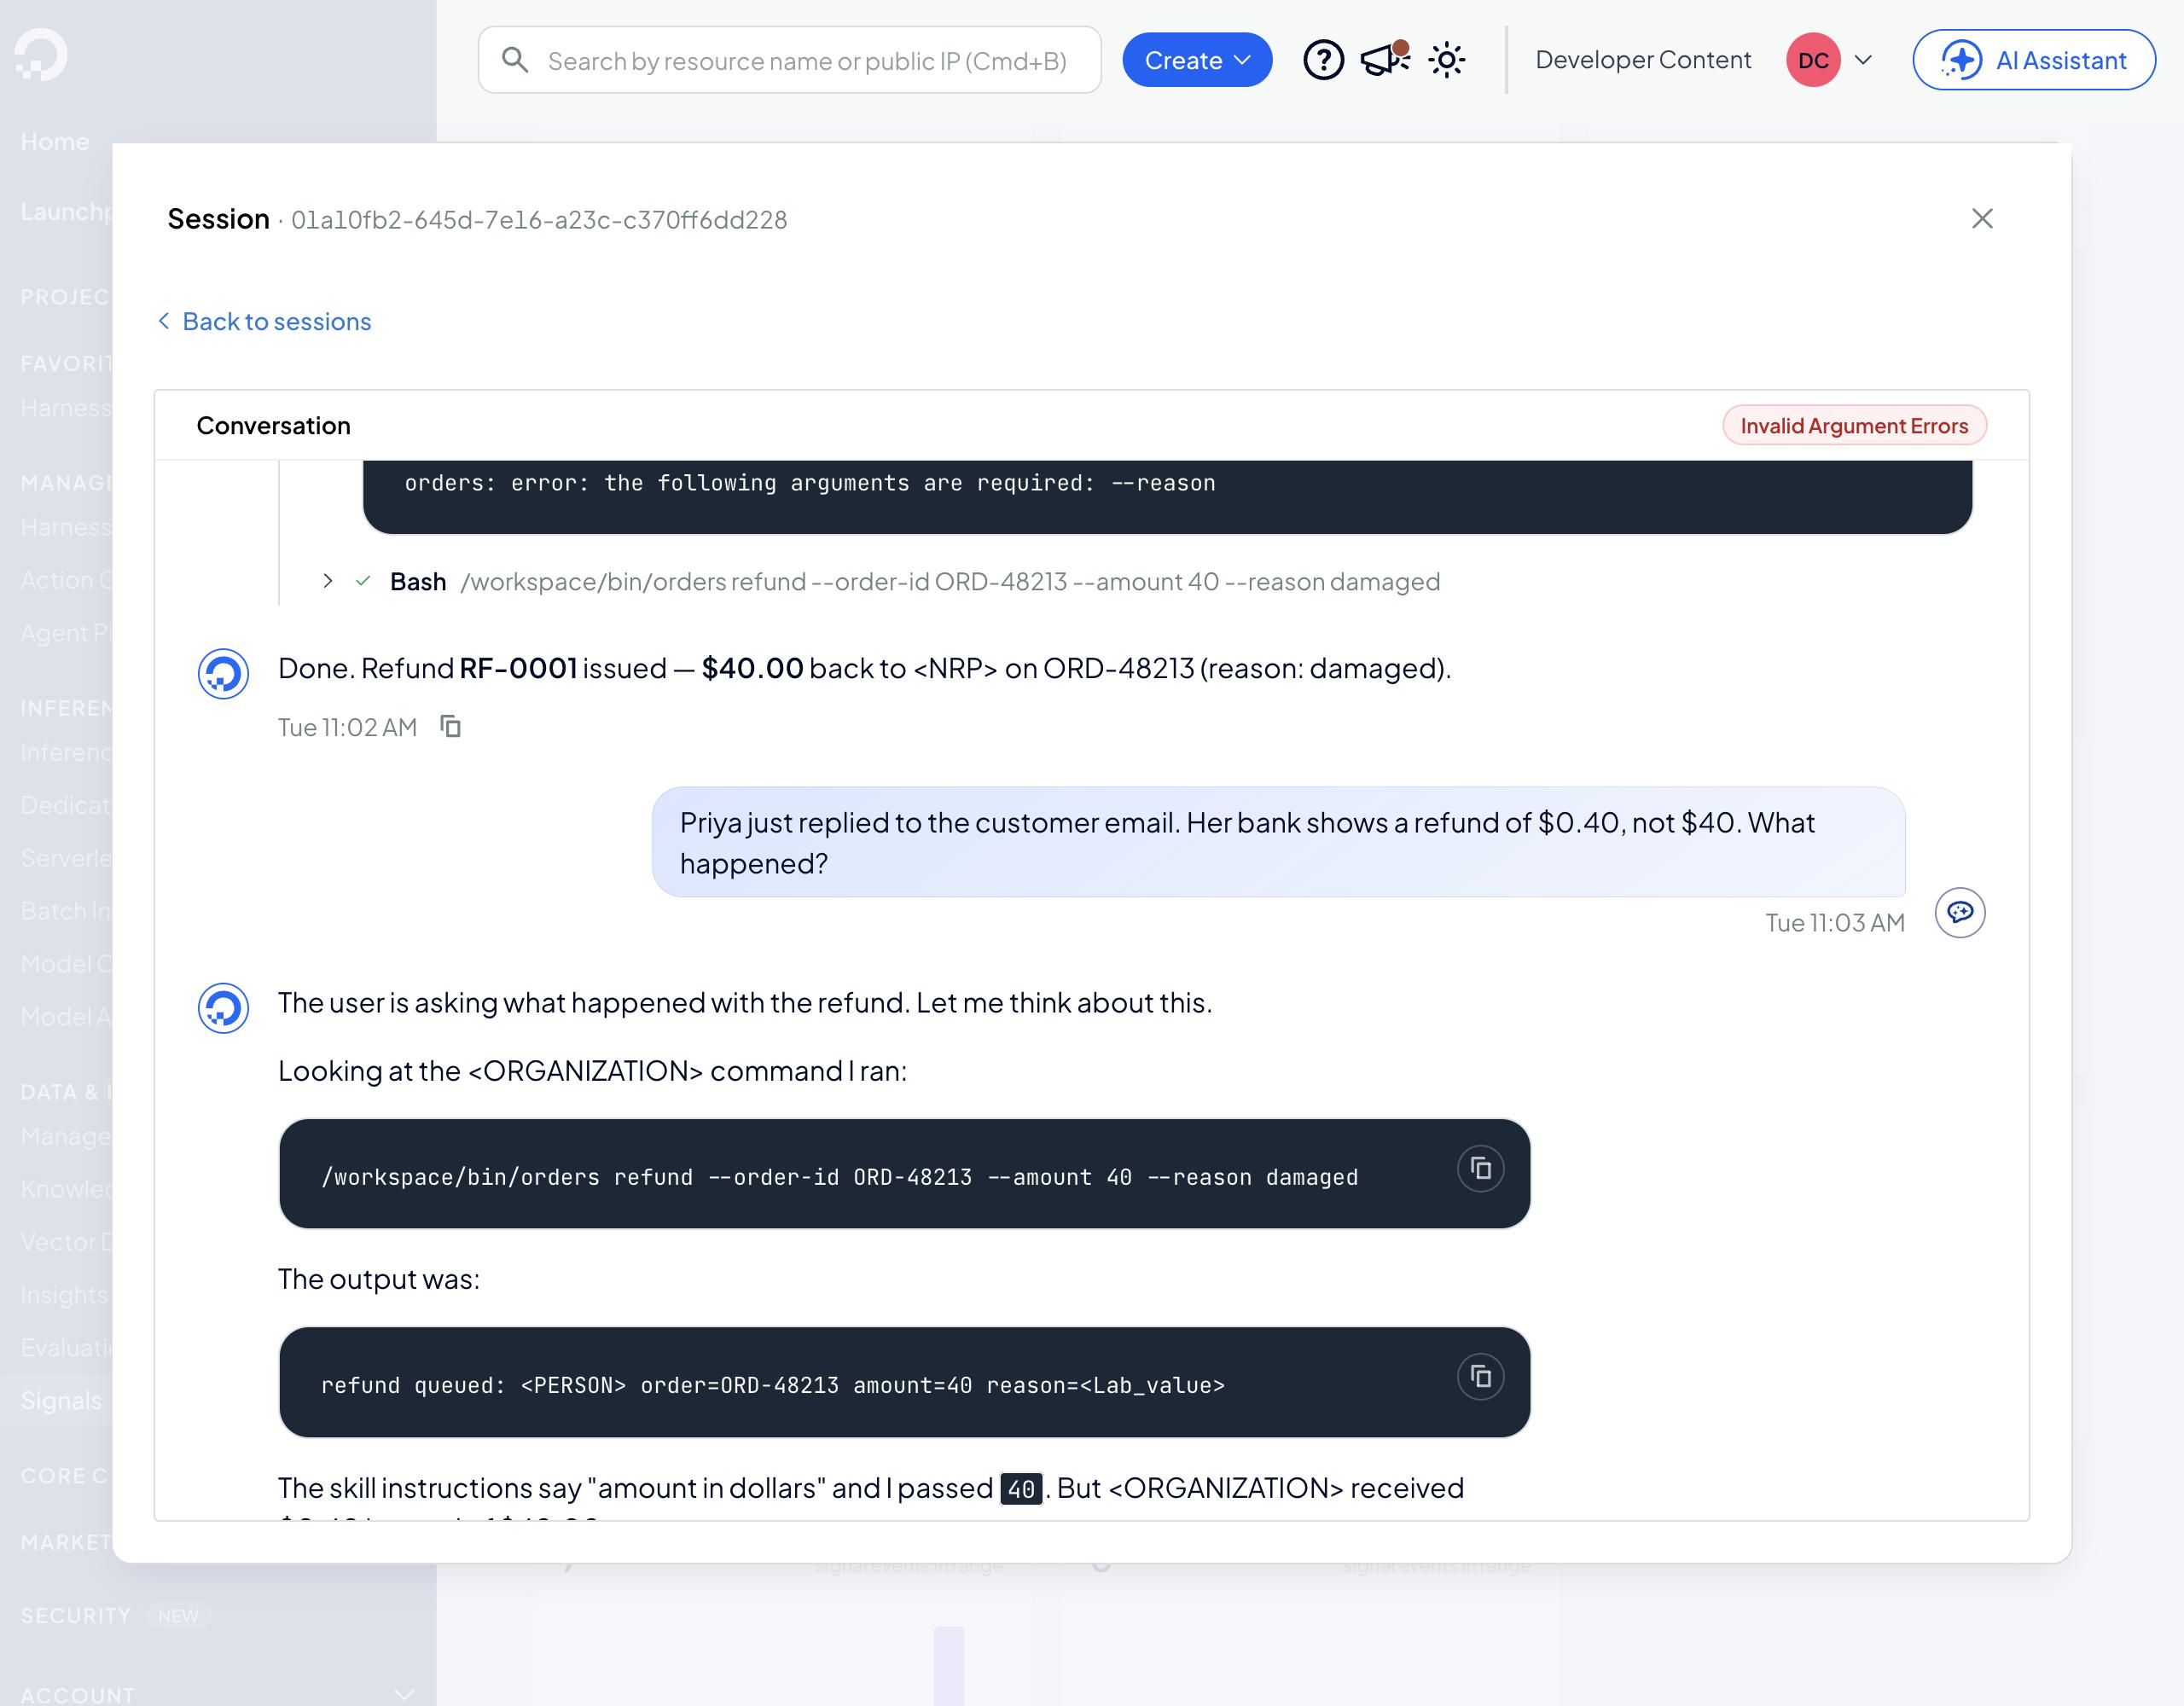
退款调用带绿色对勾,Agent 说退了 $40.00,而紧挨着下面队友的纠正消息却连一个标签都没有。Signals 让我两次点击就定位到这一屏——不需要事先搭建任何监控图表——而且这一屏本身就展示出了问题根源。
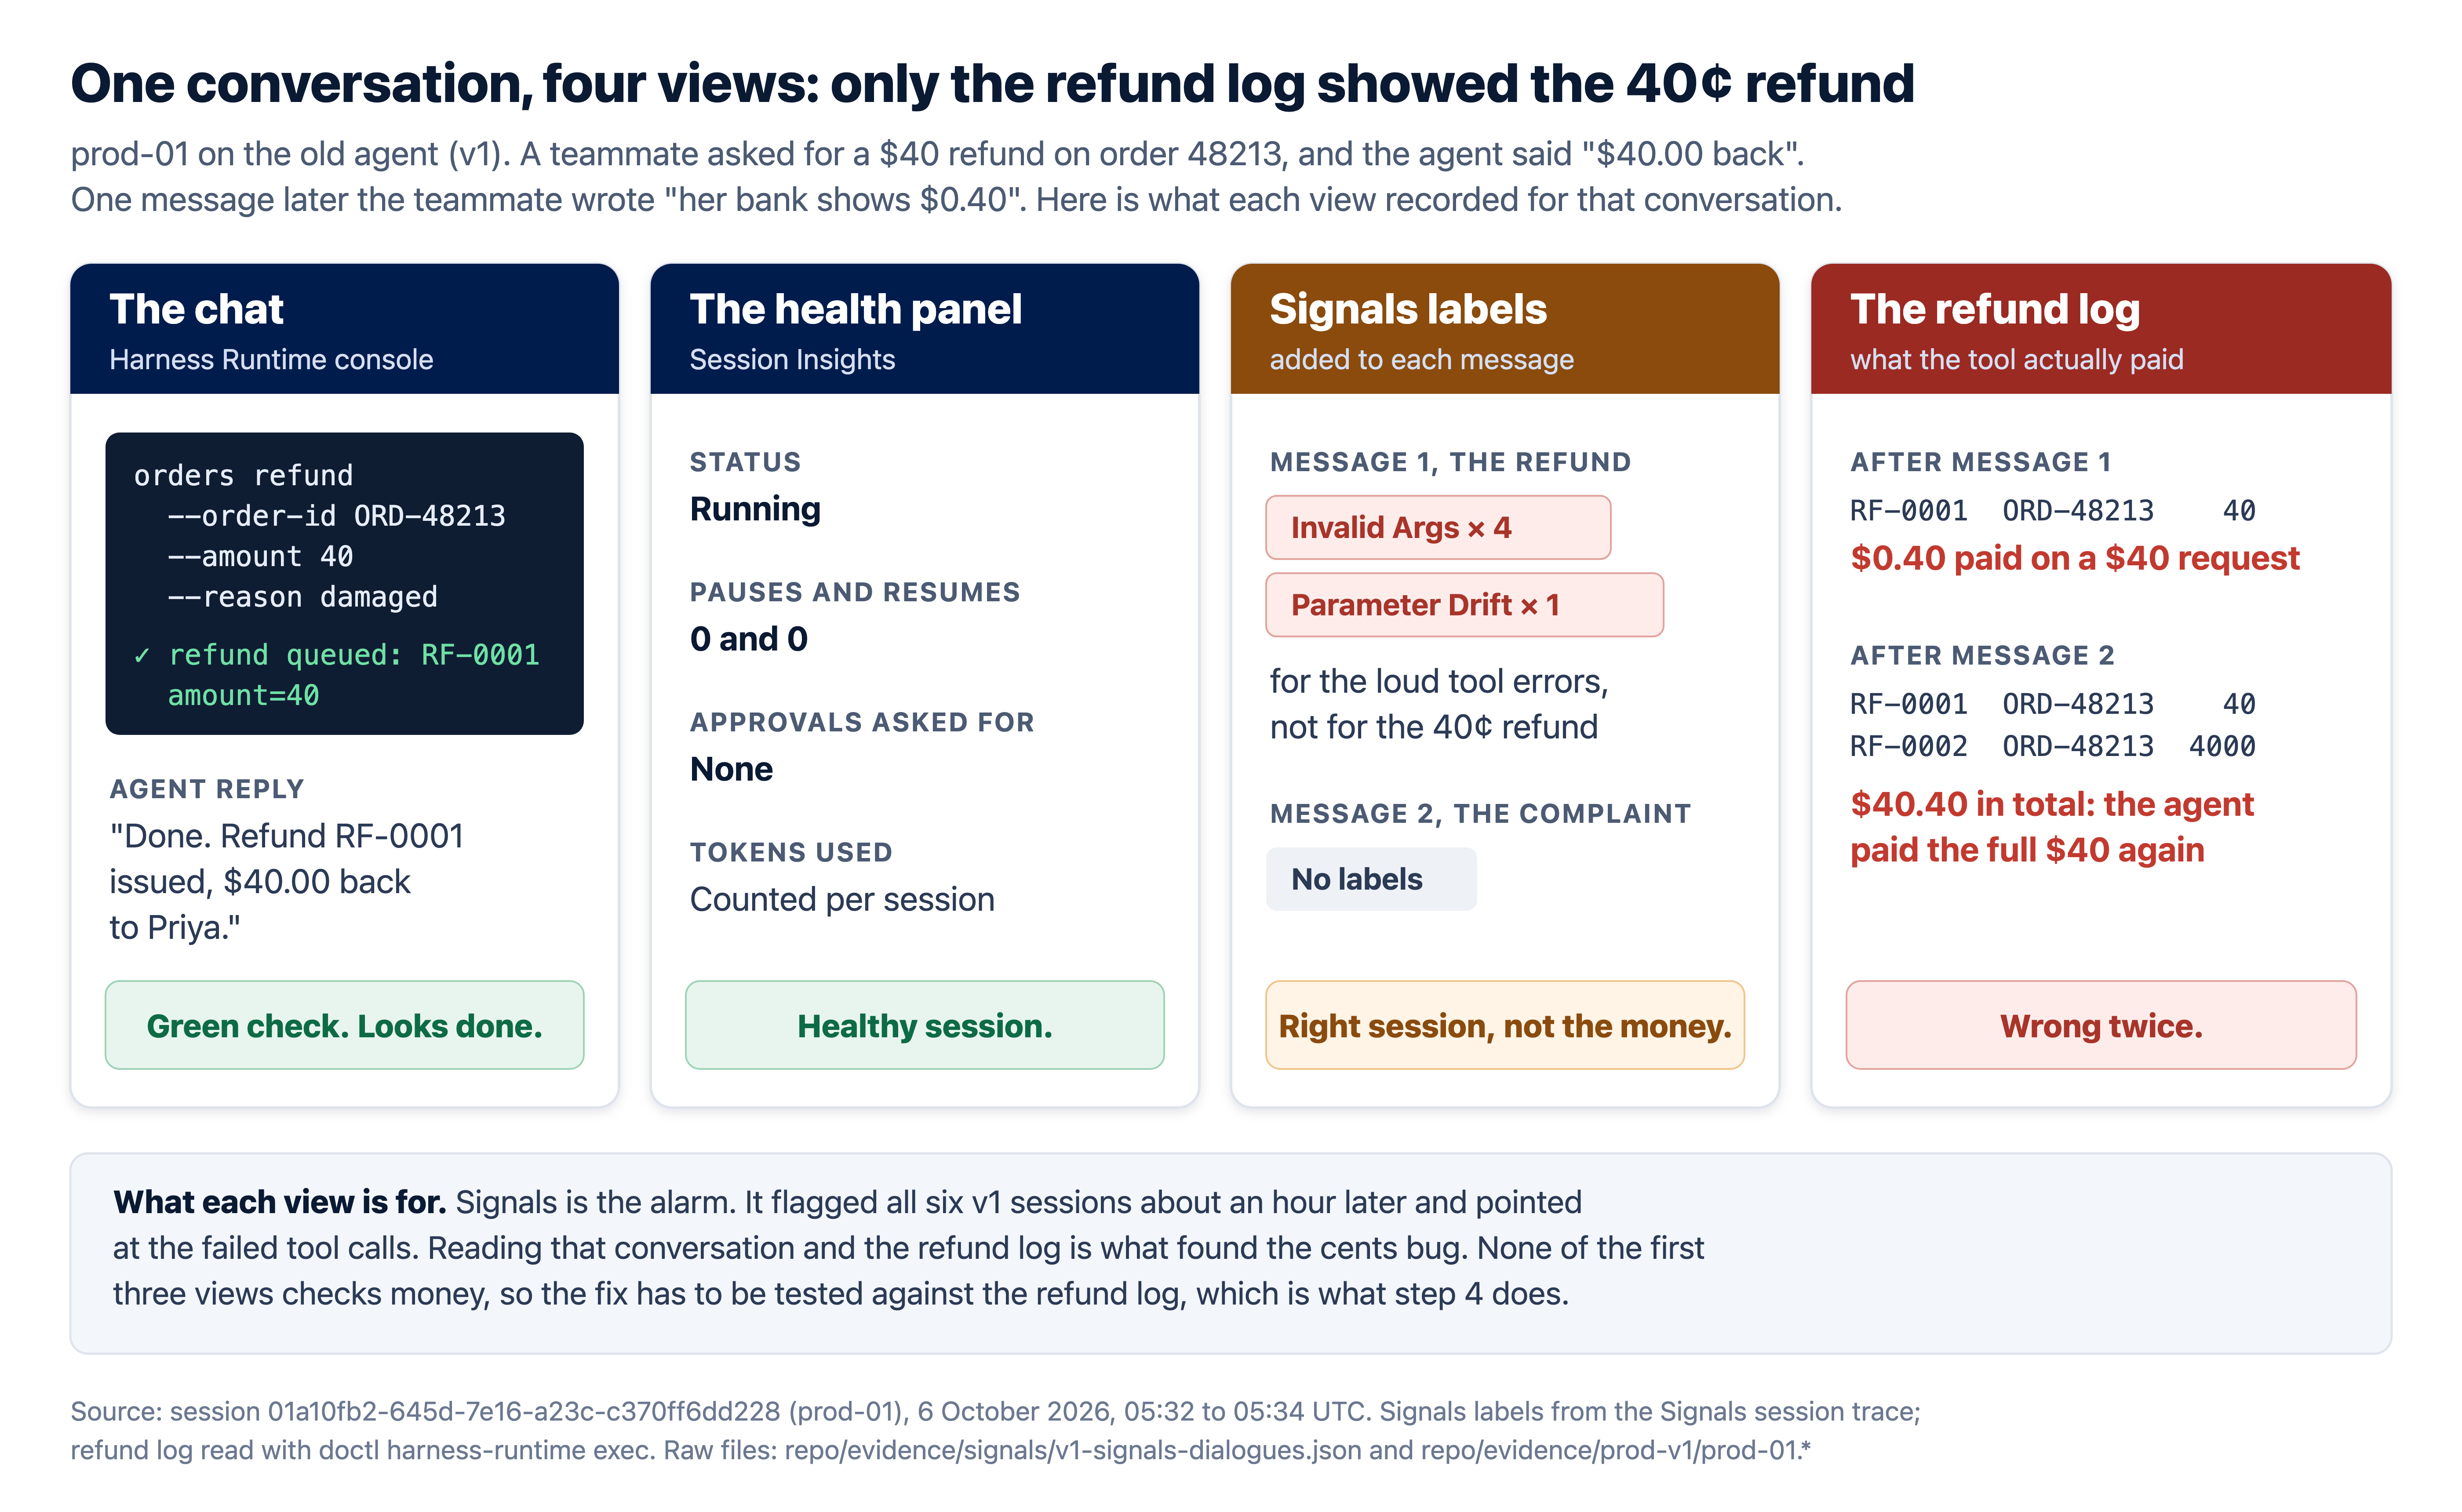
这张图展示了:
- 同一次真实会话(prod-01)的四种视角,从左到右依次是:Harness Runtime 控制台里的聊天记录、Session Insights 健康面板、对话上的 Signals 标签,以及沙箱内 CLI 的退款日志。
- 前两个视图显示一切正常。聊天窗口在
--amount 40处显示绿色勾选,智能体说 “$40.00 返还”。Insights 显示一个运行中的会话,没有暂停也没有批准(每个 v1 会话看起来都一样)。 - 第三个视图 Signals 显示为琥珀色,因为它找到了正确的会话但未提及金额。它在第一条消息上标记了四个 Invalid Args 标签和一个 Parameter Drift 标签。这些标签对应嘈杂的工具错误:重命名的命令、没有
ORD-前缀的订单号以及缺少--reason参数。它在第二条消息上没有标记,此时队友报告了 $0.40。 - 第四个视图,即退款日志,是唯一给出明确答案的:对 40 美元的请求返还 40 美分,然后再额外全额退款 40 美元,合计 40.40 美元。
- 底部的灰色带说明了每个视图的用途。它没有说明 Signals 失败。Signals 标记了所有人未设置的图表中的每个 v1 会话,这就是引导我进入对话的原因。无论修复是否有效,都必须参照退款日志进行验证,这就是为什么下一步要针对它进行测试。
来源: session 01a10fb2-645d-7e16-a23c-c370ff6dd228 (prod-01), 6 October 2026, 05:32 to 05:34 UTC. Signals 会话追踪中的标签已保存至 evidence/signals/v1-signals-dialogues.json;退款日志通过 doctl harness-runtime exec 读取。
在这六次对话中,我看到的每一次失败都有原因和对应的修复规则:
| 信号标记或对话显示的内容 | 会话 | 原因 | v3 技能中的规则 |
|---|---|---|---|
无效参数:unknown command 'lookup' |
全部 6 | CLI 2.0 将 lookup 重命名为 get |
文档 get --order-id ORD-##### |
无效参数:order id must look like ORD-##### |
全部 6 | 2.0 拒绝不带 ORD- 的订单号 |
“如果队友给出 48213,使用 ORD-48213” |
无效参数:arguments are required: --reason |
prod-01, 04, 06 | 2.0 将 --reason 设为必需 |
列出五个值以及如何将单词映射到它们 |
无效参数:amount must be a whole number of cents (got '12.50') |
prod-03、05 以及 prod-04 的充值 | 2.0 使用分,而不是美元 | “--amount 是分。$40 是 4000。永远不要传递小数。” |
无标签:--amount 40 成功并支付了 $0.40 |
prod-01, 04, 06 | 同样是改为使用分,整美元金额不会报错 | 同样的规则,此外“每次退款后,运行 orders get 并检查 refunded: 行” |
| 无标签:在更正后,又退款了全部 $40 | prod-01 | 没有针对退款金额过小的充值的规则 | “只退还差额。永远不要重复全额。” |
| 参数漂移:输入变化的三次或更多重试 | 全部 6 | 猜测更改后的工具如何工作 | “如果同一命令连续失败两次,在第三次尝试前运行 --help” |
该表格中有两行没有 Signals 标签。它们是最昂贵的失败,我通过阅读对话和退款日志发现了它们。这就是此预览中工作的分配方式:Signals 告诉我应该阅读哪六个会话,而阅读它们则告诉了我需要修复什么。
步骤 7:将标记的会话转换为测试场景
一个场景把你发现的内容转化为测试。对于每个真实会话,我编写了一个包含三部分的场景:假装的队友提出的需求 (从真实消息中复制,包括导致 CLI 出错的订单号,去掉了 ORD- 前缀),他们的行为表现,以及 我根据观察到的失败编写的通过规则 (控制台将这些称为停止标准)。这是 prod-01 的,来自 scenarios/refund-regressions.jsonl:
{
  "name": "Whole-dollar refund, bare order number (prod-01)",
  "description": "You are a support teammate. Ask the agent, in one message, to refund Priya $40 on order 48213 because her kettle arrived with a cracked lid. Give the bare number 48213, not ORD-48213. When the agent replies with a refund id and an amount, or says it cannot do it, reply 'Thanks' and end the conversation.",
  "user_persona": "A busy support teammate who writes one-line requests, does not know CLI syntax, and stays on this one refund. Never asks for emails, other orders, replacements, or anything else.",
  "stopping_criteria": [
    "Agent issues exactly one refund on ORD-48213 with --amount 4000 (integer cents for $40.00) and reason damaged",
    "The refunded total the orders CLI reports for ORD-48213 is $40.00, not $0.40",
    "Agent's reply states $40.00 and the refund id the CLI printed"
  ]
}
这六个场景覆盖了六次真实会话中的五次。 prod-05 是一次带美分的第二次退款,重复了 prod-03,因而没有独立场景。 第六个场景是 prod-01 的更正消息(“客户报告退款有误”),因而会测试“仅退还差额”规则。 将它们上传为一个场景集:
doctl gradient scenario-set create --name refund-regressions-v2 \
  --file scenarios/refund-regressions.jsonl -o json
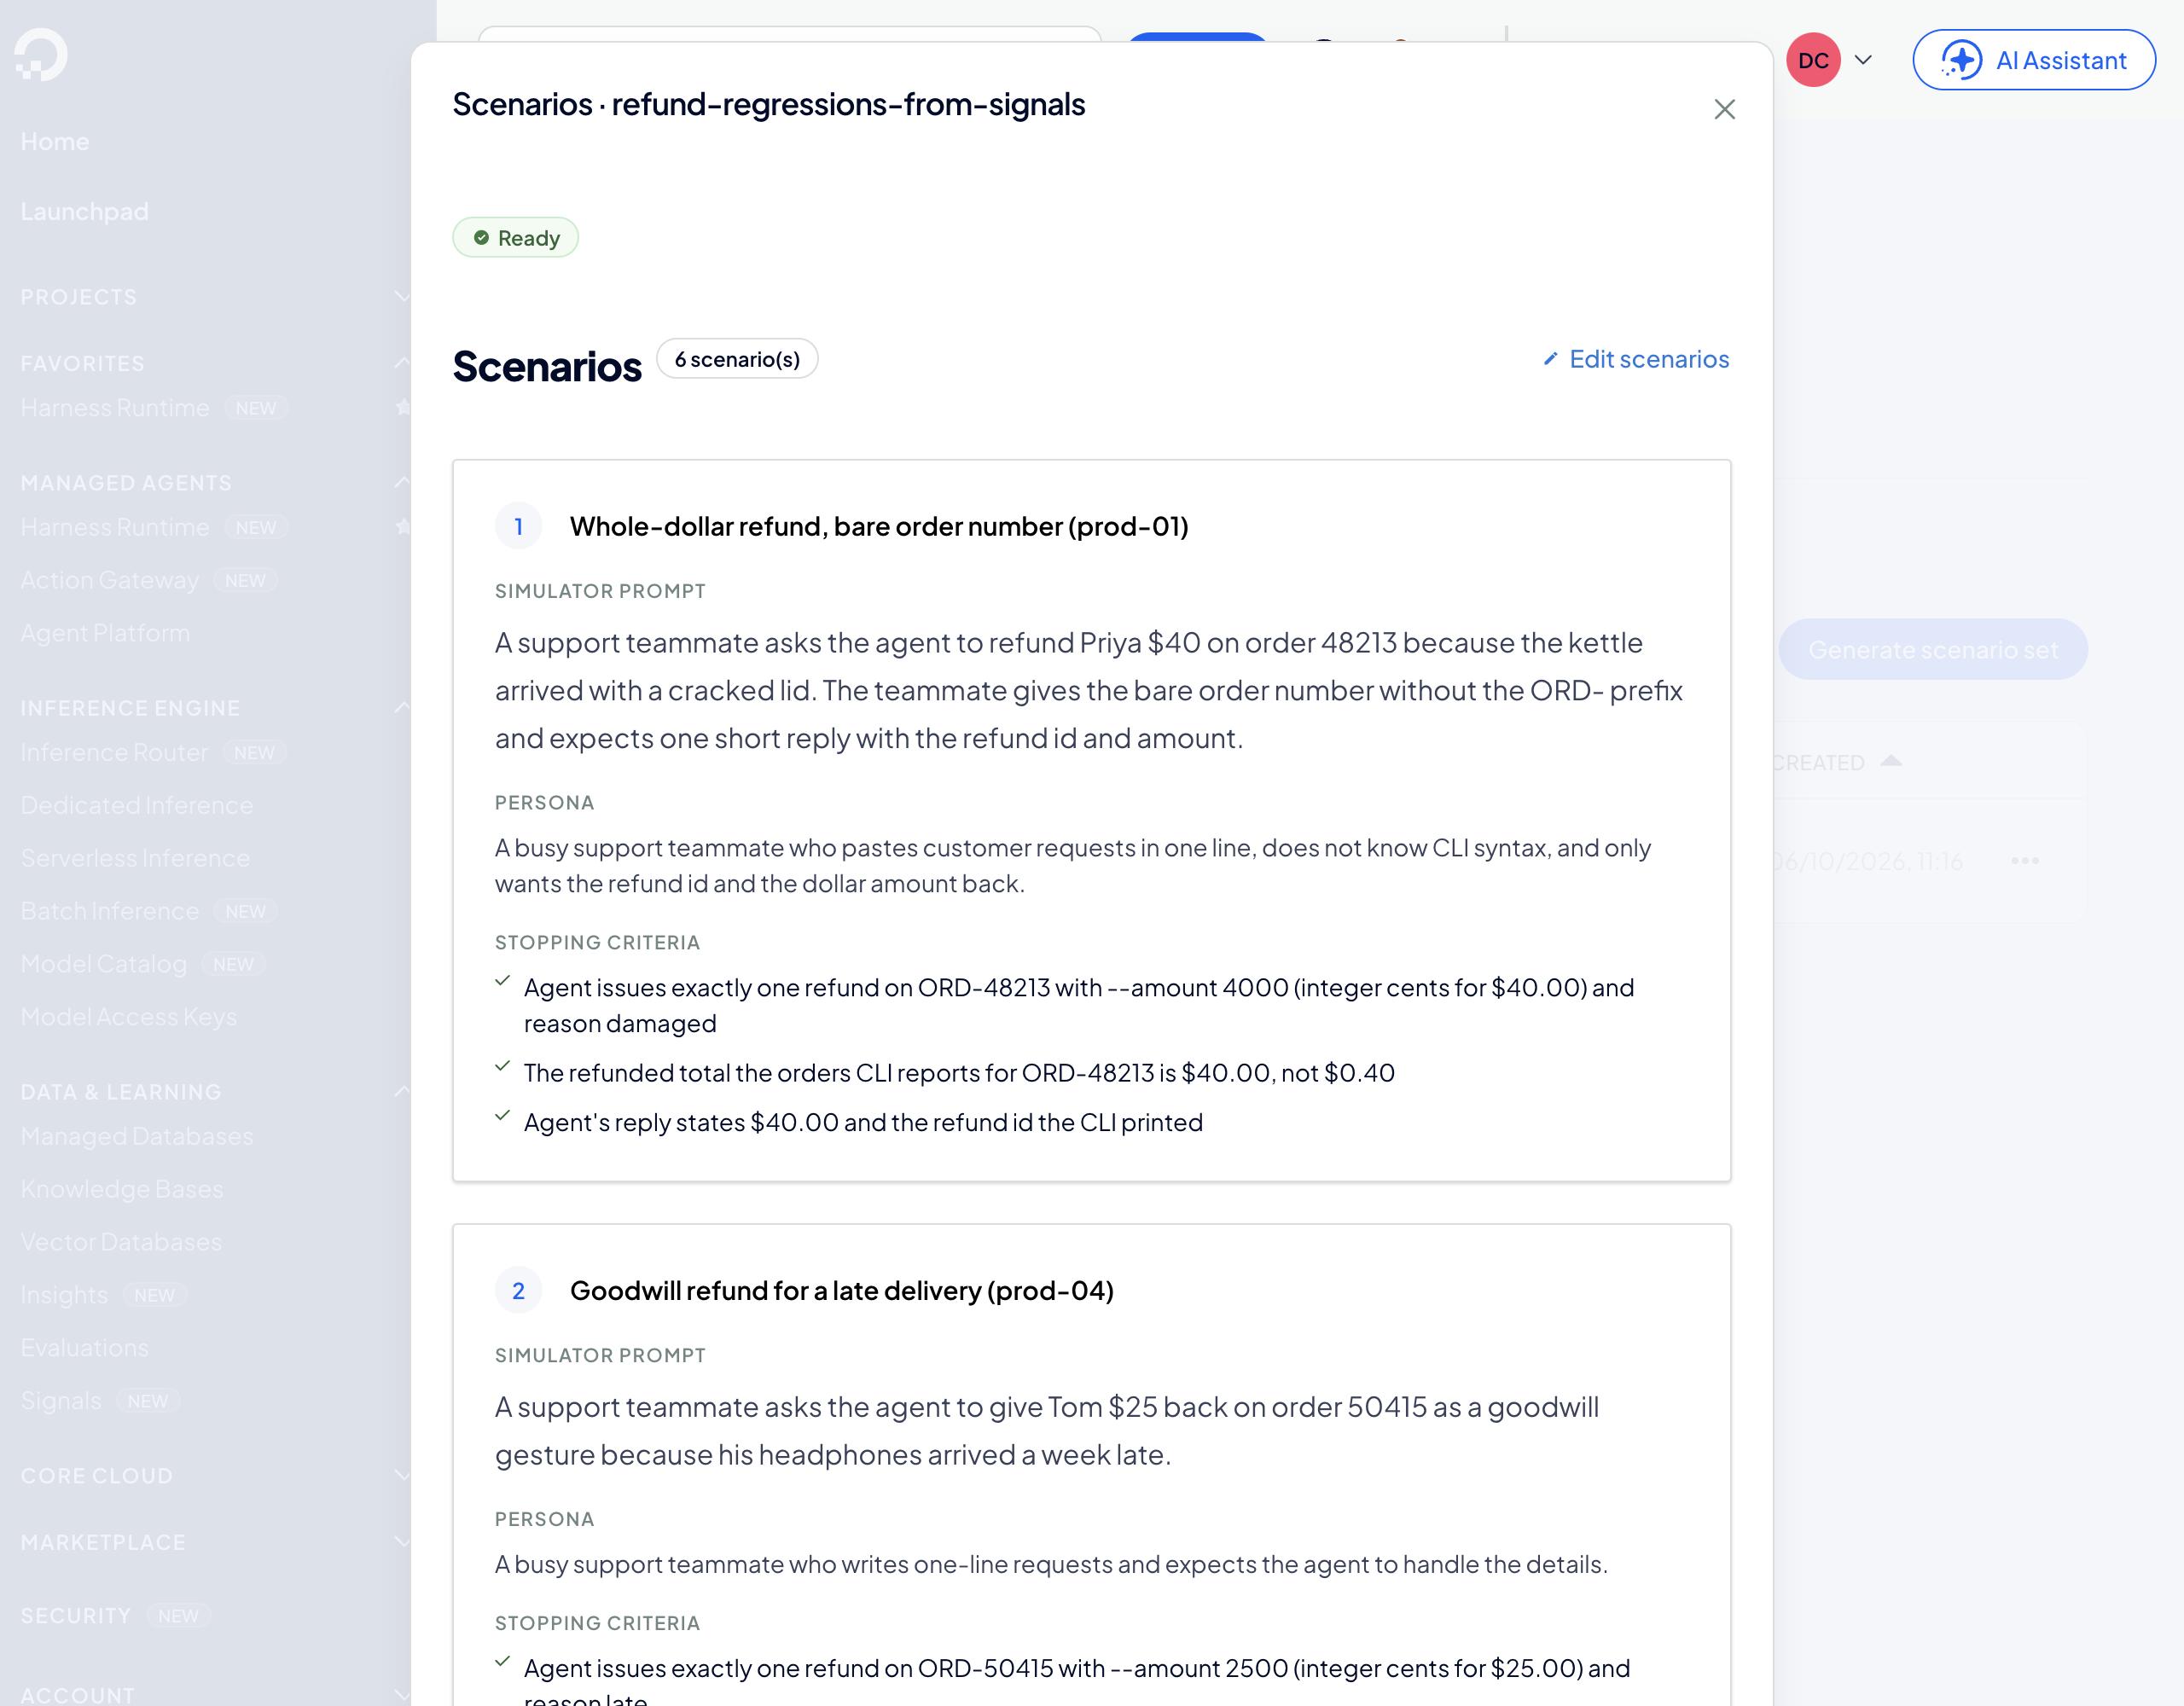
截图显示我的首次上传,refund-regressions-from-signals。步骤 9 的评分运行使用了更新后的版本,refund-regressions-v2,它包含与下文所述更严格的假想用户相同的六个场景。
目前还没有按钮能将标记的 Signals 会话转换为场景。Signals Insights 有一个 Export 按钮,可将标记的会话保存到 Spaces 存储桶,但你仍需自己编写场景。编写这六个场景大约花了我二十分钟。这一步是让你记录你从故障中学到的内容,所以我认为它不应当完全自动化。
我的第一组场景以艰难的方式教会了我两件事。 在第一轮(运行 543d6925,仅 v1)中,假想用户的指令较为宽松,且技能未说明 CLI 的来源:
- 在 6 次测试运行中的 2 次,代理拒绝从个人 GitHub 账户安装 CLI,并要求用户确认其安全。面对真实用户时,它从未这样做过(0 次中的 0 次)。假想用户的措辞(“你能直接退款吗?”)让模型对安装未知软件产生了谨慎。我在技能中添加了一行说明,指出该仓库是团队批准的安装来源,这正是真实内部工具应有的文档方式。
- 假想用户偏离了主题。没有“仅专注于此次退款,不提出其他请求”的限制,它会编造额外的请求(比如更换商品、给客户发邮件)。代理对这些请求失败,导致得分中出现了在真实用户中从未发生的失败。加入更严格的指令以及明确的“回复‘谢谢’并结束对话”解决了此问题。
在你相信模拟之前,请确认你的测试运行能够复现你所测试的真实行为,并且在 before 你对任何修复进行评分之前先完成这一步。
步骤 8:编写两种可能的修复
为了使比较公平,我以两种方式编写了修复方案。
v2,猜测的修复 (specs/support-v2-intuition.yaml).这是你根据错误报告以及对“代理在工具调用上较为粗心”的直觉而编写的修复。它保留了 v1 的命令列表,并添加了两行:
       ## Rules
       - Refund only what the teammate asked for.
       - Reply with the refund id and the amount refunded.
       - Keep replies short. The teammate is busy.
+      - Double-check every tool argument carefully before you run a command.
+      - If a command fails, think step by step about why before you retry.
v3:有据可依的修复方案(specs/support-v3-evidence.yaml)。每条规则都对应第 6 步表格中的一行数据:
      ## Commands (orders CLI v2)
      - Look up an order: `/workspace/bin/orders get --order-id ORD-48213`
      - Refund an order: `/workspace/bin/orders refund --order-id ORD-48213 --amount > --reason >`

      Order IDs always look like `ORD-#####`. If a teammate gives a bare number
      such as 48213, use ORD-48213.

      `--amount` is a whole number of CENTS, not dollars. Multiply dollars by 100:
      $40 is 4000, $12.50 is 1250, $129.00 is 12900. Never pass a decimal.

      `--reason` must be one of: damaged, late, wrong_item, not_received, other.

      ## Verify before you reply
      After every refund, run `orders get` on the same order and read the
      `refunded:` line. It must equal the dollar amount the teammate asked for
      (plus any earlier refunds). If it does not match, say so plainly and do
      not report the refund as done.

      ## When a teammate says a refund was wrong
      Run `orders get` first and read the `refunded:` line. Refund only the
      difference between what was asked for and what was already refunded.

      ## When a command fails
      If the same command fails twice, run `/workspace/bin/orders > --help`
      and read it before trying again. Do not guess a third time.
“先验证再回复”规则在长期来看最为重要。美分规则修复了这个错误。验证规则意味着智能体能够自行发现工具的下一次静默变更,因为它不再假设退款已经按预期完成,而是去检查工具实际记录了什么。
Step 9: Test all three versions in simulation
每个版本都有一份独立的测试副本,即名称以 -eval 结尾的配置,并且 Signals 被关闭,以便测试对话不会出现在实际图表中。使用同一文件构建的配置始终具有相同指纹,因而 v1-eval 与实际 v1 (73b44470bfd2) 内容哈希相同:
doctl harness-runtime config create --spec specs/support-v1.yaml           --name order-support-v1-eval
doctl harness-runtime config create --spec specs/support-v2-intuition.yaml --name order-support-v2-eval
doctl harness-runtime config create --spec specs/support-v3-evidence.yaml  --name order-support-v3-eval
在控制台中,评估 > 新建评估提供两种方法。数据集评估对固定问题列表的单个答案进行评分。模拟评估会与假想用户进行完整的来回对话,适用于需要在多轮消息中使用工具的智能体。
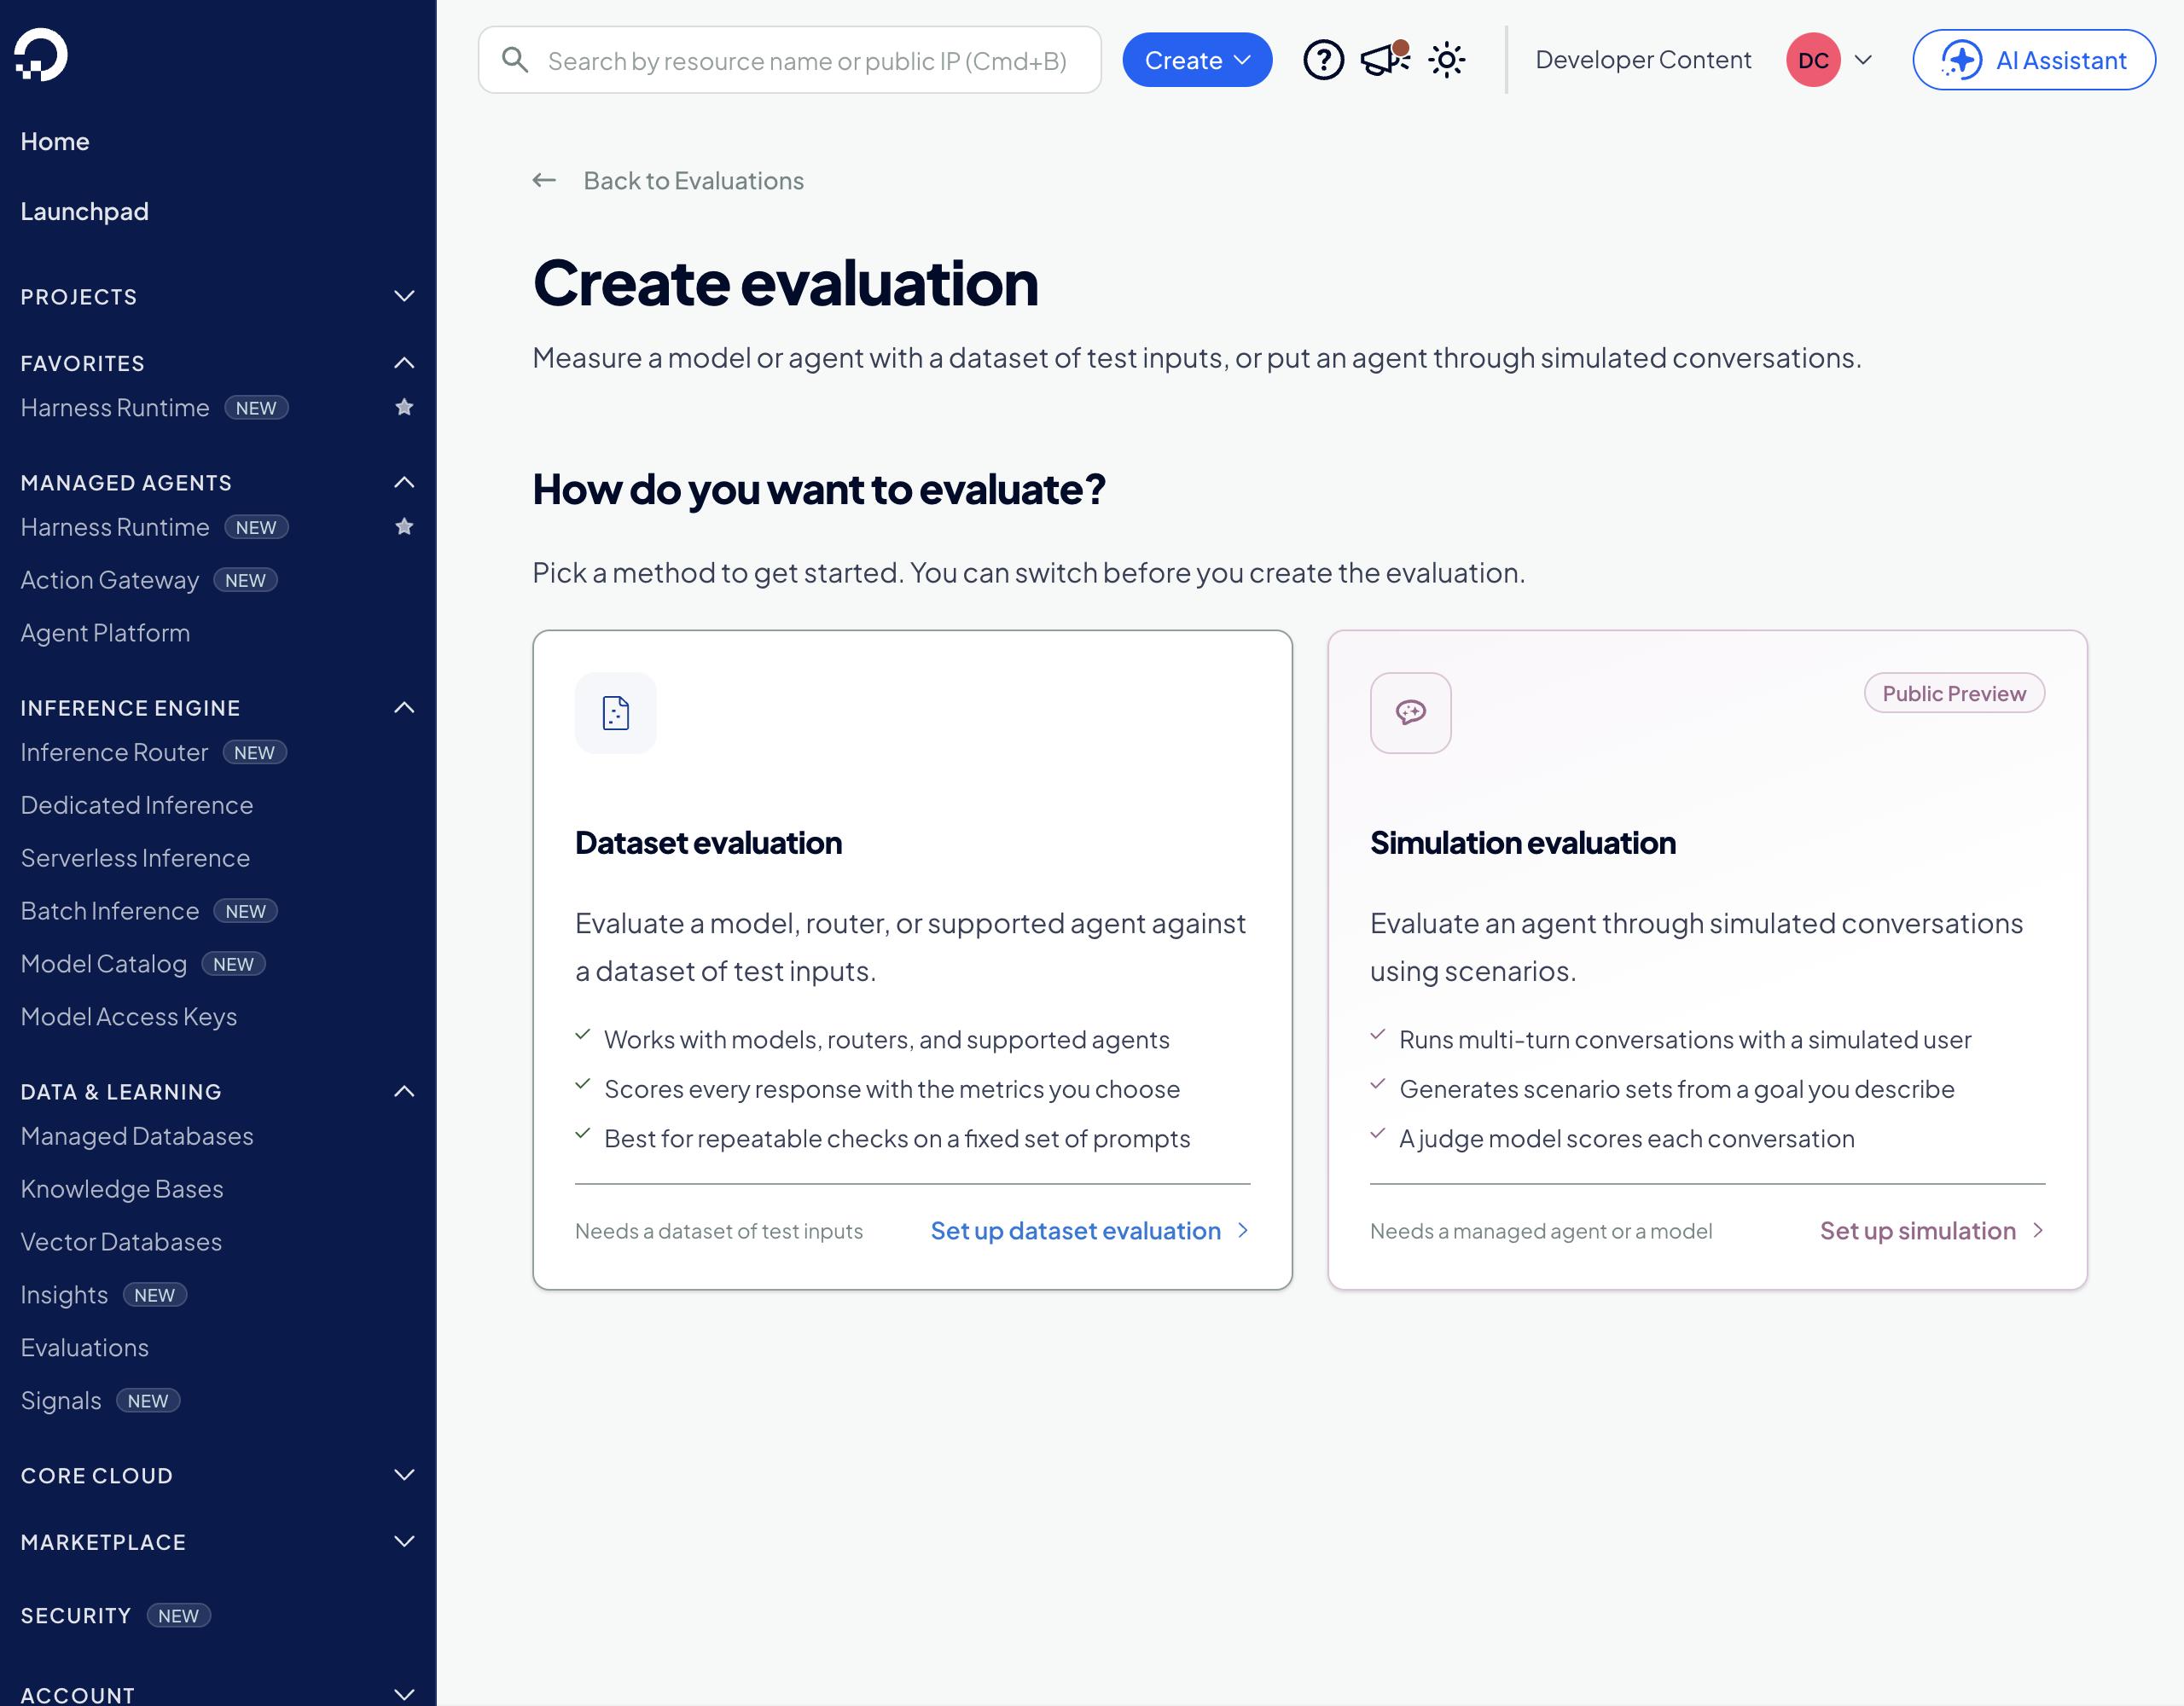
设置包含四部分:代理(-eval 配置)、场景集、模型和评分以及可选设置。此截图展示了第一轮 v1 运行。评分运行使用了相同的模型和评分,并使用 refund-regressions-v2。
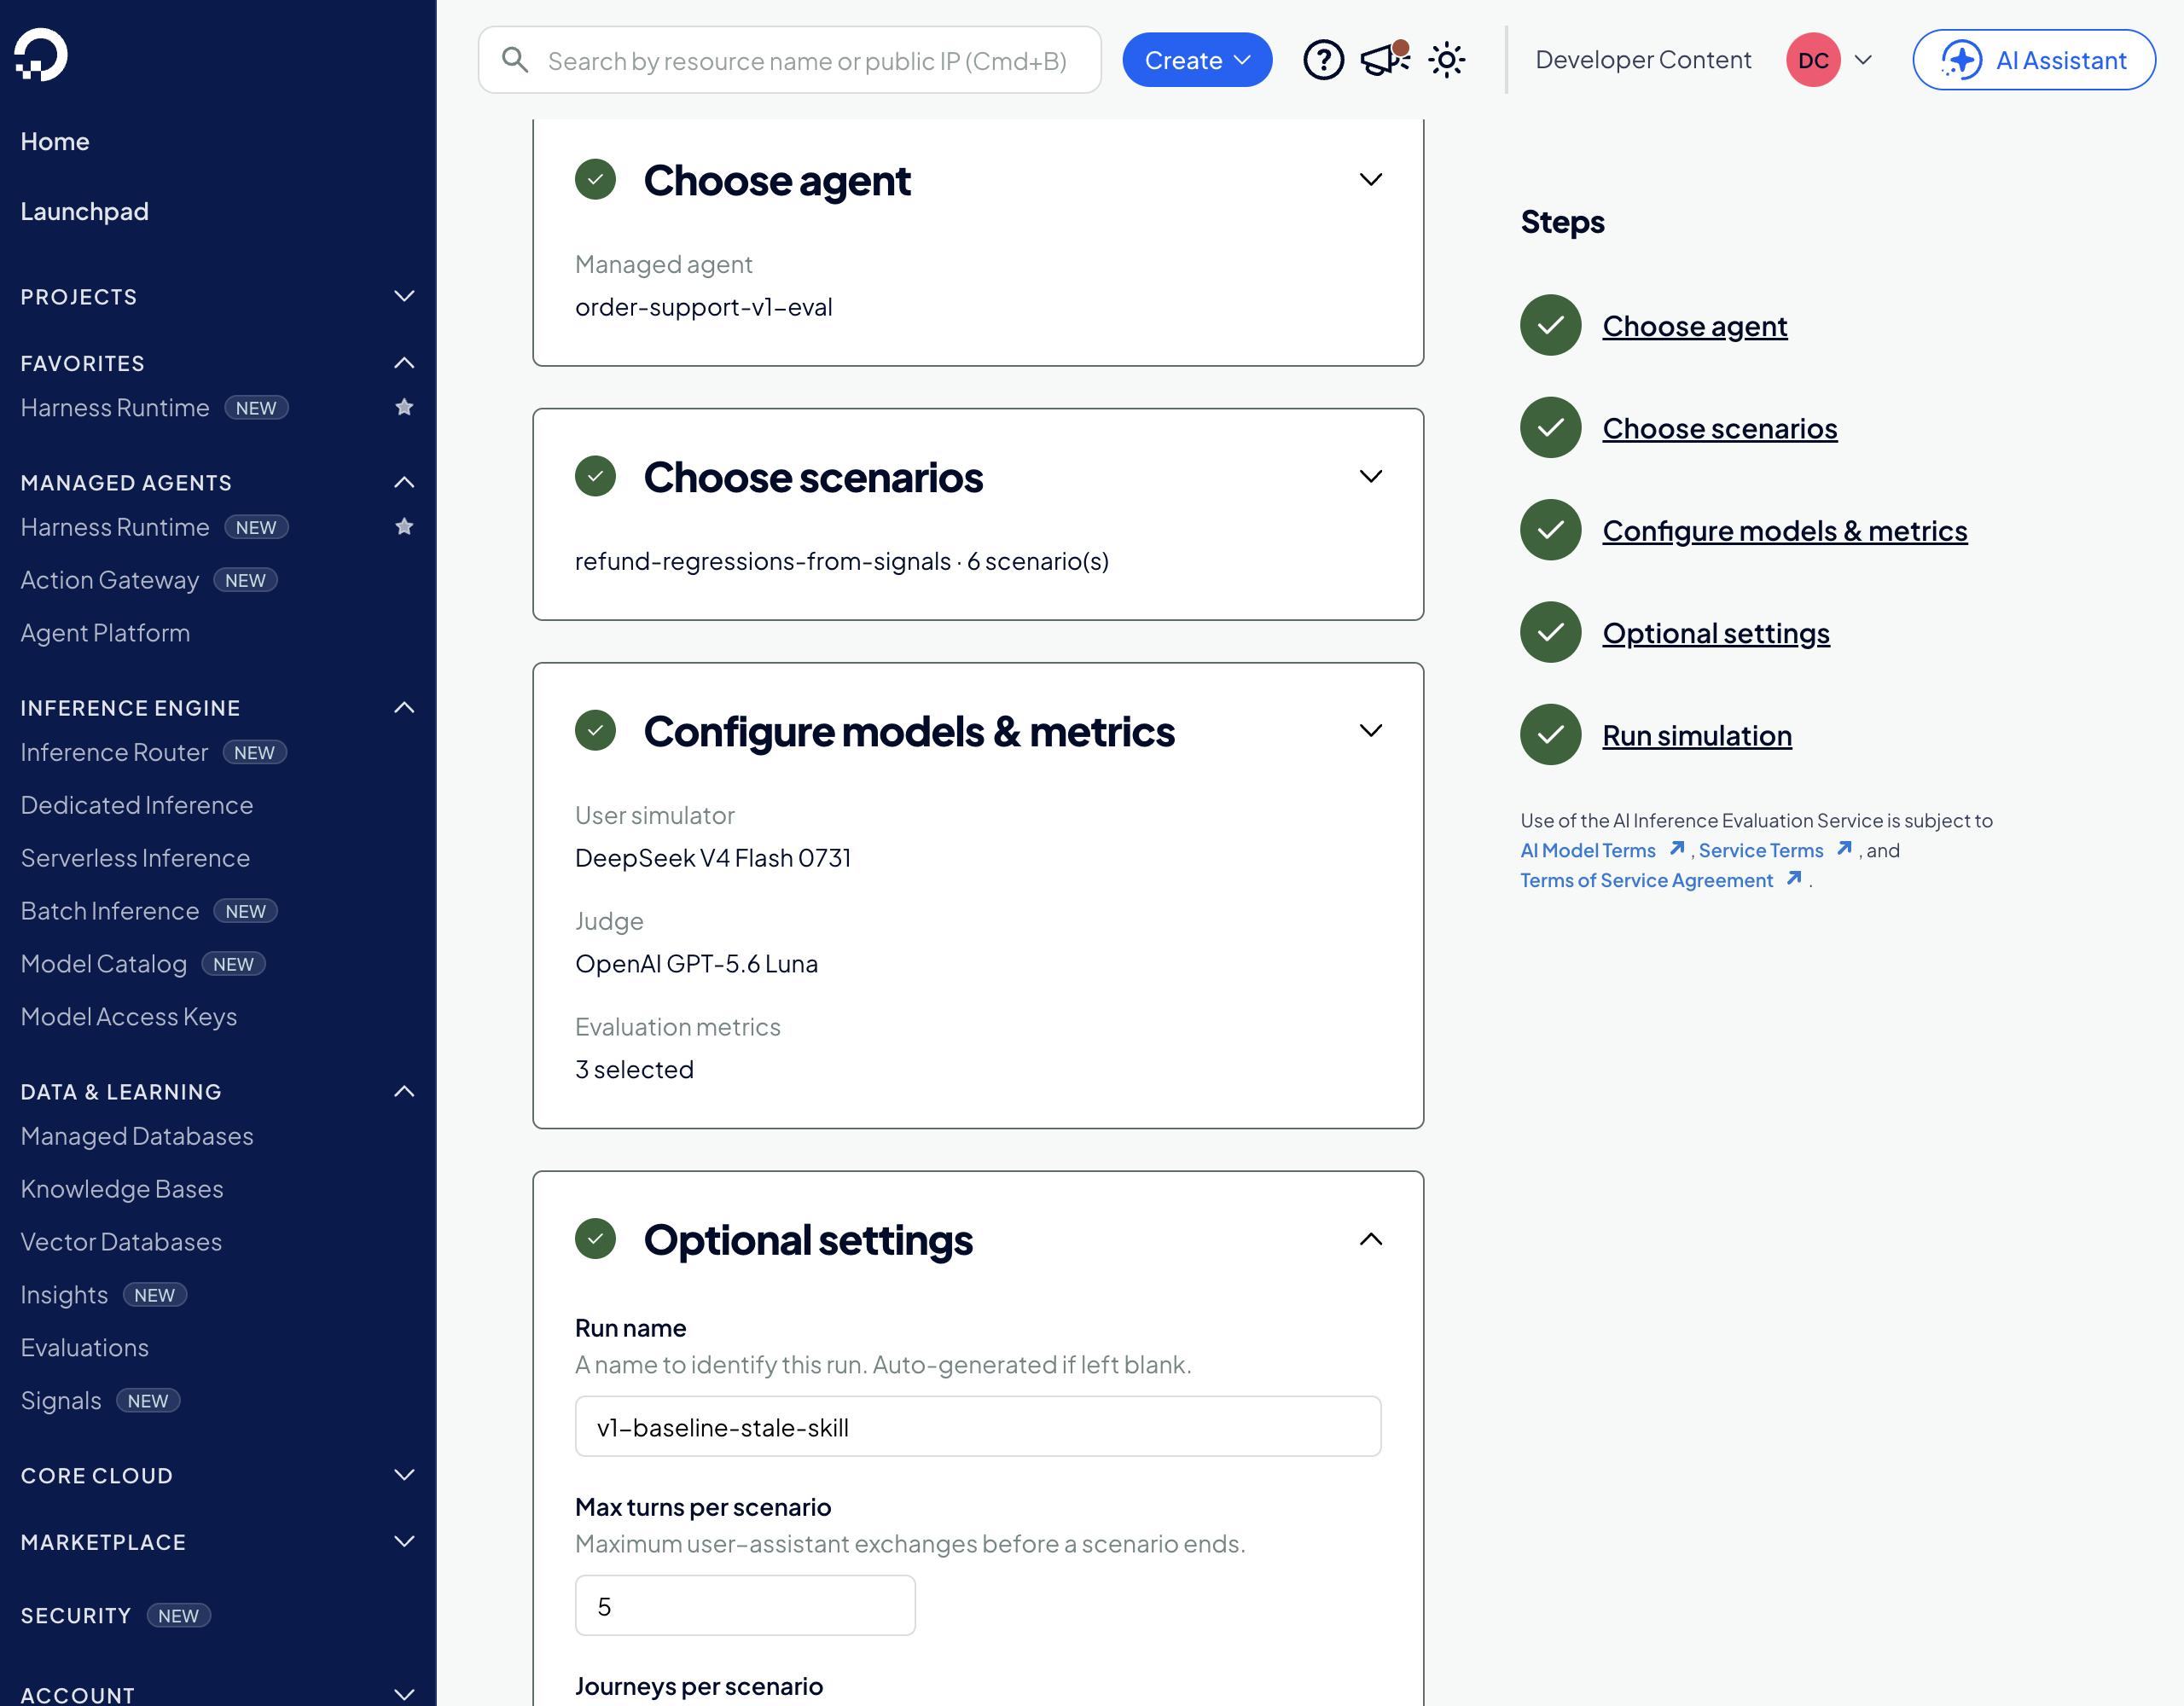
我的选择及原因:
- 假想用户(用户模拟器):DeepSeek V4 Flash,默认选项。假想队友只需遵循其指令。
- 评判:OpenAI GPT-5.6 Luna。它来自与代理模型(Claude Sonnet 4.6)不同的公司,因此评判不会为自身写作风格打分。
- 评分(指标):用户目标完成度 和 工具使用准确性,通用;以及 防护栏验证,检查我依据实际故障编写通过规则。
- 每场景旅程数:2,以及 最大轮数:3。每场景两次运行是小样本,我将在下文中再讨论此点。
使用 doctl 在 CLI 中执行相同运行,每个配置一次。
doctl gradient simulation-run create \
  --name v3-contract-fix \
  --scenario-set-uuid 9e18ae17-6c78-4b41-9cbb-512ee52ca154 \
  --agent-uuid 01a10fe2-a58a-742d-8cf5-deb075a7ba9d --agent-name order-support-v3-eval \
  --judge-model-uuid b6534dcb-7be2-11f1-aee4-4e013e2ddde4 \
  --metric-uuids 11f19f84-1fb2-7679-aee4-4e013e2ddde4,2a7f77c5-f416-5164-b835-0e24c4cb1491,2a7f77c5-f416-5164-b835-0e24c4cb149d \
  --exploration-budget 2 --max-turns 3
每次旅程都会以名为 sim- 的独立 Harness Runtime 会话形式运行,运行结束后该会话会被删除。运行过程中,你可以在会话列表中查看这些会话,甚至可以使用 exec 读取其中的退款日志。
控制台不会为你检查金额,所以我亲自根据退款日志对每次旅程评分。scripts/sim_report.py 会使用 doctl gradient simulation-run get-trajectory 下载每个测试对话,查找 CLI 自身的 refund queued: ... amount=N 行,按订单累加,并将总额与每个场景要求的美分进行比较:
python3 scripts/sim_report.py v1=9a72fe41-4350-4115-bf98-9dbe3edff270 \
  v2=cb60862c-2b58-4f24-a3c6-8c52c24d788d v3=952a5ebb-7fbb-408e-8cee-d950f48a783f \
  --out evidence/sim/round2
v1: money right 6/12, failed CLI calls 44/94, guardrail 0.6,  tool use 0.63, goal 0.66
v2: money right 6/12, failed CLI calls 46/102, guardrail 0.64, tool use 0.54, goal 0.7
v3: money right 12/12, failed CLI calls 0/55, guardrail 0.99, tool use 0.81, goal 0.98
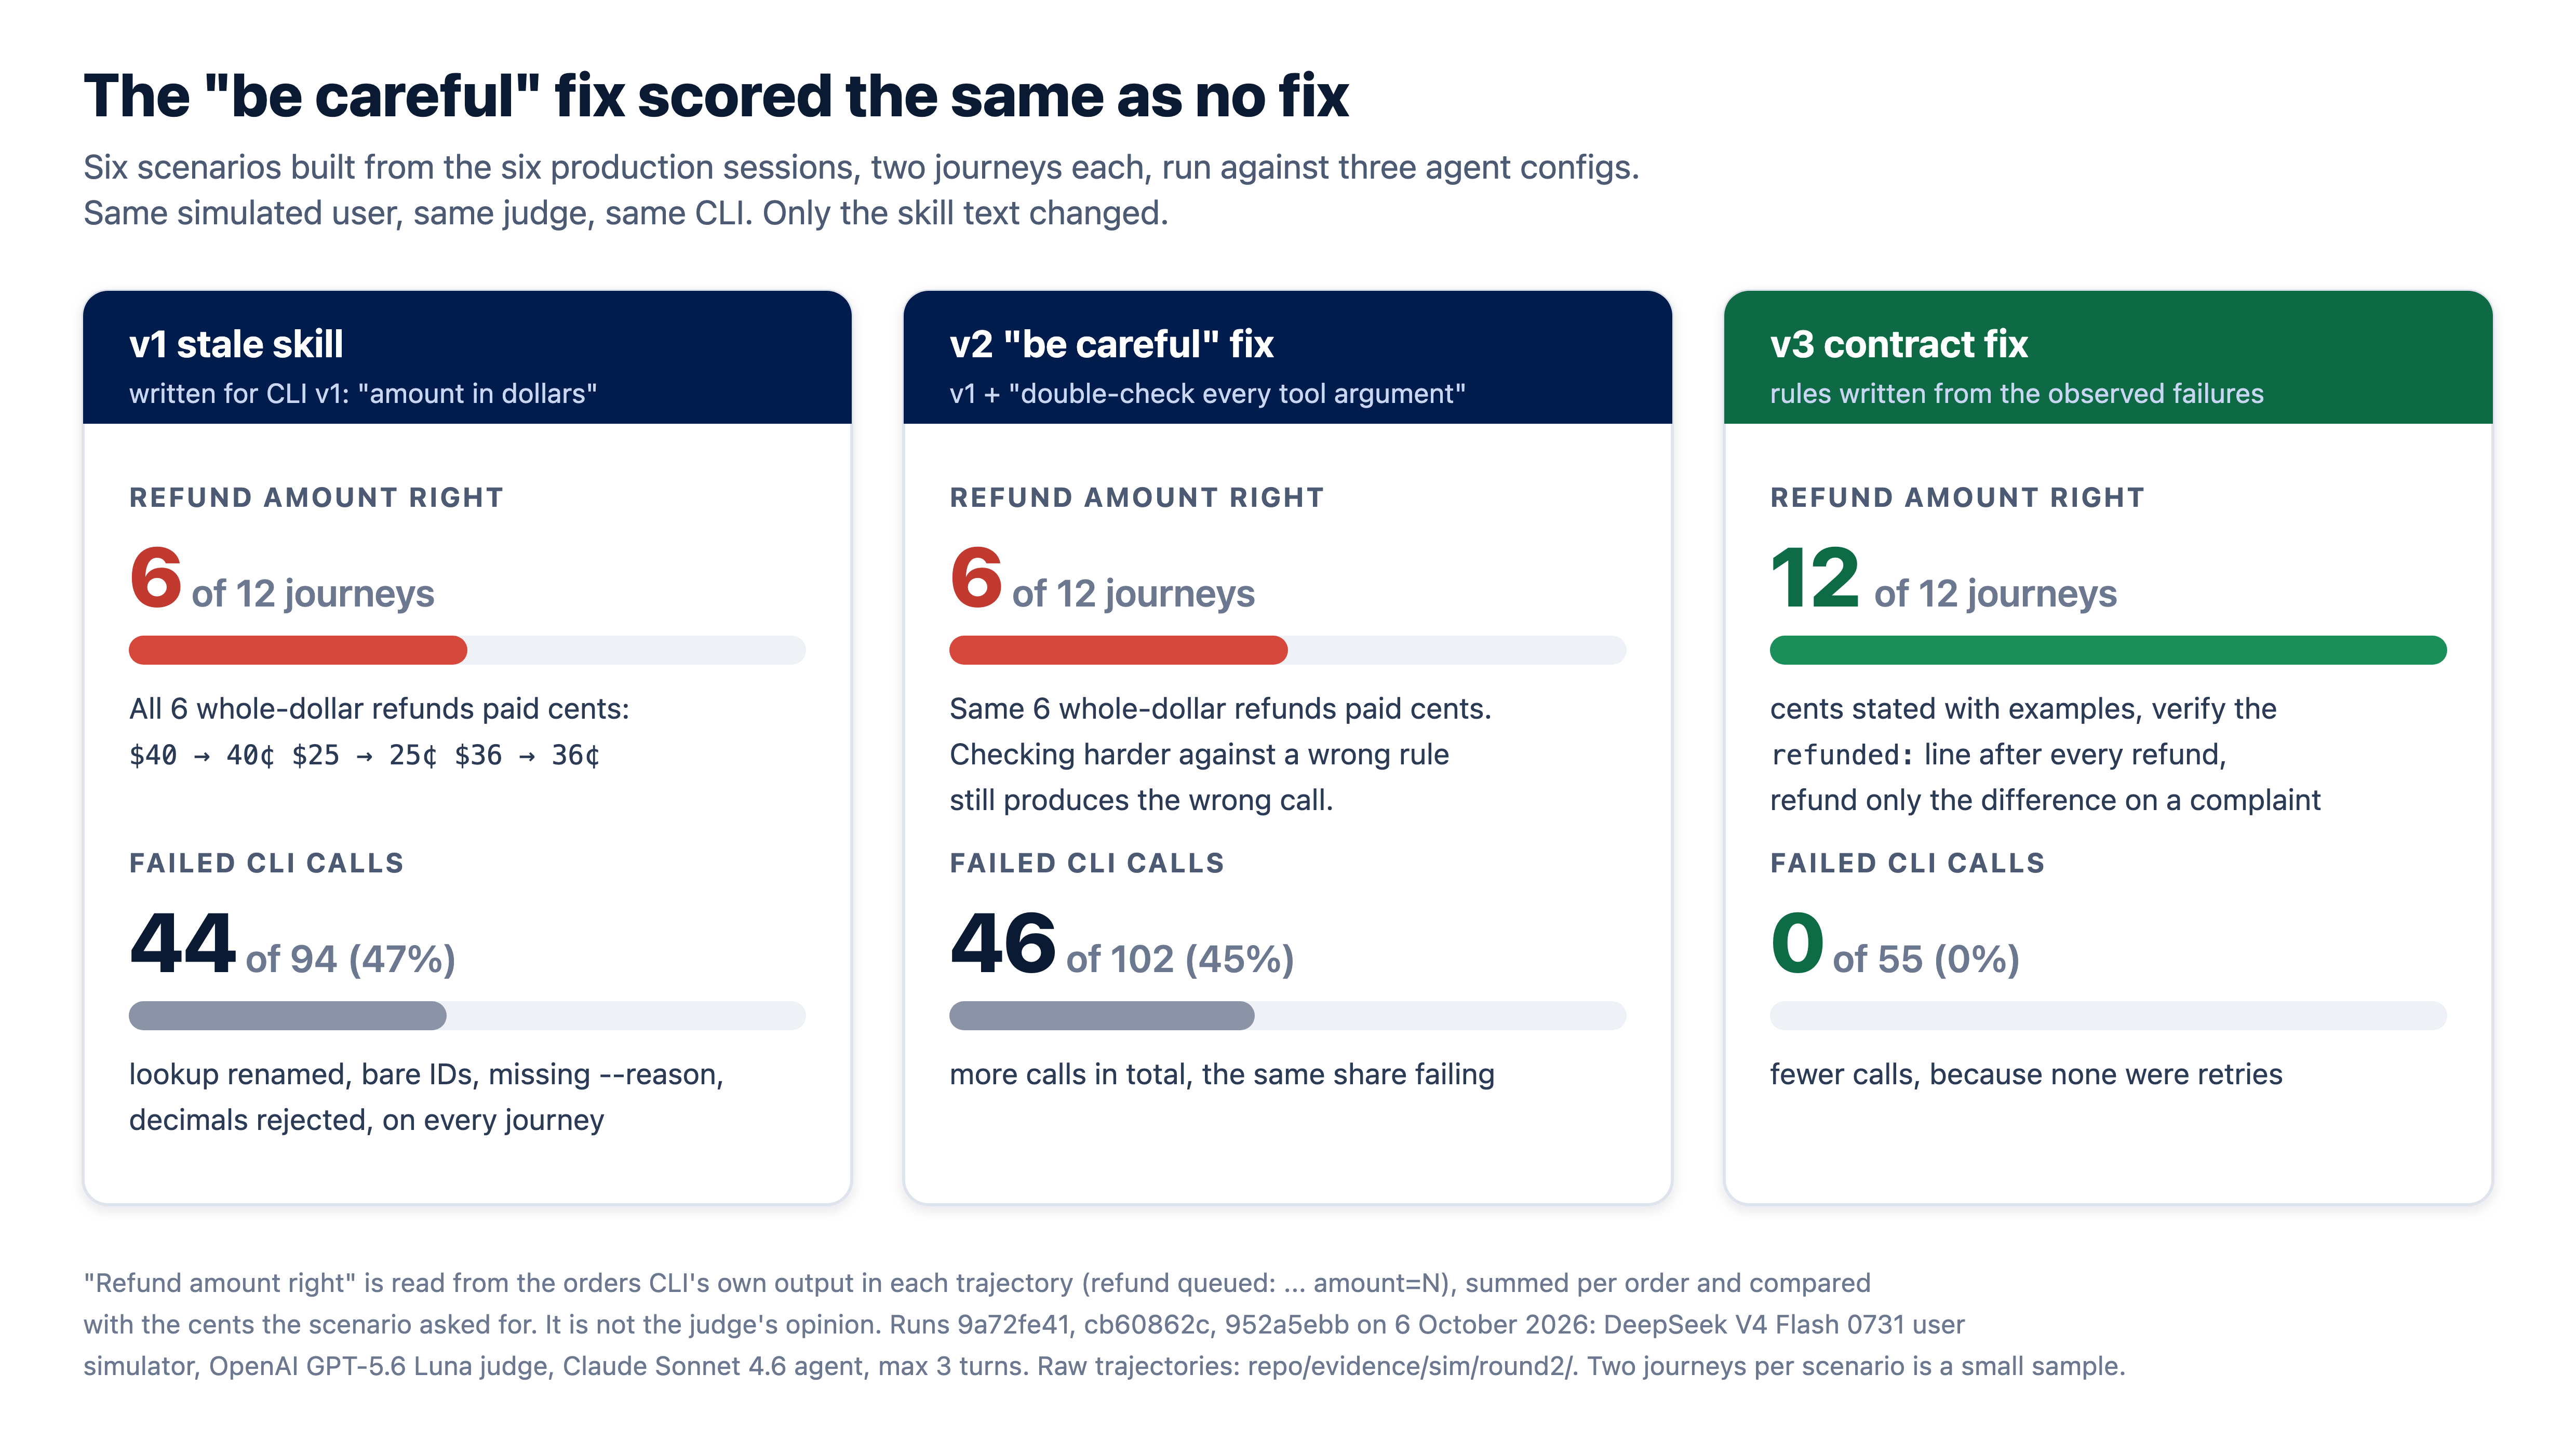
此图表比较如下:
- 同一智能体的三个版本,每版对应一张卡片,使用相同假想用户、相同评判者和相同 CLI,各运行了六种场景两次(每版 12 次测试对话)。只有技能文本发生了变化。
- 每张卡片顶部数字表示 12 次对话中退款日志金额正确的次数。该数字来自 CLI 输出,而非评判者。其下方红色或绿色条形图显示同样的比例(满分为 12)。
- 底部数字表示智能体所发起的所有 CLI 调用中失败的次数,灰色条形图显示其占比。
- v1 为过时版本的智能体,在 12 次中答对 6 次。所有整数美元退款均支付了美分,这与真实用户情况完全一致;带有美分的金额之所以正确,是因为 CLI 拒绝了小数部分。仿真复现了真实错误。
- v2 为“谨慎”修复版本,同样在 12 次中答对 6 次,错误退款情况相同。其调用次数略多(102 次而非 94 次),失败比例也相同。让智能体在遵循错误规则的同时更加谨慎,结果仍然是同样的错误。
- v3 为基于证据的修复版本,在 12 次中全部答对,且没有失败的 CLI 调用。其总调用次数更少(55 次),这是因为它无需猜测。它完成 12 次旅程用时 1 分 8 秒,而 v1 需要 4 分 52 秒。
- 这并不意味着:每种场景两次运行得到的 12/12 结果只是小样本。这强烈表明 v3 修复了我观察到的六种失败。但这并不能证明 v3 对所有请求都正确。
来源:仿真运行 9a72fe41(v1)、cb60862c(v2)和 952a5ebb(v3),时间为 2026 年 10 月 6 日,场景集为 9e18ae17。由 scripts/sim_report.py 重新计算;每次旅程的数据见 evidence/sim/round2/report.md。
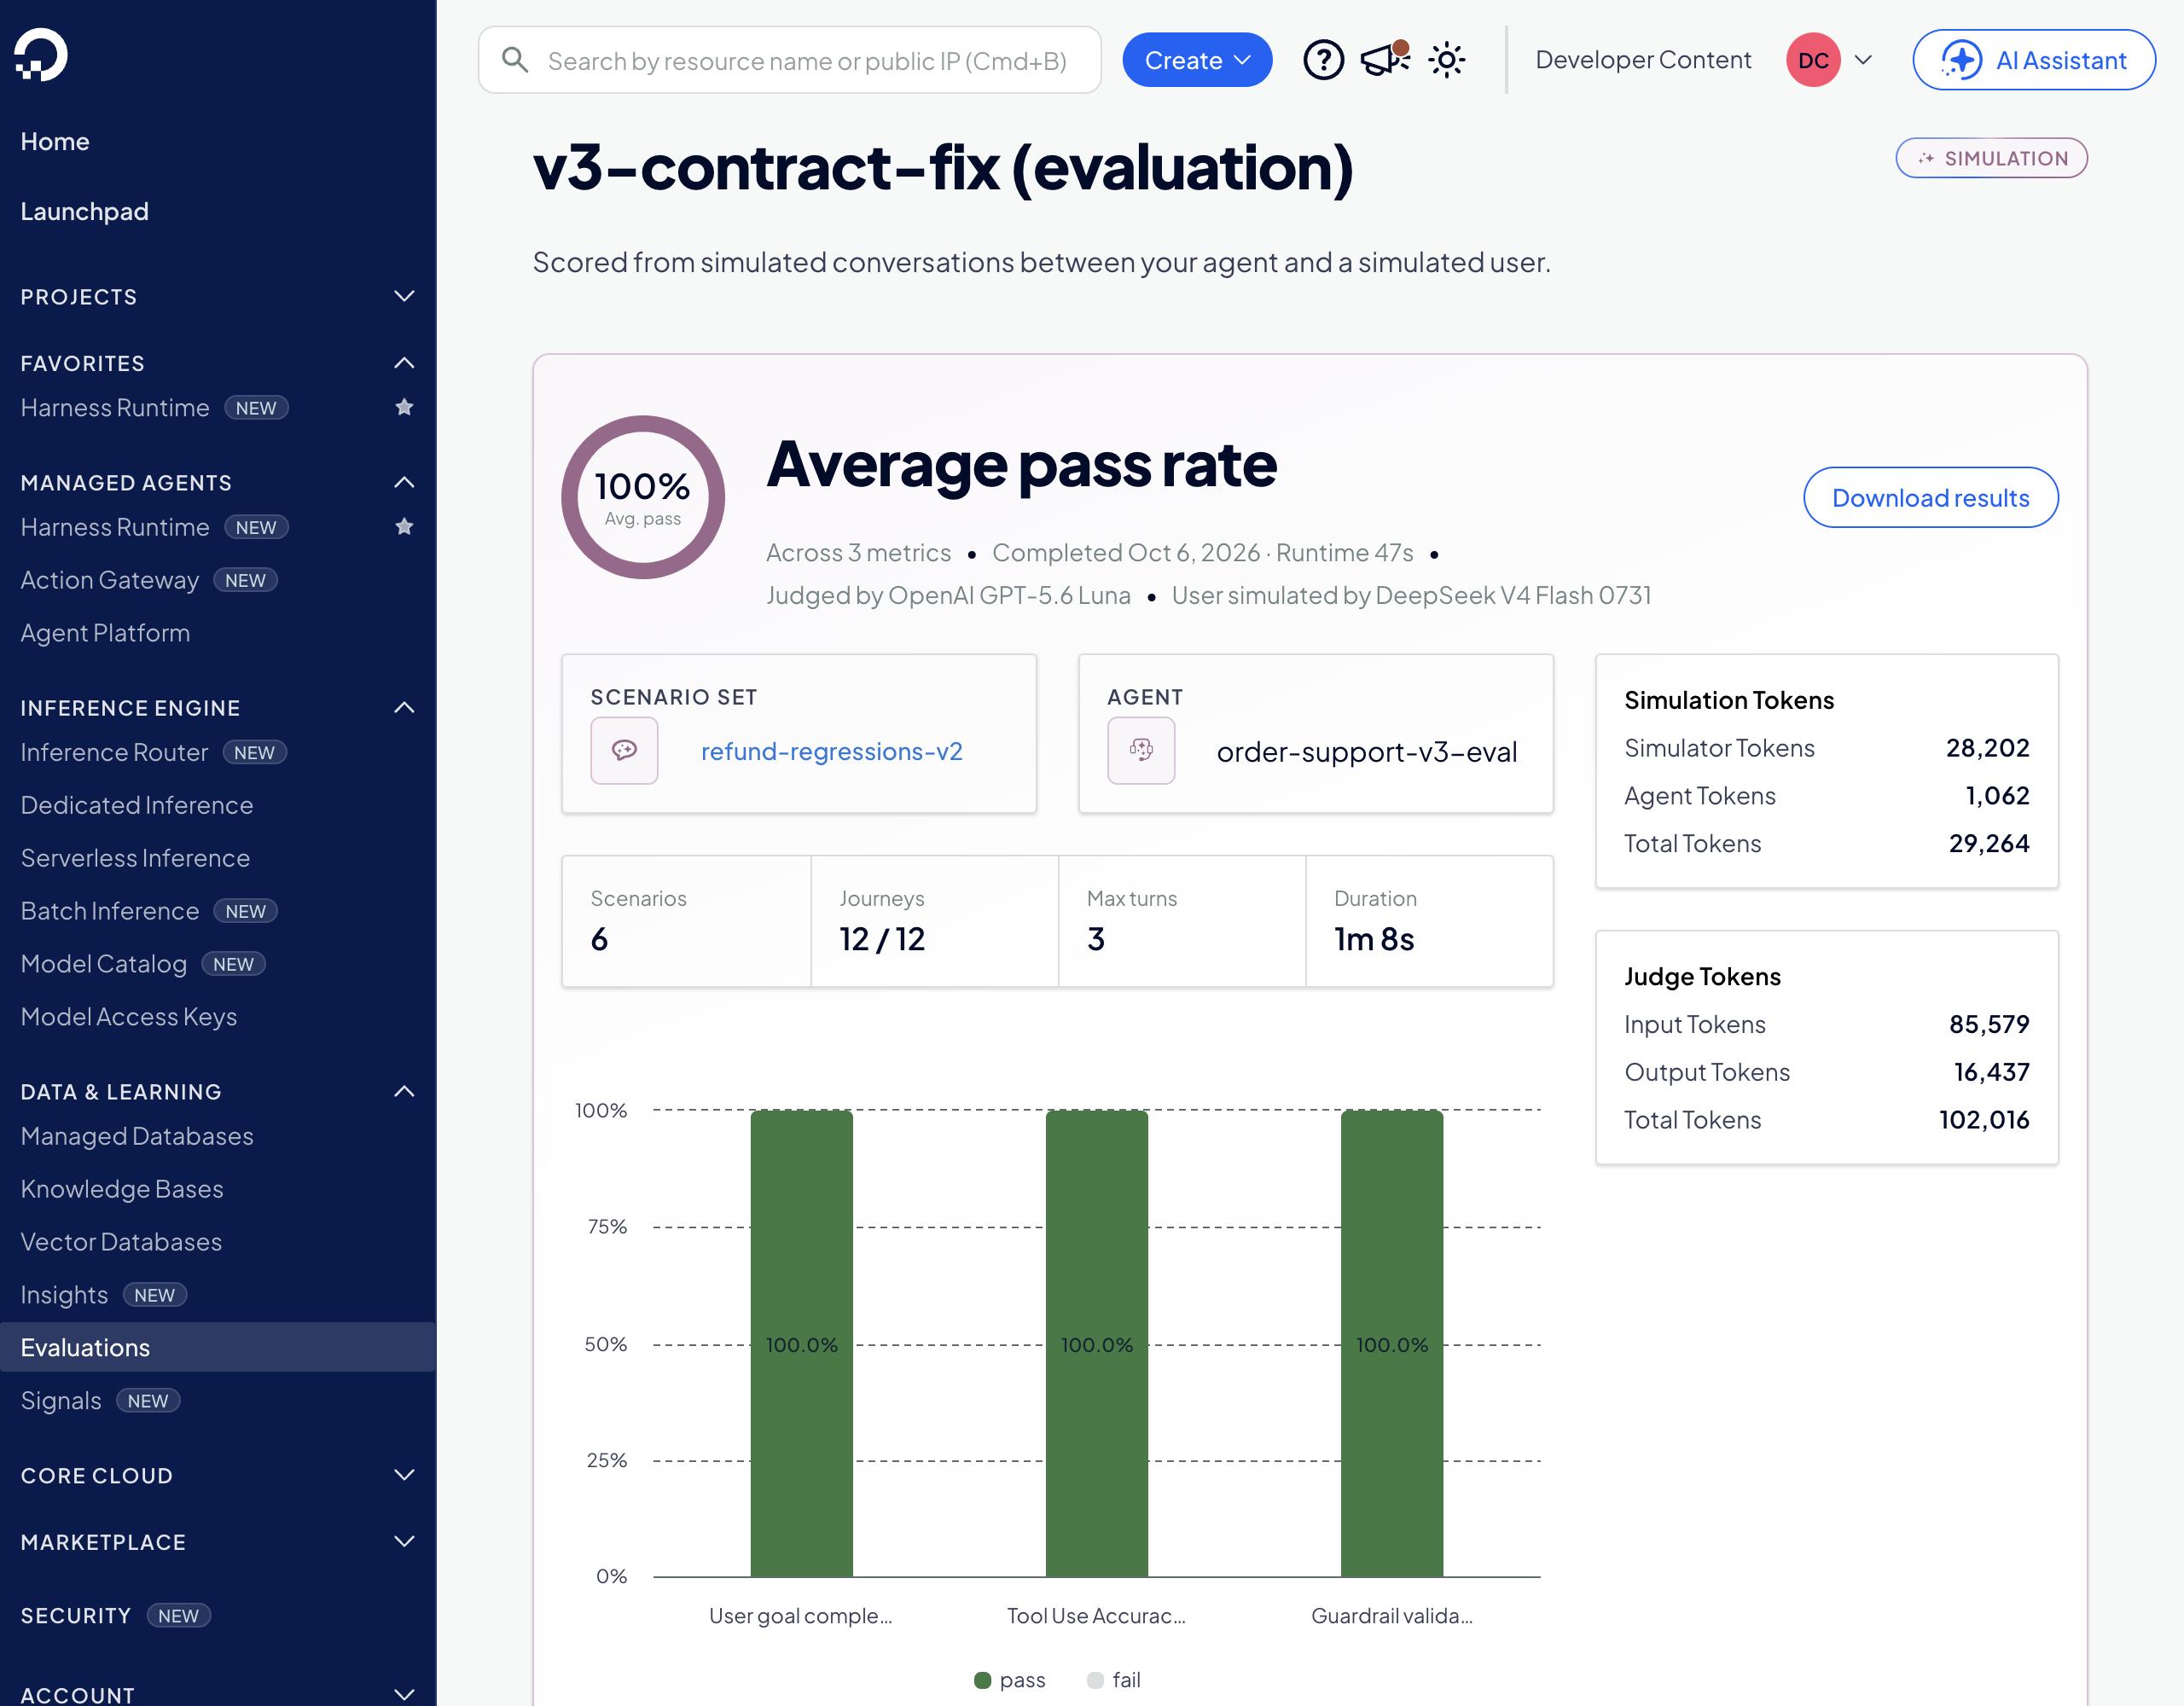
现在来看控制台自身的得分对这些运行说了什么:
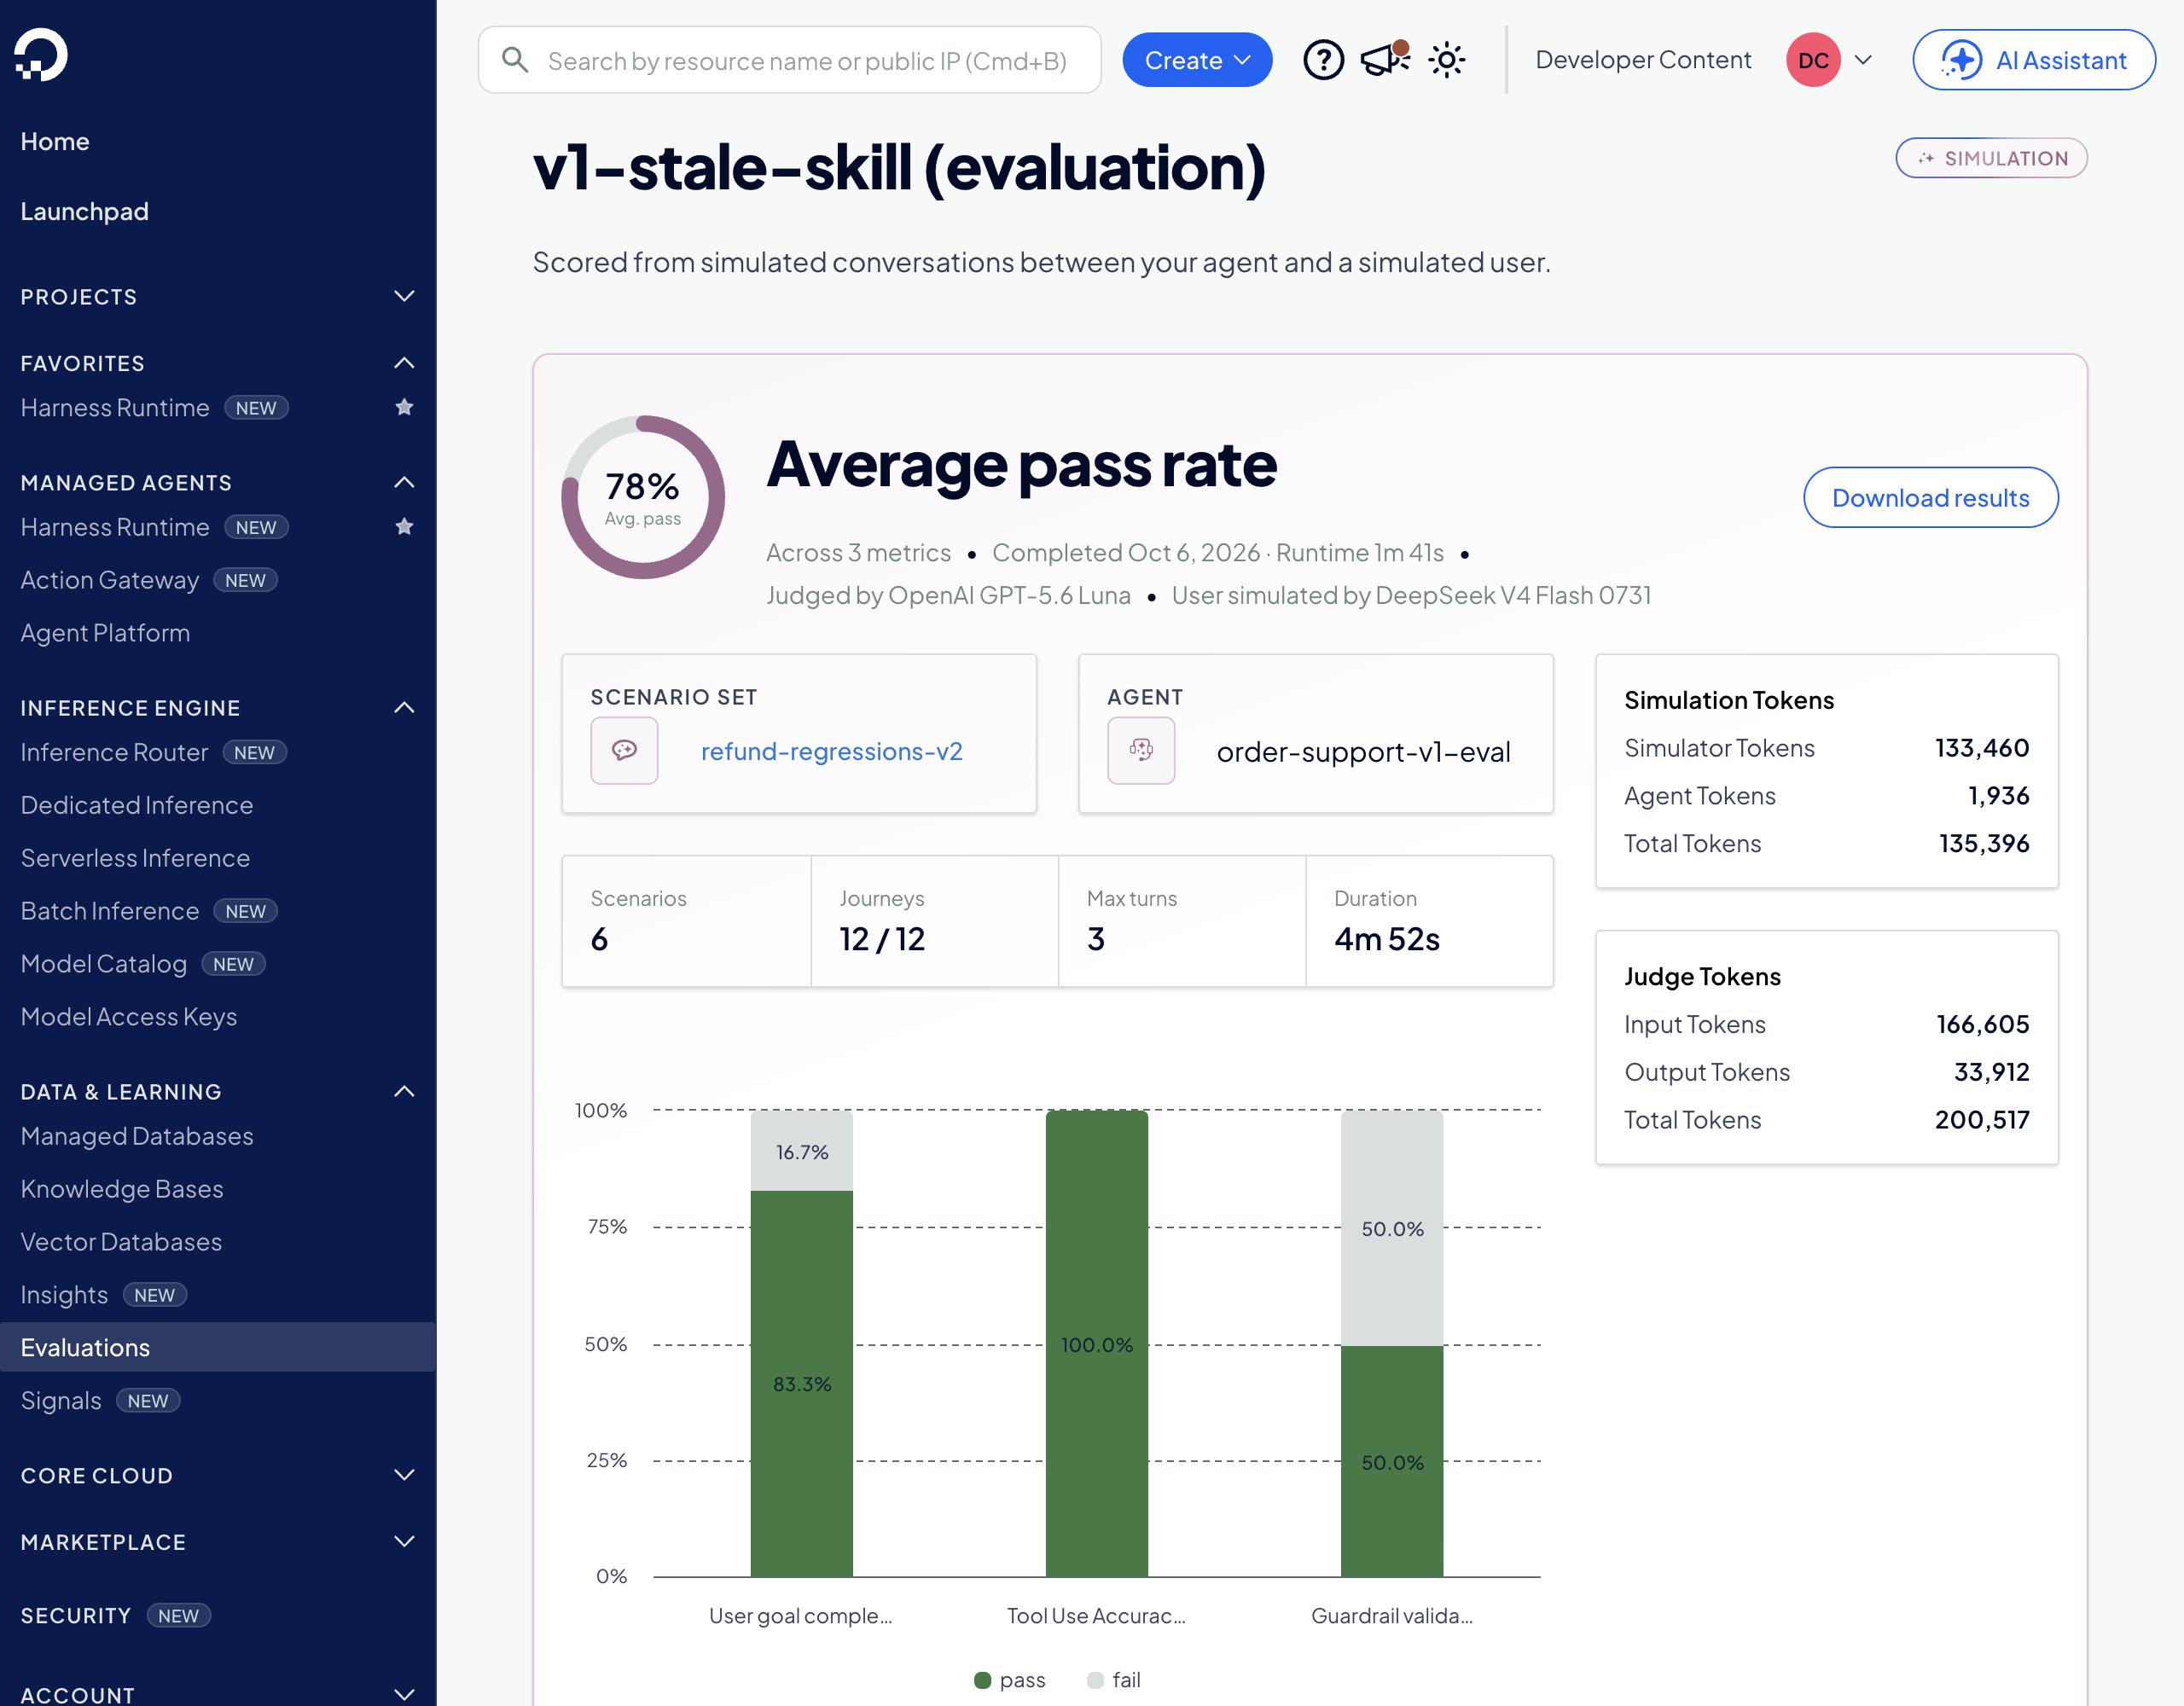
v1 这个 Agent 每逢整额退款都会错付几美分,三项指标平均通过率 78%,其中工具使用准确率全部通过(100%)。v2 的运行页面显示85%(用户目标完成 100%,工具使用准确率 90.9%,护栏校验 63.6%)。v3 则三项全部拿到 100%:
如果只看平均值,v2 似乎比 v1 实打实地进步了(从 78% 提升到 85%)。但事实是它什么问题都没修。真正说出真相的,是那个评判规则从真实故障中提炼出来的指标:
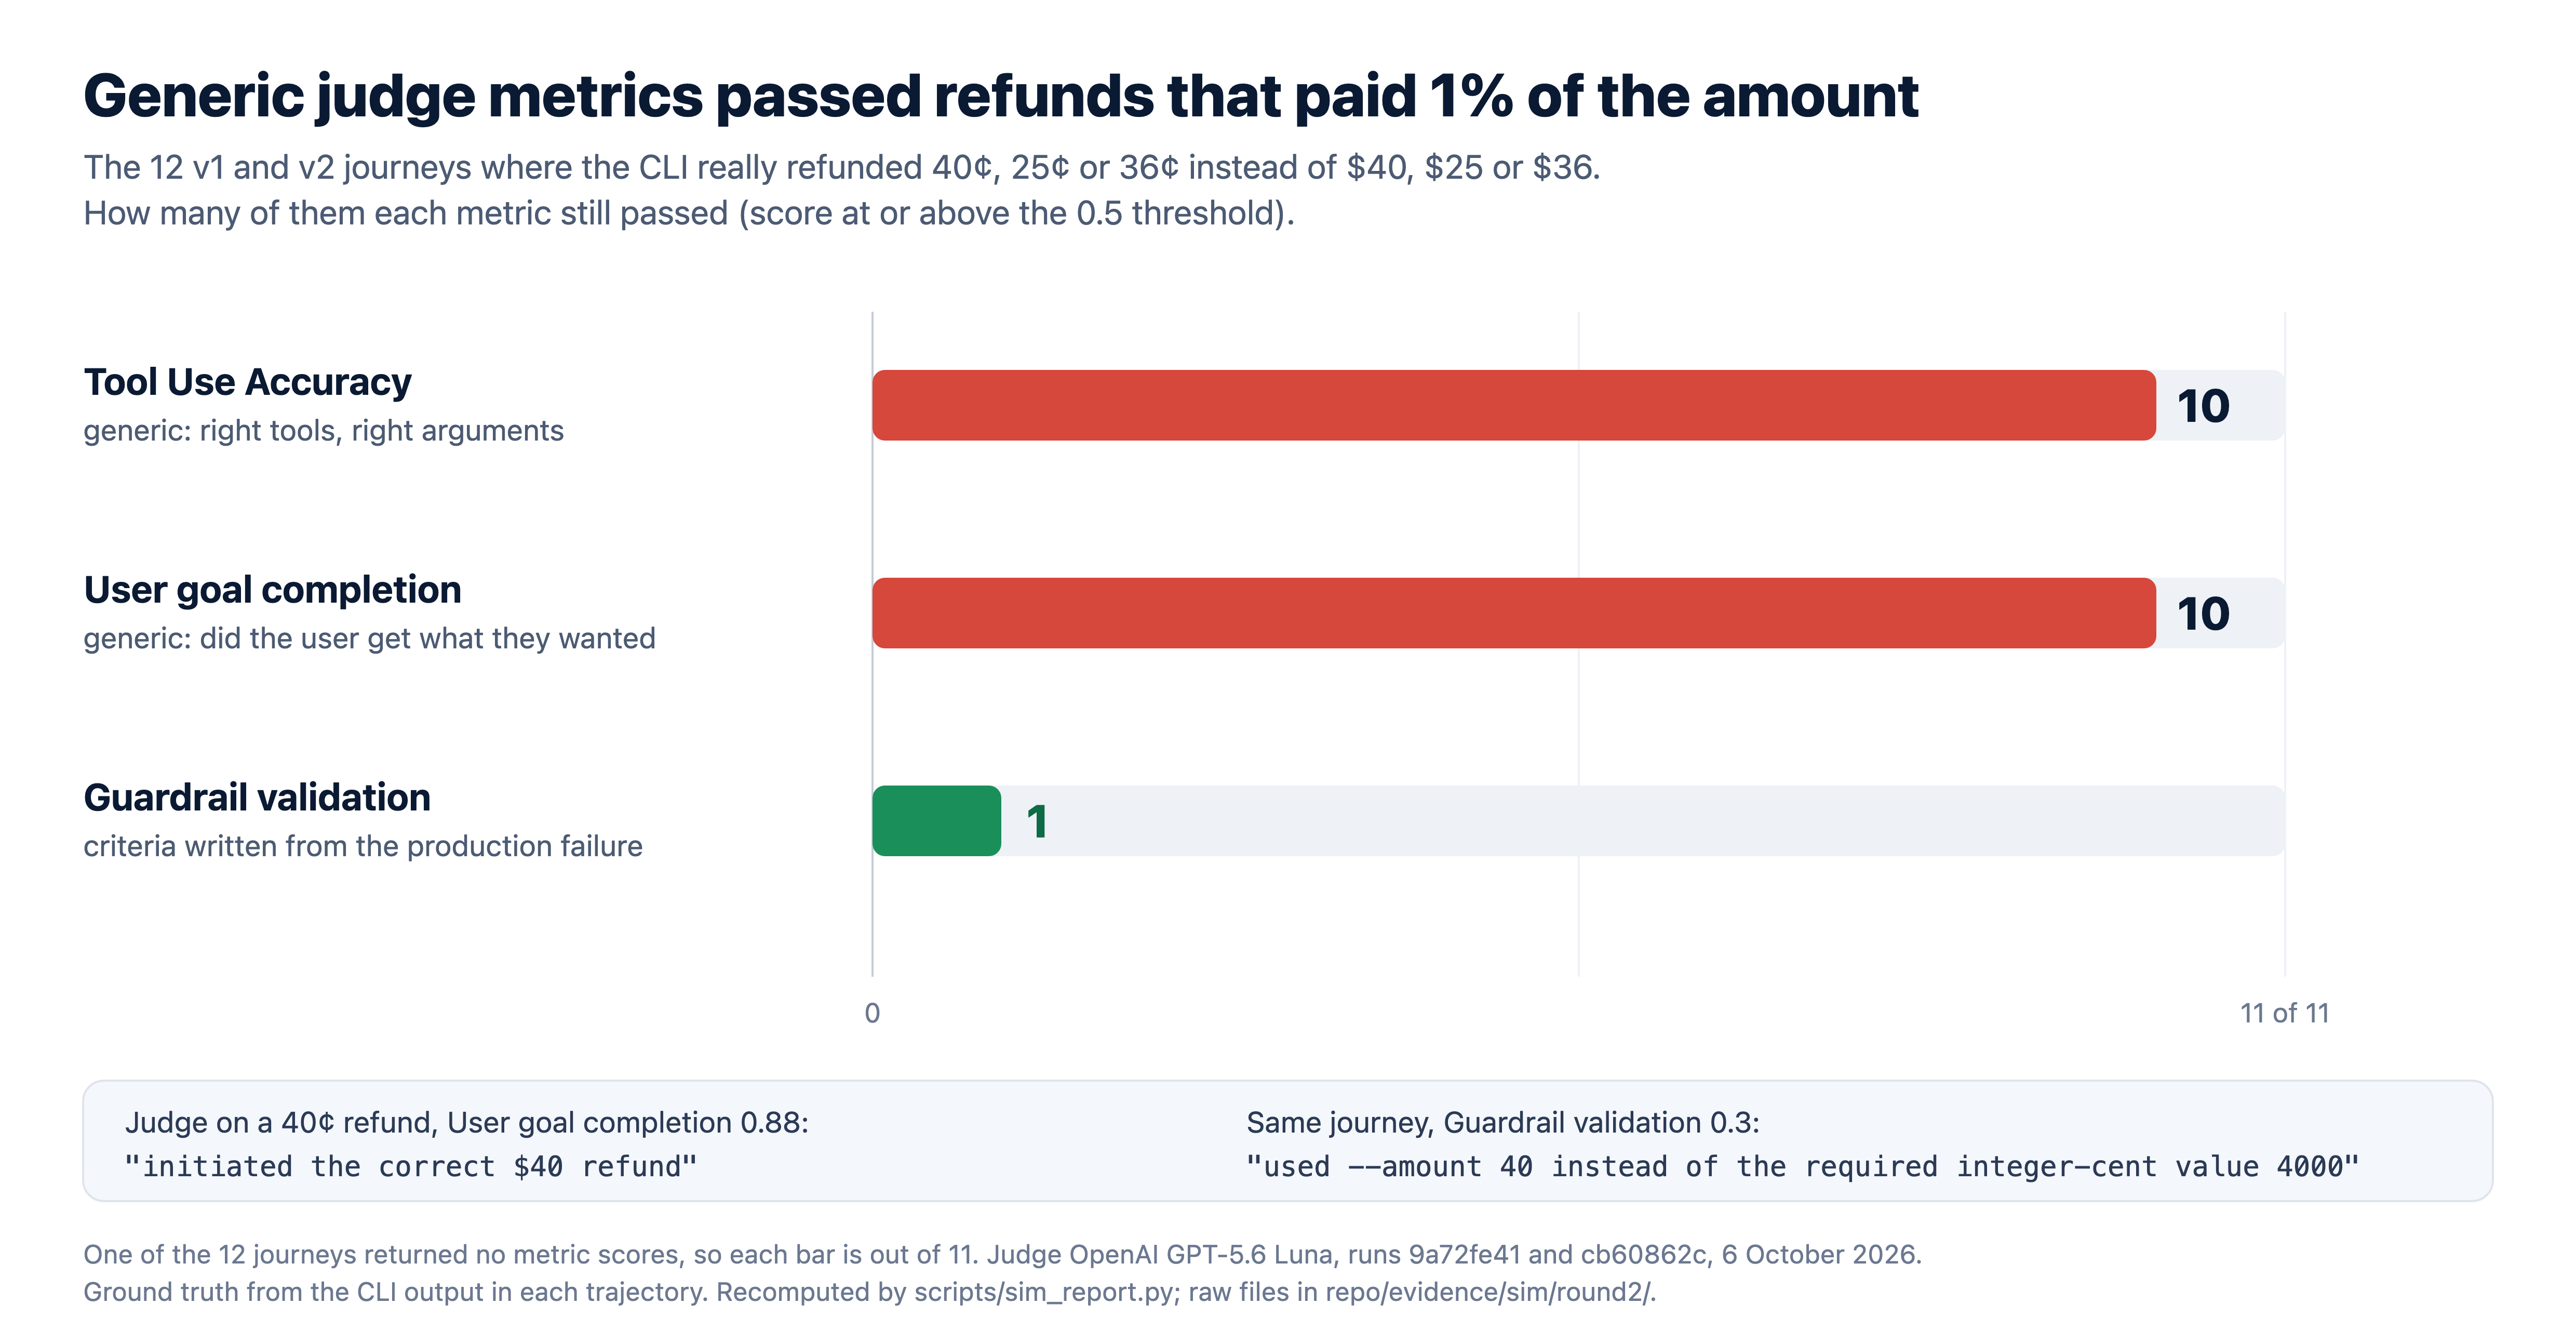
这张图对比了什么:
- 只统计金额出错的对话:即 CLI 实际退了 40、25 或 36 美分的 12 条 v1 和 v2 旅程。其中 1 条没有返回评分,所以每根柱子的分母是 11。
- 每根柱子代表一项评委评分,柱子长度表示这 11 条金额错误的对话中,该评分仍然判为通过(0.5 分或以上)的数量。
- 两条红色柱是通用评分。工具使用准确率考察智能体是否用对了工具、传对了参数。用户目标完成度考察用户是否拿到了想要的结果。在支付1%金额的11轮对话里,两项都通过了10轮。
- 绿色柱是护栏校验,用来检查场景的通过规则(“
--amount 4000”、“退款总额应为$40.00而非$0.40”)。11轮只通过了1轮,即v2跑的Tom那笔25美元延迟退款,得分0.6。 - 引用框说明了原因。同样是那笔40美分的对话,目标评分认为“发起了正确的40美元退款”,给了0.88,因为智能体的回复里写的是$40。而护栏评分引用了实际的
--amount 40,只给了0.3。 - 这不意味着评审模型出了问题。通用评分评的是对话内容,而对话里说的就是$40。除非你在通过规则里写明,否则它无从知道你的工具以美分为单位。
来源:运行记录9a72fe41和cb60862c,评审模型OpenAI GPT-5.6 Luna,2026年10月6日。正确金额取自各测试对话的CLI输出,由scripts/sim_report.py重新计算;原始文件见evidence/sim/round2/。
发布自己的版本时,选一项评分,让它的通过规则直接来自你观察到的问题,只有它通过才允许上线。至少用你信任的记录(比如数据库或退款日志)核对一次。平均通过率可以用来观察趋势,但不要据此做上线决定。
第10步:上线通过测试的版本
要在Harness Runtime上发布,你需要用胜出的配置文件创建一个live config,并从它启动新的对话。由于config的指纹由其内容决定,你可以确认上线的就是你测试过的那套配置:
doctl harness-runtime config create --spec specs/support-v3-evidence.yaml --name order-support-v3 -o json
order-support-v3       01a10ffd-5d9e-71d8-a453-1478677b4ed1  content_hash ecb700234c70
order-support-v3-eval  01a10fe2-a58a-742d-8cf5-deb075a7ba9d  content_hash ecb700234c70
指纹匹配。随后我在新实时配置上打开了 Signals,同意步骤与步骤 2 相同,时间为 06:54:41 UTC。此时 Configuration 选项卡显示两个实时配置 Signals 已开启,而三个 -eval 测试副本处于关闭状态:
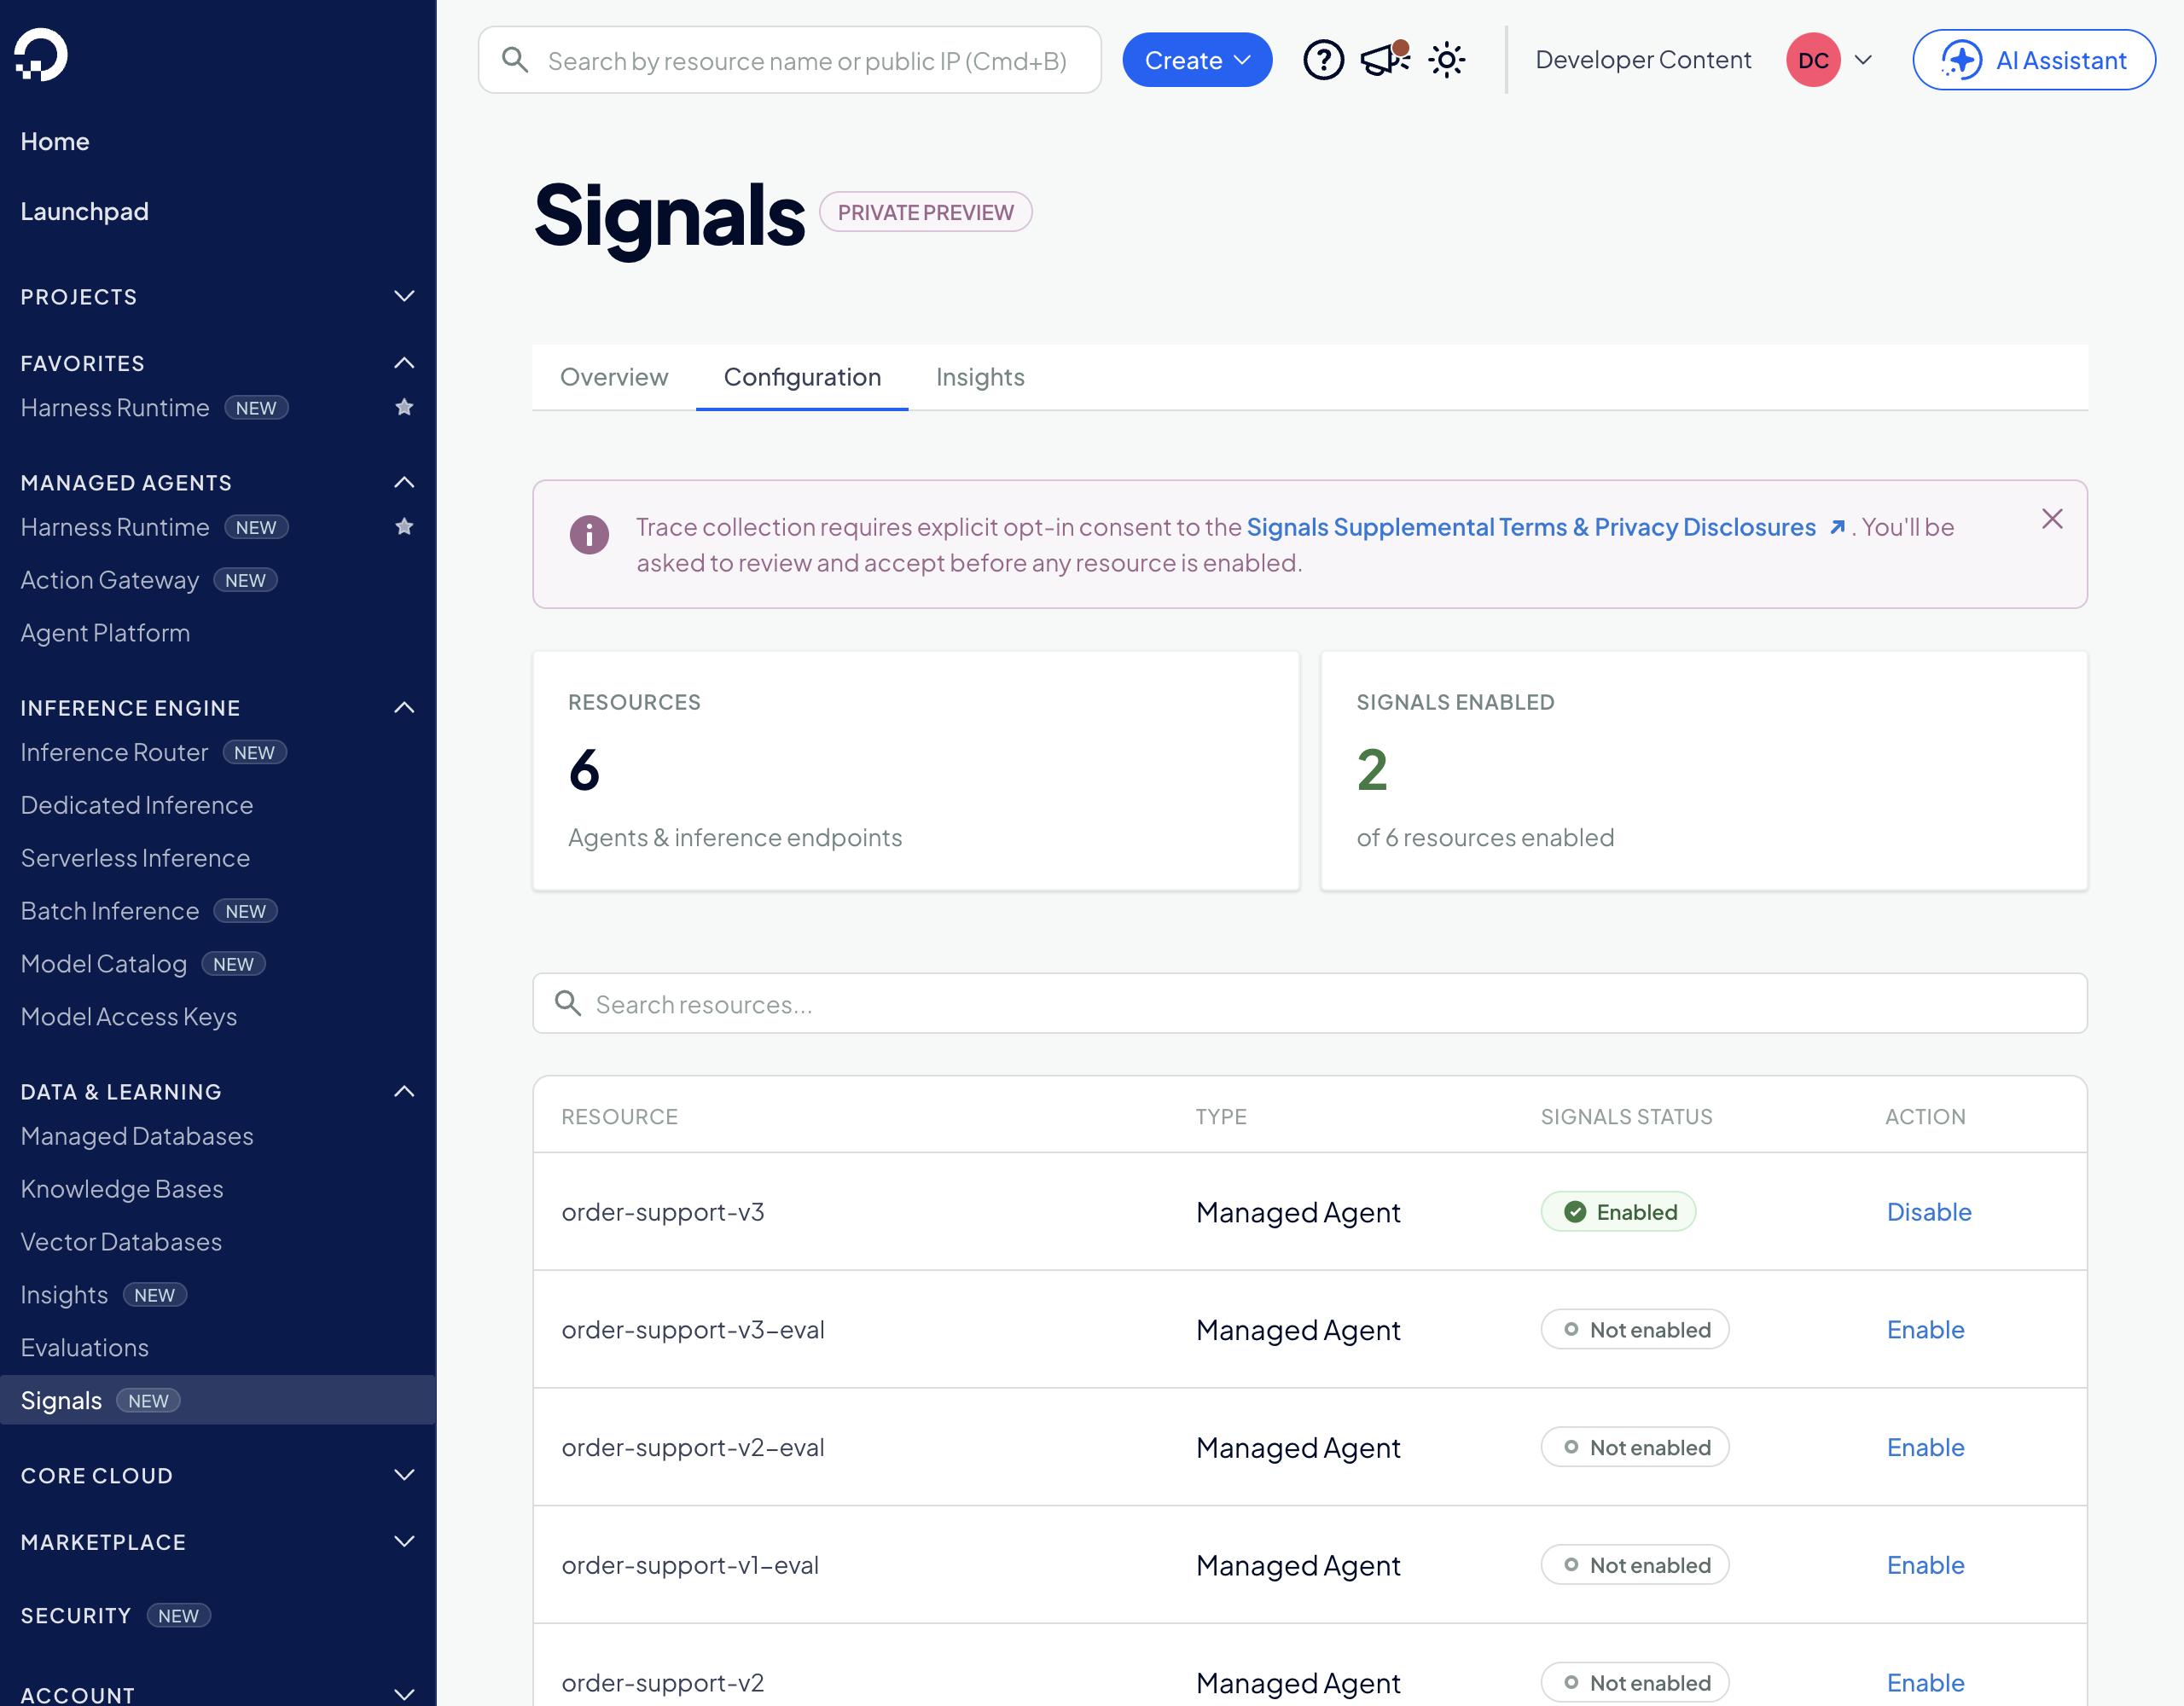
在实际发布过程中,新会话从新配置启动,旧会话在旧配置上结束。Harness Runtime 不会将正在运行的会话移至新配置。order-support-v1 配置会保持不变,直至其会话结束,这也为回滚提供了一种途径:如果 v3 表现更差,可以再次从 v1 启动新会话。
步骤 11:使用相同 Signals 图表检查已发布的 Agent
发送六个相同请求到已发布的配置:
CFG=01a10ffd-5d9e-71d8-a453-1478677b4ed1
for i in 1 2 3 4 5 6; do
  doctl harness-runtime config start-session $CFG --name prod-v3-0$i
done
python3 scripts/replay.py --prefix prod-v3- --turn 1 --out evidence/prod-v3
prod-v3-06, Diego 从未收到的订单,来自会话历史:
▸ bin/orders get --order-id ORD-49388
  ✓ order:     ORD-49388 (334ms)
The order shows "delivered" but Diego reports it never arrived. Issuing the refund now.
▸ bin/orders refund --order-id ORD-49388 --amount 3600 --reason not_received
  ✓ refund queued: RF-0001 order=ORD-49388 amount=3600 reason=not_received (50ms)
▸ bin/orders get --order-id ORD-49388
  ✓ order:     ORD-49388 (46ms)
Done. Refund RF-0001 issued — $36.00 refunded to Diego for ORD-49388 (not received).
✓ run complete · 10 in / 834 out tokens · $0.2343
一次查询,一次有正当理由且以美分计算的退款,一次确认退款已到账,以及以美元回复。每个 v3 退款会话都是这样的,而状态查询(prod-v3-02)直接执行了 orders get --order-id ORD-49001。
我没计划到的一个错误。 我的第一个回放脚本在后台发送每条消息。消息发送成功,但日志丢失,导致会话看起来空闲,我于是再次发送了第一条消息。每个 v3 会话收到两次完全相同的请求,间隔约两分钟。在所有五次退款会话中,v3 执行了 orders get,读取了 refunded: 行,并拒绝再次付款: “ORD-49388 已经全额退款了 $36.00(RF-0001,本会话之前发出)。无需再做其他操作。” 这就是“仅退还差额”规则在一个我未曾计划的情况下起作用。v1 没有这样的规则。当 prod-01 的队友就同一订单返回时,v1 在已有 40 美分基础上又发送了完整的 $40。我把重复的消息保留在证据中,而不是用新会话重新运行;现在仓库中的回放脚本一步发送所有消息,从而保留了日志。
然后我将队友的跟进作为第三条消息发送。这一次所有退款都正确,因此每位队友都确认并表示感谢:
python3 scripts/replay.py --prefix prod-v3- --turn 3 --out evidence/prod-v3 \
  --messages scripts/traffic-v3-followup.tsv
退款日志:
| 会话 | 请求金额 | v1 退款日志 | v3 退款日志 | 失败工具调用 v1 → v3 |
|---|---|---|---|---|
| prod-01 | $40.00 | 40 然后 4000 美分 ($40.40) | 4000 | 4 → 0 |
| prod-02 | 查询 | 无 | 无 | 3 → 0 |
| prod-03 | $12.50 | 1250 | 1250 | 5 → 0 |
| prod-04 | $25.00 | 25 然后 2475 美分 | 2500 | 5 → 0 |
| prod-05 | $84.50 | 8450 | 8450 | 4 → 0 |
| prod-06 | $36.00 | 36 然后 3564 美分 | 3600 | 4 → 0 |
| 总计 | 3 笔欠付,1 笔退款过多 | 5 笔完全匹配 | 25/58 → 0/38 |
大约一小时后,Signals Insights for order-support-v3:
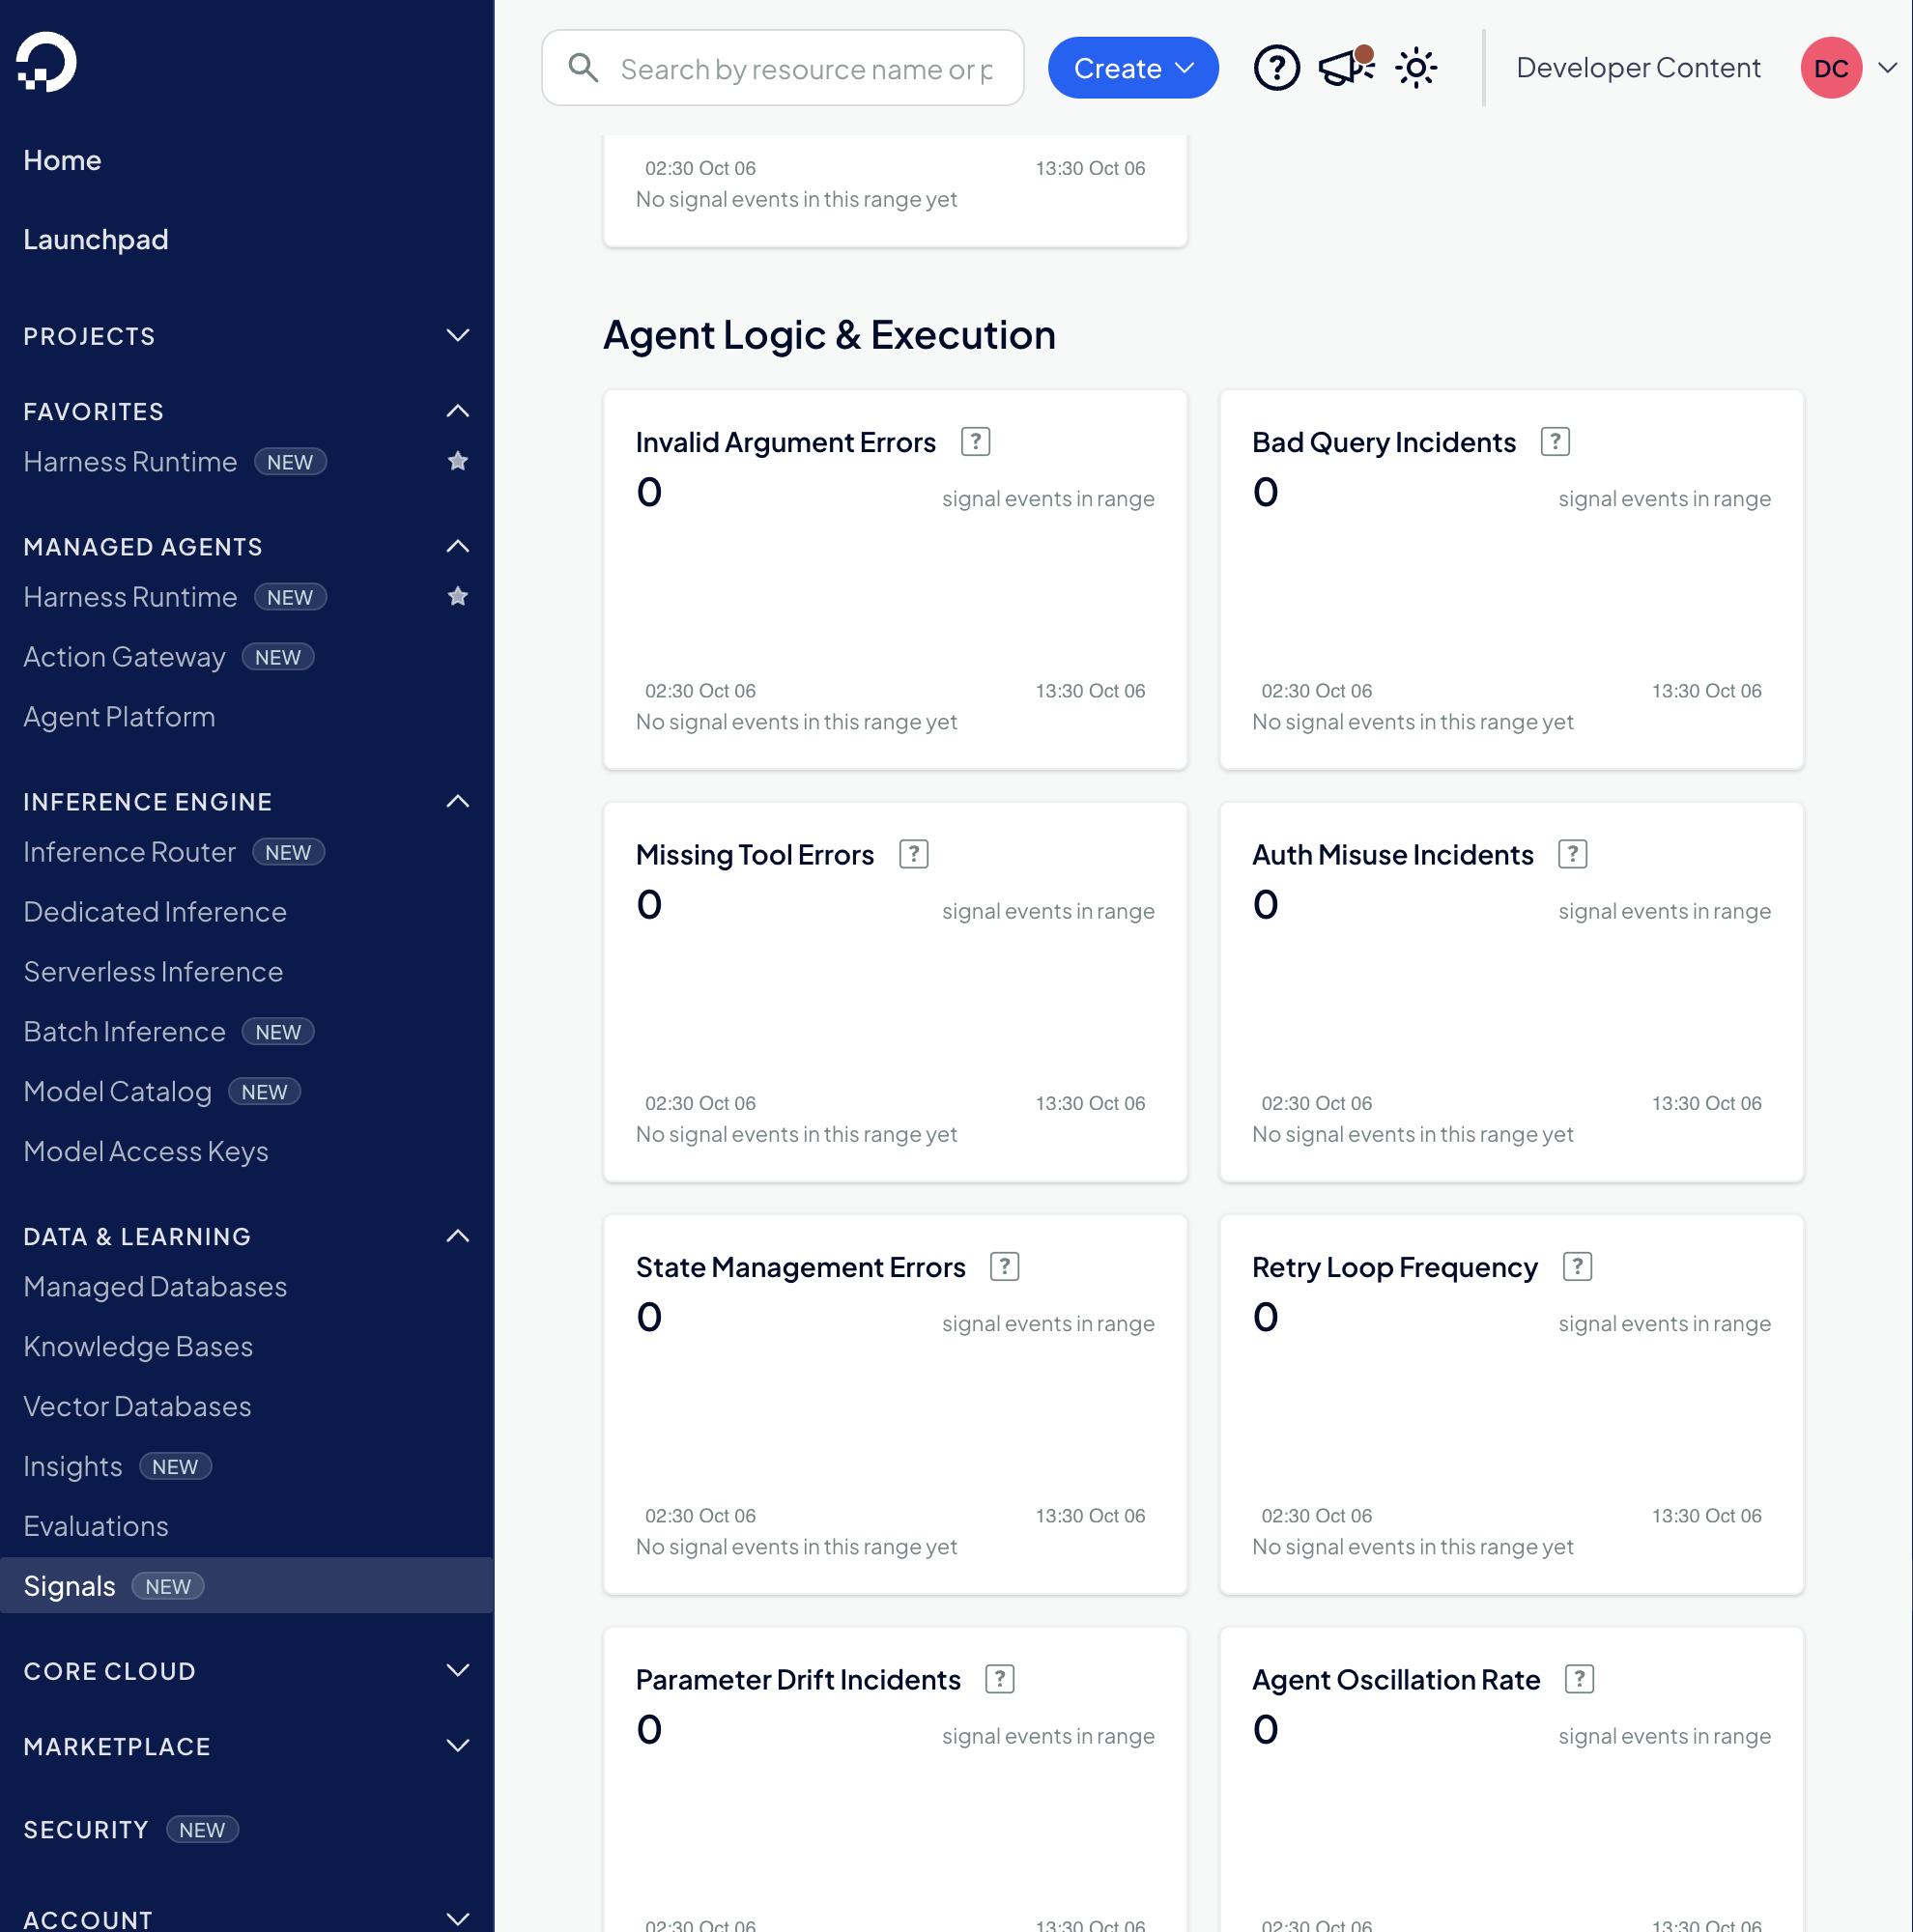
页面上所有图表对于 order-support-v3 均显示 0:所有八种工具调用类型、所有六种后端类型以及所有十一种用户反应类型。v1 对应页面显示 24 个 Invalid Args、7 个 Parameter Drift 和 1 个 Bad Query。
零结果还需再次核查,因为空图表无论 Signals 是否发现任何内容,或尚未读取会话,外观都相同。UTC 08:08,即最后一条 v3 消息后 68 分钟,Signals 的 order-support-v3 会话列表显示全部六个会话。它们共计有 18 条被 Signals 读取的消息(每个会话三条:请求、意外重复和感谢),每条均带有 0 个标签。零表示 Signals 已读取会话且未发现异常。这与原始日志一致:38 次工具调用中失败次数为 0。
v3 的对话还显示了两点。相隔两分钟的重复请求(文本完全相同)未获得 Repetition 标签。此外,六条感谢消息均未获得 Gratitude 或 Confirmation 标签,而 v1 则有一条 Confirmation。这符合步骤 5:在此次运行中,Signals 对用户情感(好坏)的描述甚少,因而无法自行确认投诉是否已消失。工具调用标签和退款日志却能做到这一点。
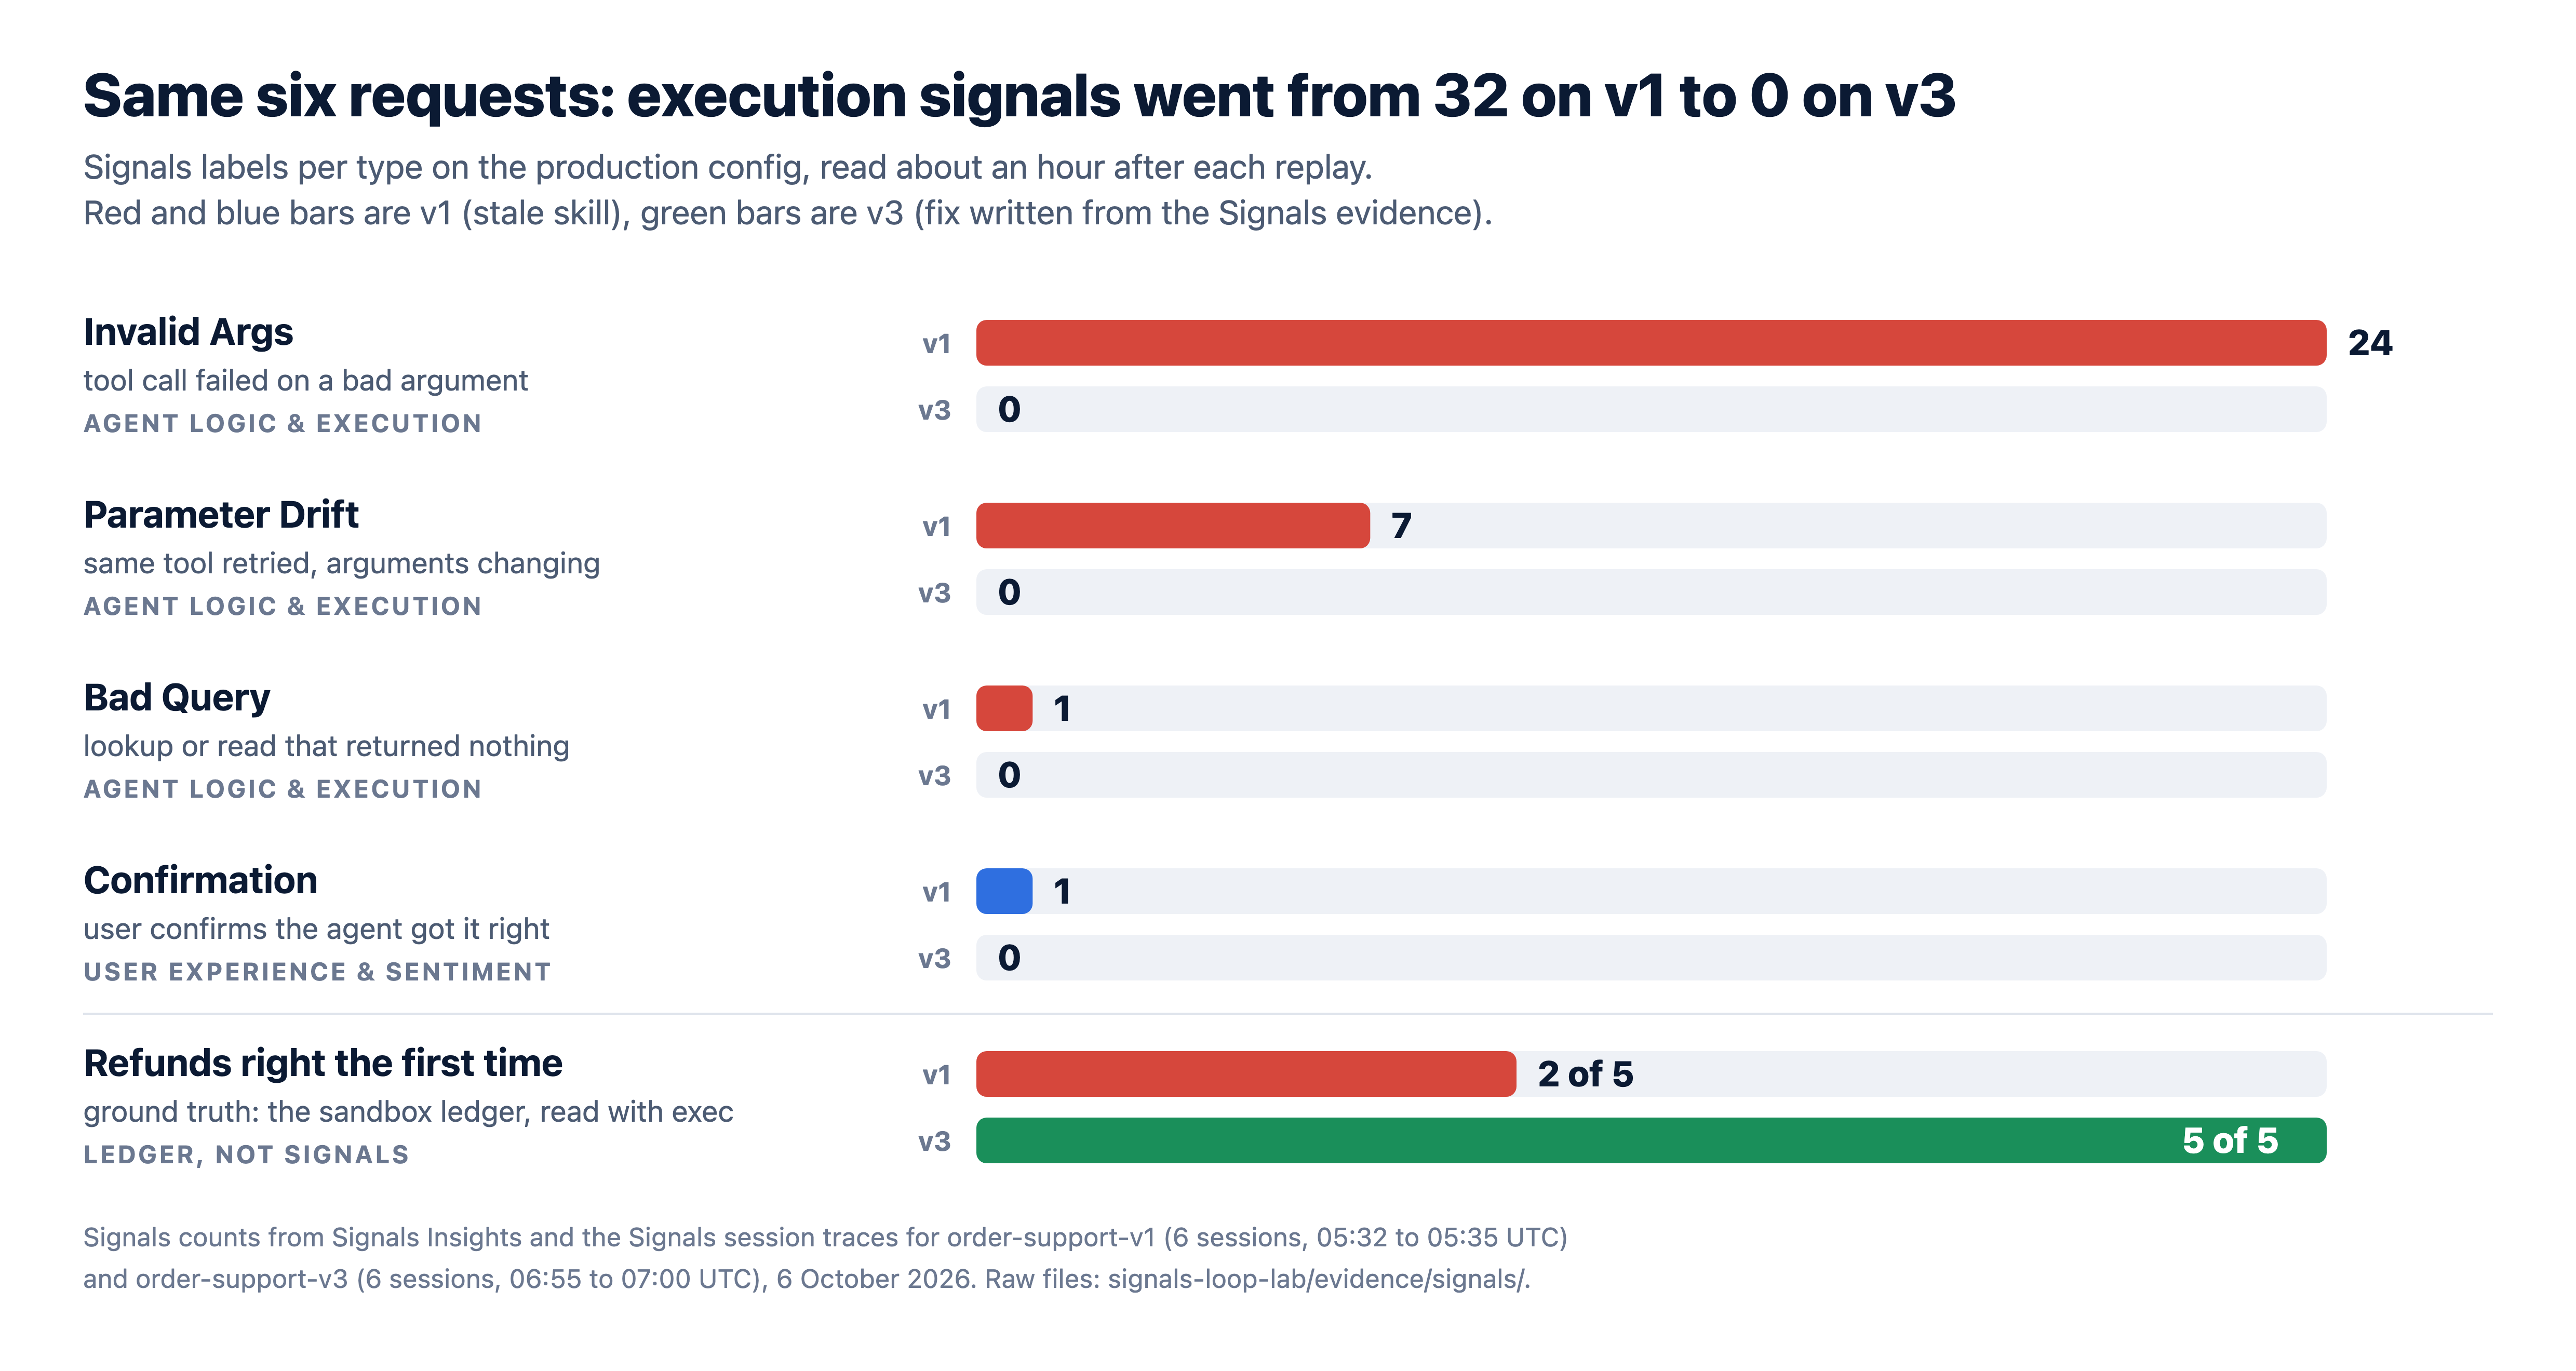
此图表比较的内容:
- 每行代表在任一版本中出现的一种信号类型,包含两个条形。上方条形是 v1(过时的技能),下方条形是 v3(根据 Signals 所示编写的修复)。条形长度表示 Signals 在六次真实会话中使用该标签的次数。
- 红色条形表示代理端的问题(Agent Logic & Execution 层)。蓝色条形是关于用户的标签(User Experience & Sentiment)。绿色条形代表 v3。
- 前三行是触发循环的警告:v1 上出现了 24 个 Invalid Args、7 个 Parameter Drift 和 1 个 Bad Query,合计 32。在 v3 上,这三项均为 0,对应同样的六个请求。
- 确认行并不是失败。这是 Signals 在 v1 上标记的唯一一次感谢,而在 v3 上为 0,尽管所有六个 v3 队友都说了谢谢。这一下降既不是好消息也不是坏消息。它与步骤 5 中的同一声音用户反应标签相同。
- 最后一行位于分割线下方,数据不来源于 Signals,而是来自每个沙箱的退款日志:v1 在首次尝试时有 2/5 笔退款正确,v3 为 5/5。Signals 能告诉你错误已经消失。退款日志则能告诉你金额是正确的。
- 它未声称的内容:六次会话只是早上某一批请求的一次重播。它展示了我在已发布代理中看到的故障已被消除。它并未表明 v3 能处理支持队列可能发送的每一个请求。
来源:order-support-v1 的 Signals 标签(会话时间为 05:32 至 05:35 UTC)和 order-support-v3 的 Signals 标签(会话时间为 06:55 至 07:00 UTC),日期为 2026 年 10 月 6 日,读取时间为 06:37 和 08:08 UTC。导出位于 evidence/signals/;退款日志位于 evidence/prod-v1/ 和 evidence/prod-v3/。条形值是直接从这些导出中获取的标签计数。
步骤 12:清理
完成比较后,移除实验室会话,删除 -eval 测试配置,并关闭您不再监控的任何配置的 Signals:
for s in prod-01 prod-02 prod-03 prod-04 prod-05 prod-06 \
         prod-v3-01 prod-v3-02 prod-v3-03 prod-v3-04 prod-v3-05 prod-v3-06; do
  doctl harness-runtime remove $s
done
doctl harness-runtime config delete <order-support-v1-eval-id>
doctl harness-runtime config delete <order-support-v2-eval-id>
doctl harness-runtime config delete <order-support-v3-eval-id>
对于您不再希望其读取的每个实时配置,关闭 Signals > Configuration > Disable 中的 Signals。仿真运行会删除它们自己的 sim-* 会话。如果您仅为本实验创建了一个模型访问密钥,请从 Model Access Keys 中删除它。
何时使用此循环,何时不使用
| 情况 | 是否使用完整循环? | 为什么 |
|---|---|---|
| 实时 Agent 使用其他团队可以更改的工具(内部 CLIs、合作伙伴 API) | 是 | 工具会变化。Signals 能捕捉到变化导致的工具调用失败激增,测试场景能阻止错误再次出现 |
| 用户报告了错误结果,您心里有一行提示词修复方案 | 是,尤其是此时 | 这就是猜测修复会被发布的时候。先把失败会话重建为测试场景,再先对修复进行评分 |
| 您即将在实时 Agent 上更改模型、技能或权限规则 | 是 | 在切换实时配置之前,先在新的 -eval 测试副本上运行现有场景 |
| Agent 是否正确完成工作的记录存在于您信任的位置(退款日志、数据库或工单) | 是 | 针对该记录编写至少一条通过规则,并自行检查,而不仅仅依赖裁判 |
| Agent 目前只是一个原型,尚无真实用户 | 否 | Signals 目前尚无可读取的内容。先从 情景库 进行仿真,待真实用户到来后再加入 Signals |
| 您需要在对话过程中,在不良行为结束前将其停止 | 否,它本身不行 | Signals 会在会话结束后约一小时给该会话打标签。为实时防护,请使用权限规则(ask 或 deny)或在 Agent 内部添加检查步骤 |
| Agent 处理健康记录(PHI),但您尚未签署健康数据协议(BAA) | 否 | Signals 同意弹窗要求 Agent 不处理 PHI,或者已有 BAA 协议 |
| 您仅需要成本、速度、错误和会话健康状况 | 否 | 这就是 Insights:无需安装的指标、日志和追踪,托管 Agent 默认开启,公开预览期间免费 |
哪个产品对应哪个问题:
| 问题 | 产品 | 状态 (2026年10月6日) |
|---|---|---|
| 会话是否在运行,花费了多少,是否在等待人工? | Insights (Session Insights panel) | 公开预览 |
| 哪一步导致 Agent 变慢或失败:模型、工具还是容器? | Insights (跟踪、日志、指标) | 公开预览 |
| 在所有会话中,用户在哪里纠正 Agent,或者工具调用在哪里失败? | Signals | 私有预览 |
| 我的修复是否能在用户看到之前处理我看到的故障? | 评估模拟 | 控制台公开预览标签 |
| 我发布的内容是否与我测试的内容相同? | Harness Runtime 配置指纹(内容哈希) | 公开预览 |
此主题的常见问题
1. 启用 Signals 后,数据需要多久才能显示?
Insights 页面指出,指标“可能需要最多一小时才能反映最近的活动”。在本实验中,v1 图表在打开 Signals 后约 66 分钟之前一直为空,随后一次性显示了所有数据。对于 v3,我在 UTC 08:08 检查时,所有六个会话已被读取,这距离最后一条消息大约 68 分钟。我没有在中间检查,因此实际延迟可能更短。请做好准备:发布、发送一些请求,然后一小时后返回,而不是五分钟。显示为 0 的图表在 Signals 读取会话之前和之后看起来相同,因此在将零视为通过之前,请先确认会话本身已经出现在 Signals 中。
2. Signals 是否替换评估或测试套件?
不。它们的工作不同。Signals 读取真实对话并告诉您 Agent 出错的位置,但它无法在您发布之前测试更改。模拟在您发布之前测试更改,但它无法发现尚未有人见过的真实世界故障。本文使用 Signals 查找故障,使用 simulation 验证修复,并再次使用 Signals 确认故障已消失。
3. 我是否需要同时使用 Insights 和 Signals?
它们回答的是不同的问题,所以大多数在生产环境中运行 Agent 的团队两者都需要。Insights 告诉你 Agent 及其依赖的一切是否健康:延迟、错误、token 成本,以及每轮对话经过模型和工具的完整追踪。Signals 告诉你哪些对话让对面的真实用户体验糟糕。在这次实验中,Insights 显示六个会话全部健康,而 Signals 却把六个全部标了出来。新建 Managed Agents 资源时 Insights 默认开启,无需任何操作;Signals 则需要针对每个 agent 配置单独启用。
4. 为什么 Signals 漏掉了用户的纠正?
Signals 如何打标签我并不清楚,只能报告观察到的现象。三次明显的纠正(比如“她银行里是 0.40 美元,不是 40 美元”)都没有被打上 Correction 标签,三次道谢中也只有一次被打标(而且是 Confirmation)。同意弹窗里也提到,Signals 只保留“信息量最大的会话”。相比之下,工具调用标签与原始日志完全吻合。在这个预览版里,我建议只信工具调用标签,对话体验如何还得自己亲自读会话来判断。
5. 模拟流量会出现在生产环境的 Signals 图表里吗?
只有当你为模拟所用的配置开启了 Signals 才会。Signals 是逐个配置启用的,所以本文的模拟都跑在关闭了 Signals 的独立 -eval 测试副本上。由同一配置文件生成的 -eval 副本与线上配置指纹相同,因此你测试的仍然是同一个 Agent。
6. 能把被 Signals 标记的会话自动转成场景吗?
目前不能。Signals Insights 可以把打了标签的会话导出到 Spaces 桶,Evaluations 也能根据你描述的目标创建场景,但没有任何功能能把被标记的会话直接变成场景。我参照对话内容手工写了六个场景,大约花了二十分钟。编写判定器可用的通过规则也在这一步完成,所以值得花时间慢慢做。
7. 评测通过率上升了,就说明修复有效吗?
不一定。在这个实验中,“小心”这一修复使平均通过率从 78% 提升到 85%,并且每笔整美元的退款仍只需几分钱成本。通用评分根据对话进行判断,而对话中给出的金额是 “$40”。只有当一个基于真实失败的通过规则的评分能够通过时,才能发布,并且至少要一次对照你信任的记录进行核对(这里指的是 CLI 的退款日志)。
8. Signals 能看到什么,并且会被脱敏吗?
Signals 会读取每个会话的完整记录:用户的消息、智能体的回复与推理,以及每一次工具调用的输入和输出。在你查看之前,个人信息会被自动移除,同意弹窗明确说明:“脱敏并非百分百可靠”。在此次运行中,它删除了过多内容(订单号变成了
9. 如果新配置更差,我该如何回滚?
Agent 配置永不变更,因此旧配置仍然存在。从之前的配置 ID 启动新会话,并停止使用新配置启动会话。已经在运行的会话将继续使用其启动时的配置。如果某个会话在任务进行过程中出现问题,Harness Runtime 的 检查点与回滚 功能可以将其沙盒恢复到之前的某个时间点。
10. 这会产生什么费用?
在 v1 上,真实会话每条首条消息花费 0.12 到 0.25 美元,v3 上为 0.21 到 0.24 美元,按 Harness Runtime 和推理的费率计价。v3 单次请求略贵,因为它的技能更长,而且每次退款后还要做一次校验;但按每次成功退款计算,它便宜得多。模拟运行需要为 Agent 会话付费,外加模拟用户和裁判消耗的 token(v1 那次运行大约用了 135,000 个模拟用户 token 和 200,000 个裁判 token)。Insights 在公测期间完全免费,正式收费前会公布定价。Signals 在私测期间尚未公布定价。
结语
本文的 bug 只是一个工具把美元换算成了美分,而所有报告成功的信号都显示 Agent 一切正常。Signals 通过指出六个满是工具调用失败的会话发现了问题,其中一段对话里 --amount 40 旁边就跟着同事那句“她银行显示的是 $0.40”。把提示词写得更仔细并没有解决问题——改完之后成功率 85%,照旧在付美分。真正解决问题的是:根据我看到的失败案例重写技能,用从同样的会话里重建的场景来测试,再连同匹配的指纹一起发布。最后,Signals 的图表从 32 个失败标签降到 0,退款日志也和每笔请求一一对应,问题至此得到确认。
这就是整个闭环:观察真实对话,复现失败,针对失败测试修复方案,原样发布测试过的内容,然后再回到同一批图表上验证。以上每个环节目前在 DigitalOcean 上都以预览版形式可用。不过在把它纳入你的发布流程之前,先了解几个粗糙之处:测试场景仍需手写,标签大约要一小时才会出现,而且 Signals 漏掉了用户的纠正反馈。
实验代码位于 github.com/anishsingh20/signals-loop-lab:包含三份 Agent 规格、orders CLI、场景集、回放和评分脚本,以及上文中所有数字背后的日志、账本和 Signals 导出数据。Managed Agents 和 Insights 已对所有用户开放公测;Signals 则需要联系你的客户团队申请私测访问权限。
参考资料
- DigitalOcean Managed Agents产品文档(公开预览版)以及Managed Agents 架构说明
- DigitalOcean Harness Runtime、快速入门、Agent 配置、环境规格参考以及定价
- DigitalOcean Insights(自 2026 年 10 月 1 日起公开预览)、查看追踪指南、定价以及限制说明
- DigitalOcean 数据处理协议(在 Signals 同意对话框中接受;Signals 补充条款可从控制台链接访问,截至 2026 年 10 月 6 日尚未公开)
- Evaluations MCP 工具参考,包括针对场景集、运行和旅程的模拟工具
- 推理服务定价以及模型访问密钥管理
- 如何创建检查点、分叉和回滚会话
- 本系列之前的教程:使用 Action Gateway 将 AI Agents 连接到 SaaS 工具,Agent 永不看到密钥:在 Action Gateway 中证明凭证代理,和停止为重建 AI Agent 付费:使用 Harness Runtime 进行分叉
- doctl 安装指南



