想象一下,凌晨两点有一张工单进来。客户因他们说是误创建且从未产生流量的实例被收取了 6,868 美元,他们想要退款。你的 AI 支持智能体已经唤醒,几秒钟就读完了。你能否把这张工单交给它处理,归根结底只有一个问题:什么能阻止它直接回复“已退款”?
大多数团队会在系统提示词里加一行来应对。这一行是一种请求,而每张工单都是陌生人写的文本,因此任何工单都可能与之争论。我们则直接移除了该能力。本文中的智能体能够读取队列、认领工单并发布草稿。它所能触及的一切都不会发送回复。由人工点击发送。
我们在真实的支持看板上让它无人值守运行了 1 小时 48 分钟:共处理 99 张工单,全部 35 张敏感工单被拦下交人处理,零条回复被发送。 这就是构建日志:设计、数据、错误来源于我们而非模型,以及让它持续运行的成本。
Agents in Production 是 DigitalOcean 推出的一系列关于在真实工作队列中运行 AI 智能体的内容。在这一部分,你将学习如何使用我们新推出的 Managed Agents Harness Runtime 构建一个过夜 AI 支持智能体,它能够处理过夜积压工单,读取全部内容,草拟所有回复,并且不发送任何回复。
本文内容概览
| 主题 | 详情 |
|---|---|
| 产品 | DigitalOcean Managed Agents, specifically Harness Runtime: one hardware-isolated microVM sandbox per agent session, with pause, resume, fork, and checkpoints. |
| 使用场景 | 针对云支持队列的夜间分流。agent 认领每张新工单,对其分类,判断是否需要人工处理,并起草回复。它不会发送任何内容。 |
| 设置 | 在 Frankfurt (fra1) 区域的 App Platform 上部署了一个六列的支持看板,配有 HTTP API,由合成工单生成器提供数据。在 Harness Runtime 的预览版上运行一个 agent 会话,规格为 mars-2vcpu-4gb。 |
| 运行 | 2026 年 10 月 3 日,10:39:55Z 至 12:27:44Z。在新工单持续到来的过程中,agent 认领并分流了 99 张工单。 |
| 适用对象 | 将 agent 放在支持队列前面的 AI 原生工程团队,以及需要批准它的支持负责人。 |
要点
- 与其禁止发送,不如移除发送能力。给 agent 提供一个不能调用发送路径的凭证,并将提示词指示作为礼貌保留,而非控制手段。缺失的路径无法被争论;提示词指示则可以。
- “无法到达客户”需要两道门。agent 的令牌不能到达发送路径,且沙盒必须没有其他出口。Harness Runtime 的出站流量默认不受限制,因此第二道门只需在规格中添加一行。
- 所有 35 张敏感工单被拦截。同样,27 张常规工单也被拦截,其中 13 张是因数据缺失而非判断失误。agent 没有计费数据,因此它将每个计费问题上报。agent 能安全处理的范围取决于你允许它读取的内容。
过夜队列问题在于顺序而非数量
早上处理过夜队列的人从顶部开始,逐项处理。凌晨 2 点提交的客户需要等待七小时,随后得到当天最仓促的回复,仍有四十张工单在其下方待处理。数量问题是人员配置问题。顺序由早上 9 点正在阅读的人决定。
智能体可以修正顺序:过夜读取全部内容,进行排序,为每张工单起草回复,将需要人工决定的工单置于顶部。设计问题在于它被允许如何利用这种覆盖范围。
过夜支持智能体需要什么
想象为夜班雇佣一个人。在让他们独自面对队列之前,你希望具备五项条件。这些条件与智能体的智力无关:无论给强模型还是弱模型相同的提示词,这五项都不会改变。它们描述了模型运行的环境。
| 需求 | 凌晨 3 点的含义 | 在此构建中由谁提供 |
|---|---|---|
| 能够在无人监督情况下持续工作数小时 | 没有人可以输入“继续” | Harness Runtime 会话;已无人看管运行 108 分钟 |
| 出现故障时能够恢复而非消失 | 没有人可以重新启动它 | 暂停与恢复会保留机器状态和对话;工单索赔需要在你的应用中设置超时 |
| 恶意工单不能诱导其造成危害 | 每张工单均由陌生人编写,其中有些会尝试 | 两道防线:不带发送路线的 token,以及出站允许列表 |
| 繁忙或空闲时成本基本相同 | 夜间大部分时间是在等待 | 按秒计费,今日约每小时 0.06 美元,暂停时无费用 |
| 留下早晨班次可信赖的记录 | 有人需要了解发生了什么 | 你的应用。 平台日志是一个滚动窗口。 |
聊天窗口、笔记本脚本和自托管循环无法继续的地方
在考虑采用新方案之前,先检查你现有的工具在此次转变中何时会失效。
| 选项 | 是否可长时间无人值守 | 是否能自行恢复 | 是否与你的系统隔离 | 空闲成本 | 审计记录 |
|---|---|---|---|---|---|
| 聊天窗口 (Claude, ChatGPT) | 不会。它只有在有人询问时才回答 | 否 | 不适用 | 无 | 仅聊天记录 |
| 笔记本上的 Agent 脚本 | 直到笔记本盖子关闭 | 否 | 共享你的笔记本网络和密钥 | 无 | 你记录的一切 |
| 你在 Droplet 上自行编写的循环 | 是 | 如果你自行构建 | 如果你自行构建 | Droplet 持续运行 24/7 | 如果你自行构建 |
| Harness Runtime 上的托管会话 | 是 | 内置暂停与恢复功能 | 每个会话一个 microVM;出站允许列表仅需一行 | 按秒计费;暂停时无费用 | 滚动事件日志;可自行构建 |
聊天窗口 只有在你提问时才回答,而在过夜队列中,没有人在提问。
笔记本上的 Agent 寿命等同于笔记本本身。这导致我们之前的一次尝试失败:负责向看板送票的脚本运行在笔记本上,笔记本进入睡眠状态,队列因而安静了 90 分钟,而 Agent 在自己的机器上一直等待票据停止送达。在我们进行的测量中,生成器运行在看板自身的 App Platform 应用上。
你在 Droplet 上自行编写的循环 它能够工作,我们想直白地说明这一点。你需要承担的就是运行它:保持进程存活,轮换密钥,决定当进程死亡时半处理票据的后续处理方式,进行重试,并封锁其网络。我们并未构建此路径,因此应将其视为工程判断而非度量。
Harness Runtime 上的托管会话 它是一台机器,而不仅仅是单个请求:具备文件系统,在工具调用之间保持运行的进程,而不是重启而是暂停与恢复,以及其自身的 Firecracker microVM。这满足了五项需求中的四项。第五项持久记录需要你在任一方路径中自行提供。
设计:一个不能发送回复的 AI 支持 Agent
无论是什么在运行 agent,最重要的设计选择是它能够触及的范围。我们的提示词确实要求克制。但指令是一种请求,支持工单可以由任何人编写,而与提示词争论的工单可能会获胜。因此我们关闭了两扇门。
Door 1: agent 的 token 没有可到达客户的路线
agent 通信的看板拥有一个小型 HTTP API。agent 使用四条路由:列出新工单,读取客户记录,认领工单,以及发布带草稿的 triage 结果。第五条路由 decide 是审批、拒绝或发送回复的方式。它需要看板的写入密码,而 agent 永远不会收到它。未提供它时,该路由返回 401:
curl -s -w '\n%{http_code}\n' -X POST \
  "https:///api/tickets/TKT-DOES-NOT-EXIST/decide" \
  -H "Authorization: Bearer $BOARD_AGENT_TOKEN" \
  -H 'Content-Type: application/json' -d '{"action":"noop"}'
{
  "error": "write password required"
}
401
我们在10月6日使用只读密钥对真实看板进行了检查,使用了一个不存在的票据 ID,以确保不会产生任何更改。写入检查在票据查找之前运行。
这是复制到真实客服系统的模式:为智能体颁发仅限读取和评论的 API 凭据,永不允许回复、关闭或退款。如果您的客服系统无法颁发如此受限的凭据,可在其前置一个小型代理,仅暴露智能体所需的路由。
门 2:沙盒别无出路
只有当智能体无法通过其他方式联系客户时,门 1 才重要,例如通过调用它发现的密钥或票据提供的邮件 API 或 webhook。Harness Runtime 明确说明:“在沙盒中运行的代码可以将工作区内容发送到任何可达的主机”,除非规格设置了允许列表,否则出站流量不受限制(Network egress)。只要指定任何主机,就会启用允许列表。随后平台会自行合并会话所需的主机,包括模型端点、GitHub 和 DigitalOcean 的容器注册表。其他所有主机均被拒绝。
把智能体放在应用之外
运行在支持网页应用内的智能体会继承该应用的凭据,包括写入密码及其网络。如果某张票据获取对它的控制,它就能访问应用能访问的一切。将智能体置于独立沙盒中,并通过 HTTPS 让它访问看板——就像它访问客户现有的客服系统一样——这才使得两道门皆有可能。
我们在 DigitalOcean Managed Agents 上运行了我们的实现,这是我们自己的产品。该论点不依赖于此:任何在其中限定凭据并锁定网络的沙盒都能满足相同的需求。
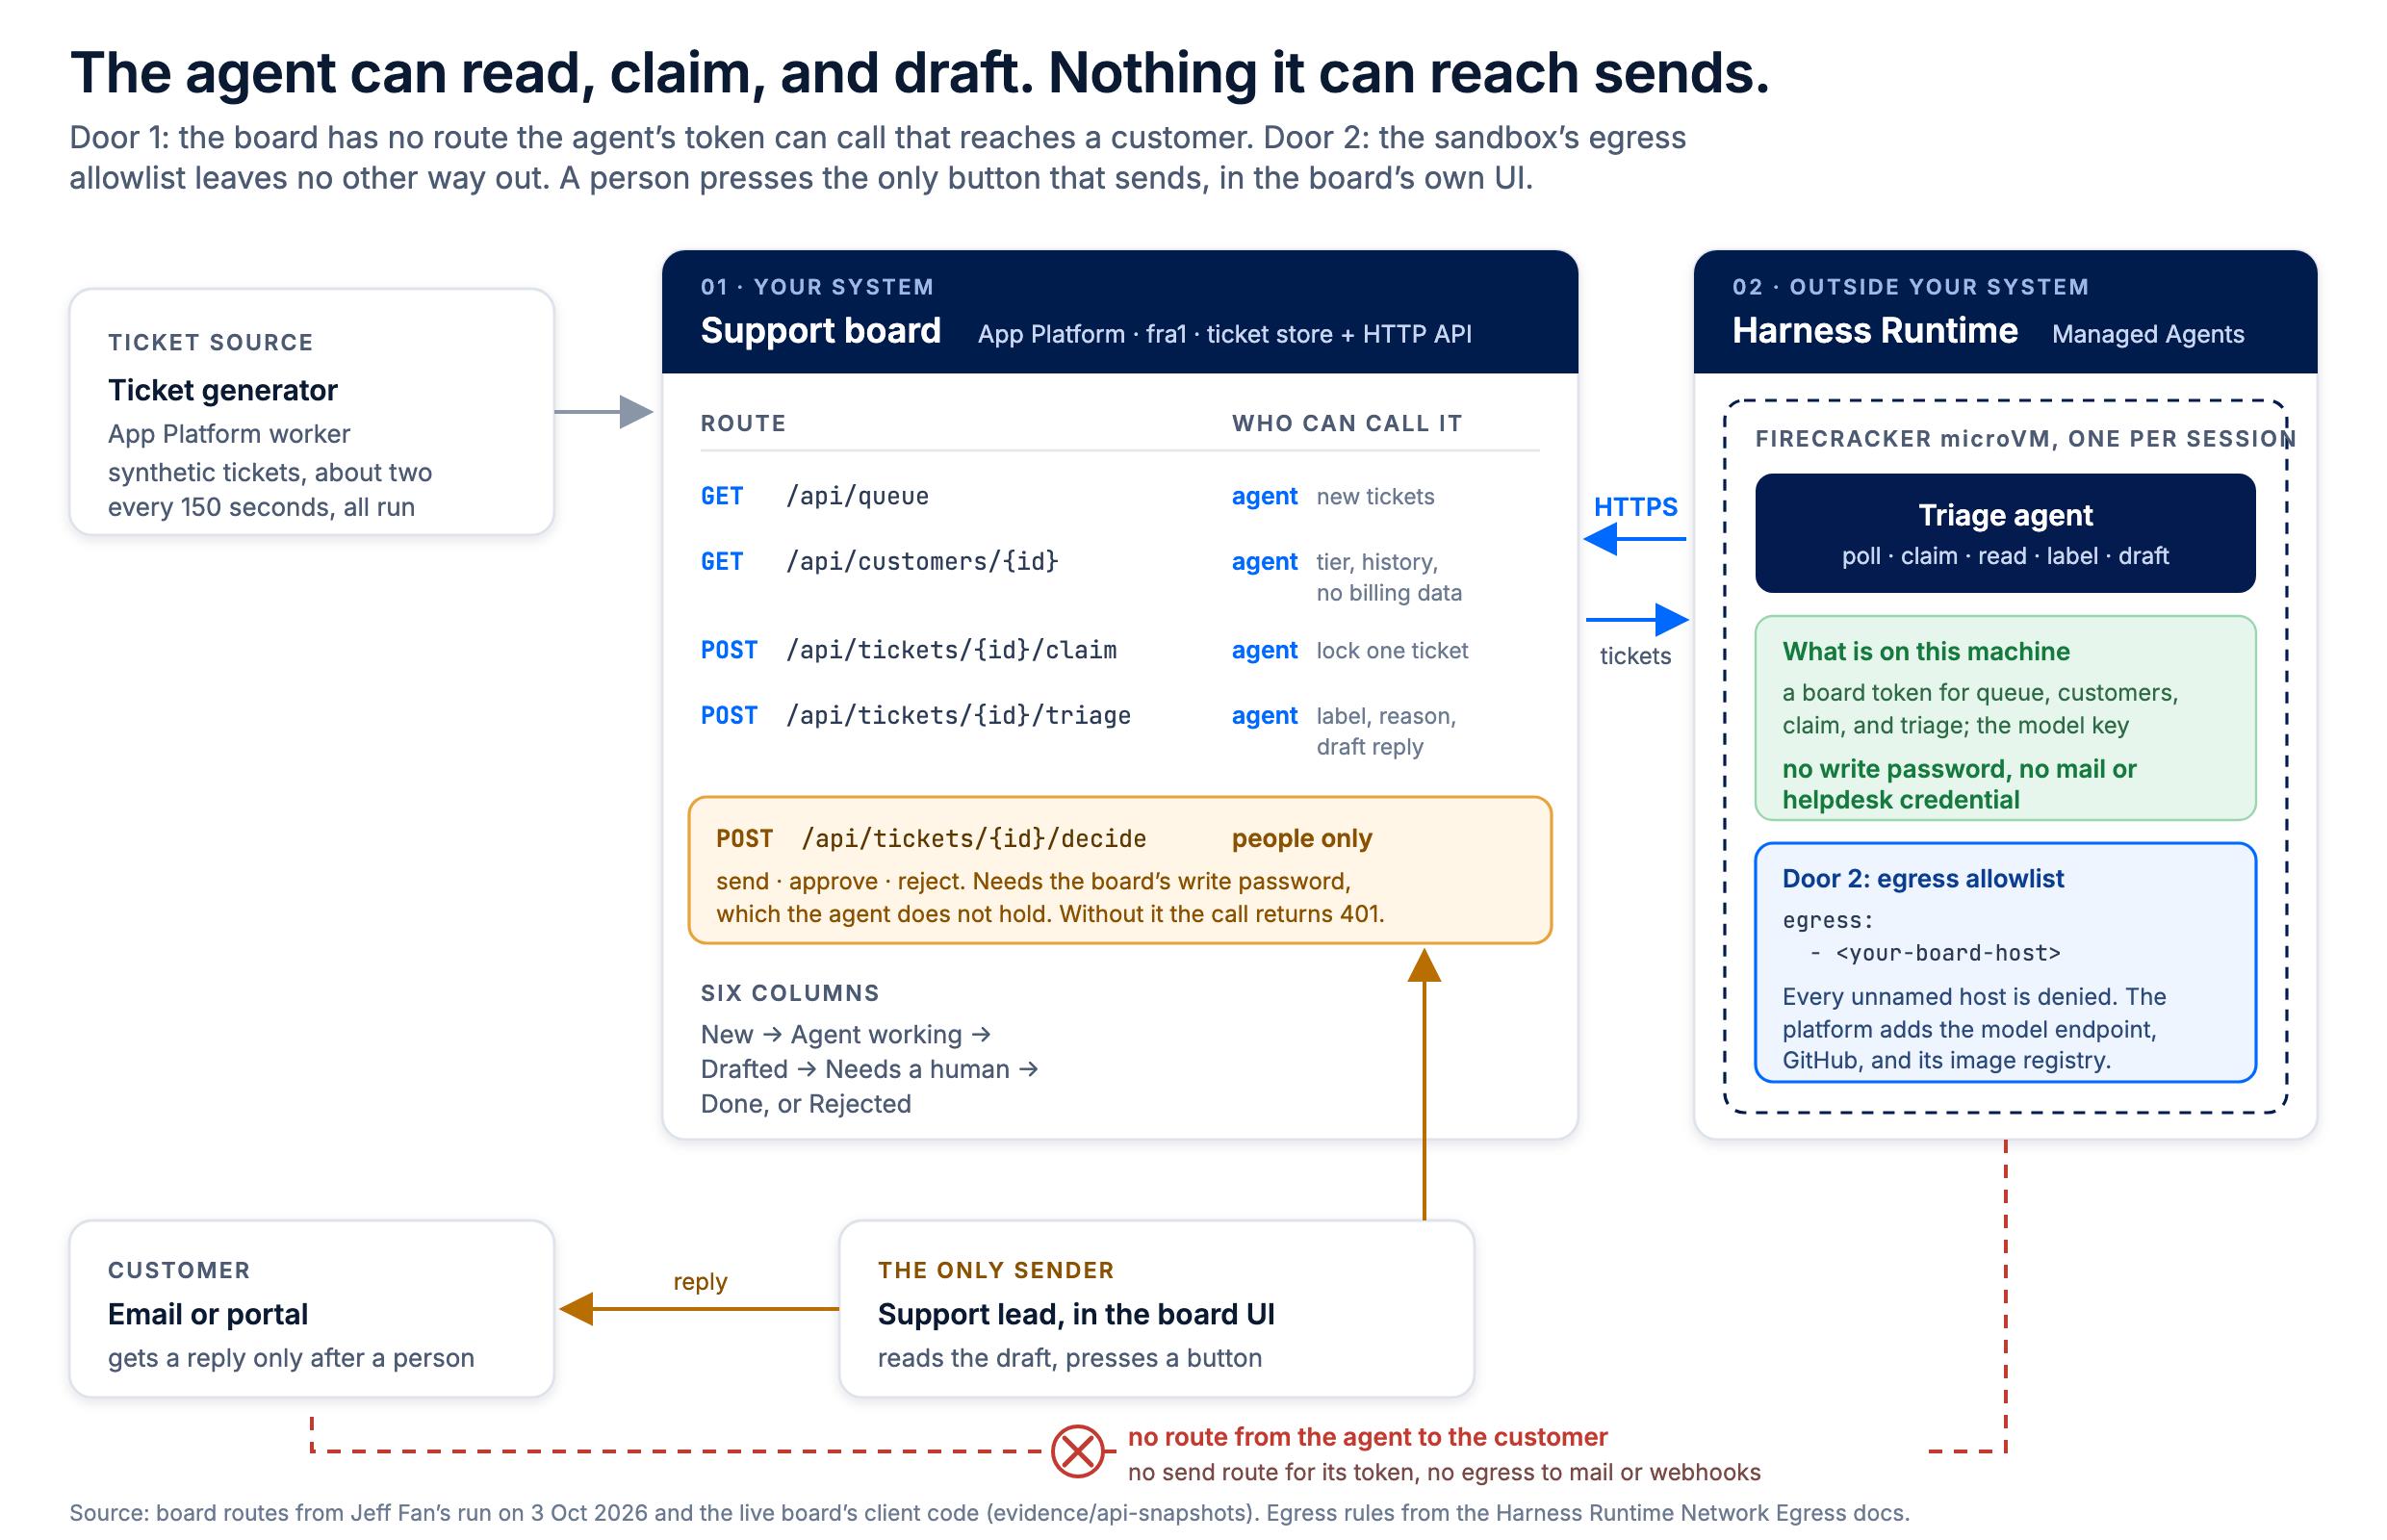
如何阅读此图:
- 该图分为三个部分:
- 支持看板(中心):这是您的系统。
- 智能体沙盒(右侧):位于您的系统之外。
- 人员(底部):根据需要进行干预的人工支持负责人。
- 在看板卡片内部:
- 每一行代表一个 API 路由(即看板的一扇“门”)。
- 最右列显示谁可以访问每个 API 路由。
- 蓝色行:这些是智能体可访问的四个 API 路由:
- 列出新票据
- 读取客户
- 认领票据
- 发布草稿
- 琥珀色行:这是唯一能够实际向客户发送回复的路由。只有具备写密码的人才能使用此路由。
- 右侧的绿色框:列出智能体沙盒中存在的所有凭据。值得注意的是,写密码 not 被包含。
- 下方的蓝色框:代表 Door 2——网络规则。这限制了沙盒的出站连接,使其只能与支持看板通信,阻止访问客户可能到达的任何其他目的地。
- 琥珀色箭头:说明只有当支持负责人(人类)在看板界面内按下按钮时,回复才能到达客户。
- 被划掉的红色线条:显示被禁止的路径——智能体本身永远无法直接到达客户。
环境规范
Harness Runtime 会根据一个环境规范启动会话,该规范是一个 YAML 文件,用于说明要运行哪个智能体、沙箱大小、可访问的密钥和主机,以及需要执行的操作。这是上述设计的示例规范;将占位符替换为您的主机 host 和来自无服务器推理模型和定价页面的模型 slug。
agent: claude-code
description: Overnight support triage. Reads the board, drafts replies, cannot send.
size: mars-2vcpu-4gb
idle_timeout: 15m
env:
  BOARD_URL: https://-board-host>
  HARNESS_INFERENCE_MODEL: -slug>
secrets:
  # Read password: queue, customers, claim, triage. Never the write password.
  BOARD_AGENT_TOKEN: ${BOARD_AGENT_TOKEN}
  HARNESS_INFERENCE_API_KEY: ${HARNESS_INFERENCE_API_KEY}
egress:
  - -board-host>
permissions:
  default: allow
skills:
  - name: overnight-triage
    description: "Use when working the support board queue."
    instructions: |
      Poll GET $BOARD_URL/api/queue. For each new ticket: claim it, read the customer,
      then POST a triage with category, severity, sentiment, needs_human, a one-line
      reason, and a draft reply.
      Escalation rule: anything involving money, account access or closure, possible
      data loss, suspension, or a customer who sounds like they may leave goes to a
      person (needs_human = true).
      Use only facts from this ticket and this customer's record.
几行代码承载了设计:
secrets保存了看板的只读密码和模型密钥,除此之外什么也没有。机器上没有写密码、邮件密钥,也没有帮助台管理员令牌,因而提示注入无法找到任何可利用的东西。egress指定了一台主机。这一行把沙盒从“可访问任何东西”切换为“可访问看板以及平台合并进来的主机”。permissions允许一切操作,因为没有任何权限规则在执行安全工作。安全取决于凭证和网络能够到达的范围。其他命令很容易绕过在curl *decide*上的拒绝规则;而缺失的密码则不然。- 升级规则写入了技能中,而不是留给智能体去发明。让智能体自行决定边界只是对模型的演示,而非对工作的演示。
使用 doctl 1.170.0 或更高版本启动会话。--resume-on-topoff 标志会让余额为 $0 导致暂停的会话在资金到达后自动恢复;否则,它将保持暂停状态,直到您手动恢复。
doctl harness-runtime start --spec specs/support-triage.yaml --resume-on-topoff
每晚按计划运行它
我们最初手动启动了测量运行。对于真正的夜间班次,cron 触发器会在固定时间启动会话,并把智能体最终消息发送到 Slack 或邮件,这是早晨摘要的自然去处:
doctl harness-runtime triggers create \
  --kind cron \
  --name support-overnight \
  --session-mode fresh \
  --spec specs/support-triage.yaml \
  --prompt "Work the support board queue until 07:30, then summarise what needs a person first." \
  --cron-expr "0 22 * * *" \
  --timezone Europe/Berlin \
  --output-mode slack \
  --output-slack-webhook <your-slack-incoming-webhook-url>
本文设计得到以下两点来自触发器文档的支持。触发器会拒绝任何使用 ask 权限的规格,文档警告:“ask 不是触发运行的安全控制……代理绝对不应执行的任何操作都需要 deny 规则。”当没有人清醒来回答时,审批提示不是可依赖的东西;移除该能力才是。此外, fresh 模式每晚从规格开始,使用干净的会话,因而当晚的工单不会流入第二天。
1小时48分钟内发生了什么:99 张工单,35 个敏感,0 条已发送
一次持续 1小时48分钟的运行:认领 99 张工单,triaged 99 张,新工单以每次两张的速度持续到达。看板是一个普通的六列看板: New、 Agent working、 Drafted(待发送)、 Needs a human、 Done、 Rejected。它是持续喂入的,而不是一次性过夜投入,因为工单的到达就是这样。
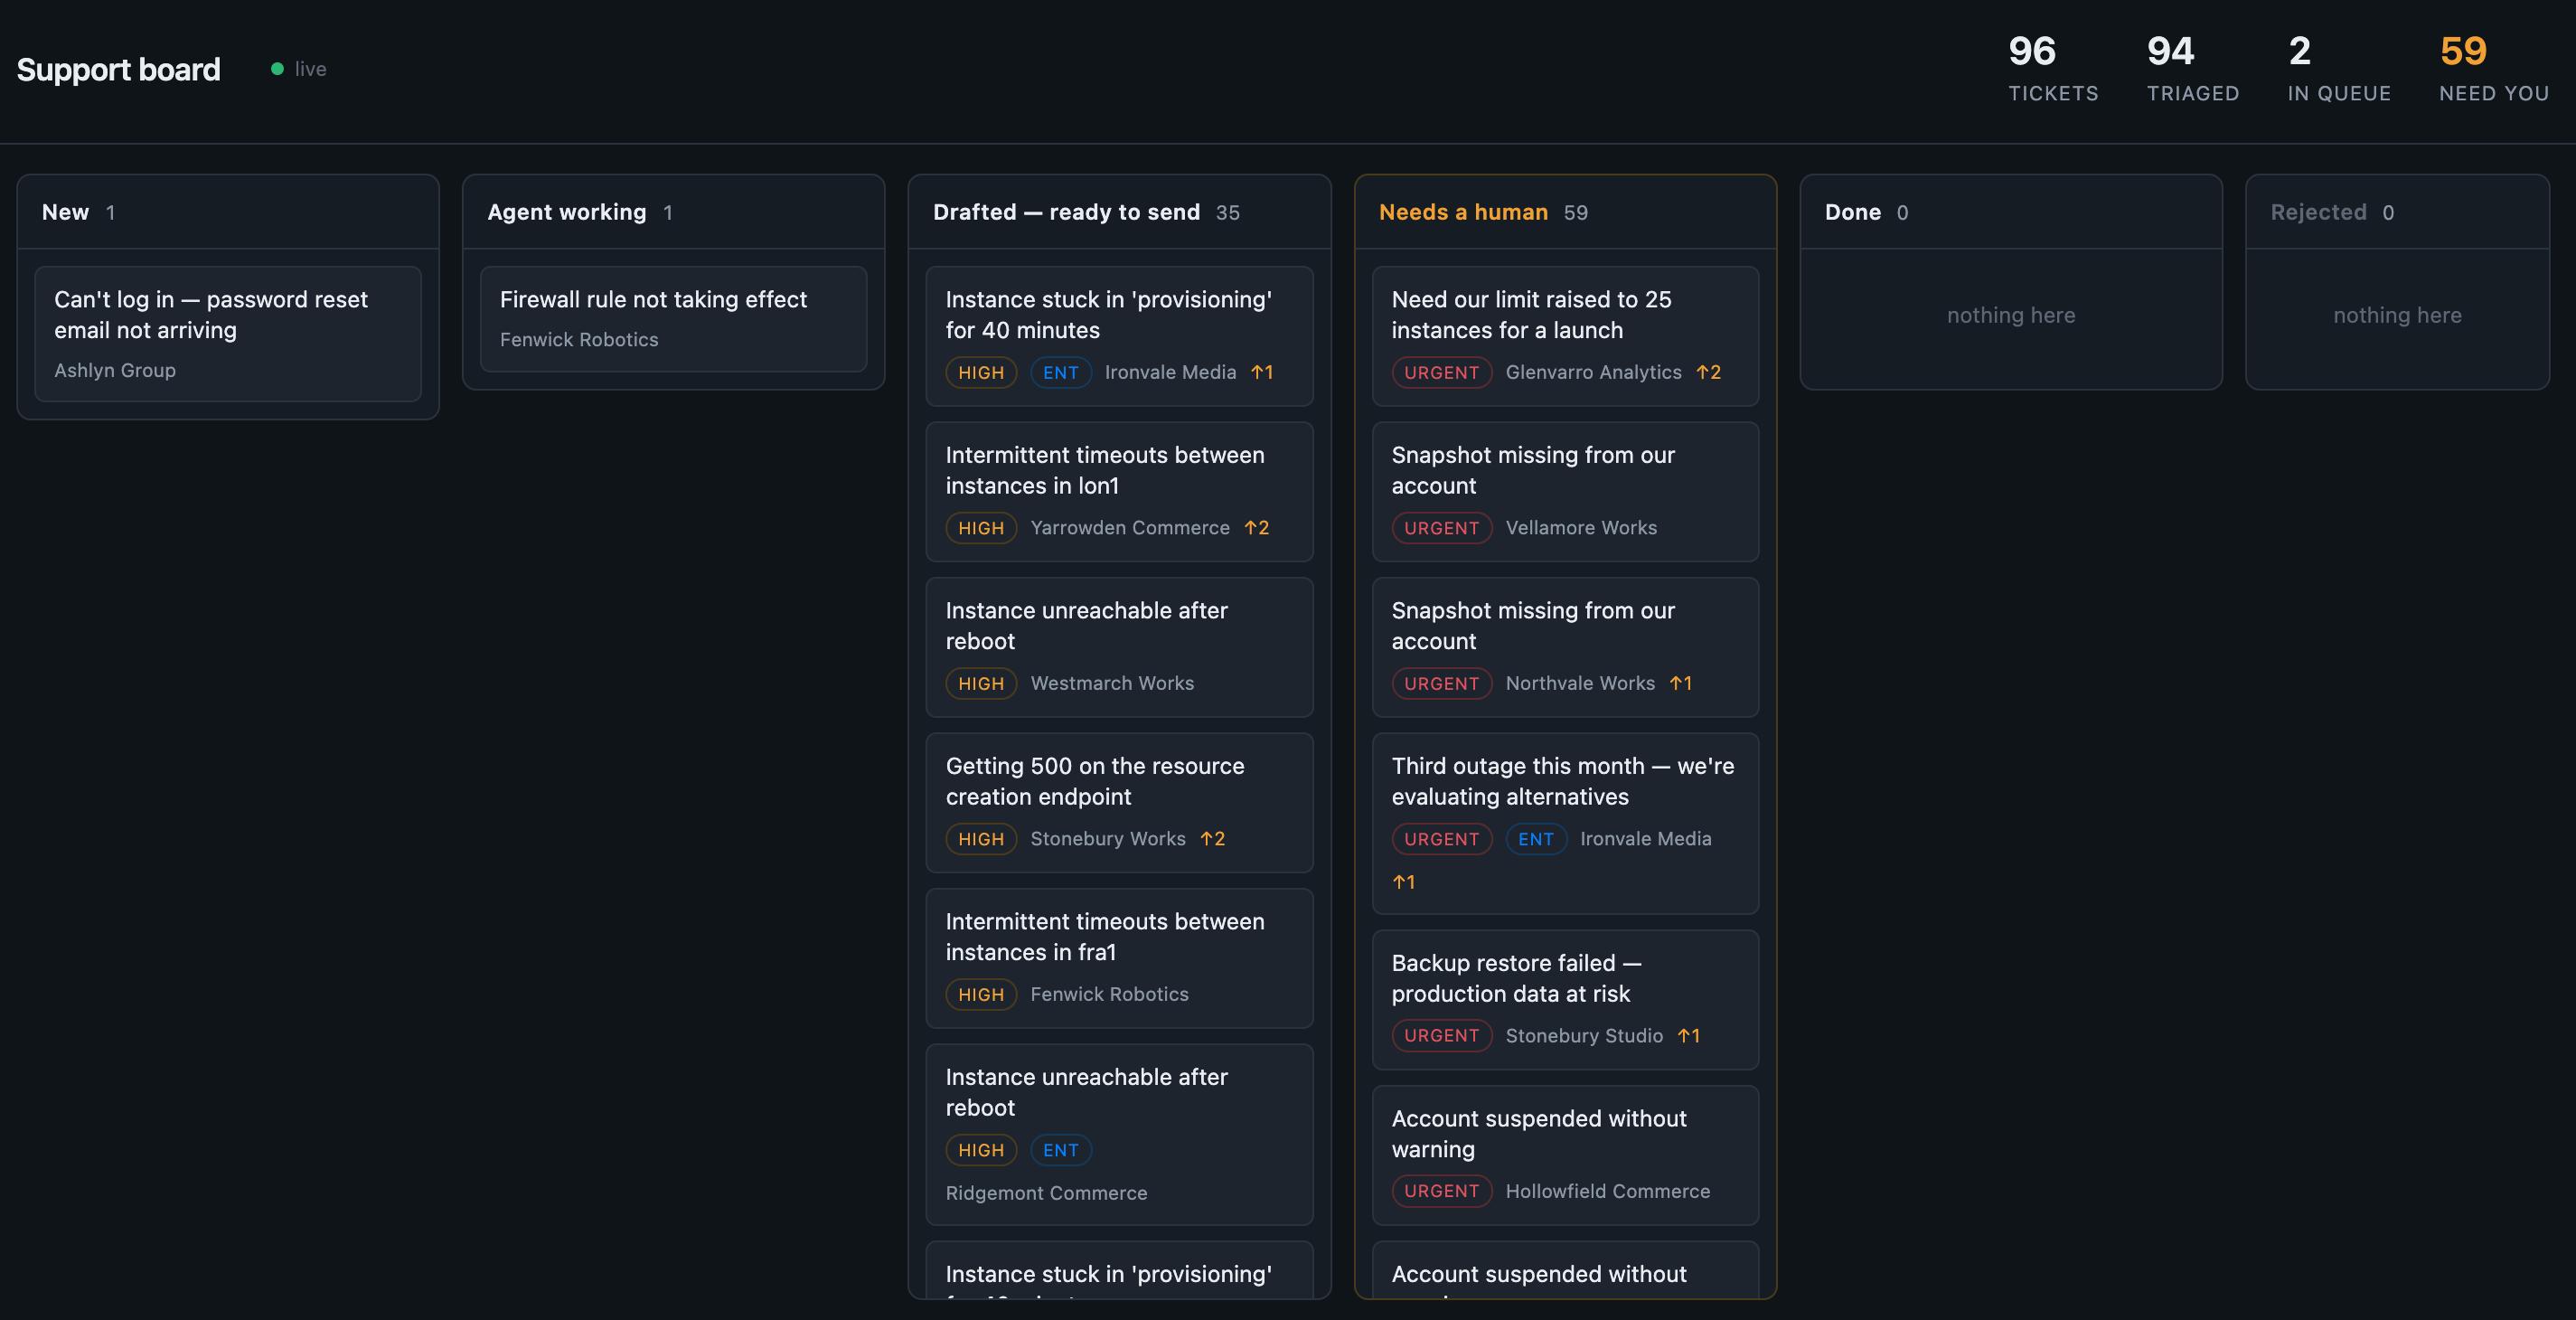
如何阅读此看板。这是支持负责人在运行期间会看到的看板。右上角的四个数字分别统计了已到达的工单、代理已完成的工单、仍在等待代理处理的工单以及等待人工处理的工单(“need you,”琥珀色)。每列代表工单可能的状态,从左到右。有一张工单是新的,有一张正在被处理,因此代理能够跟上到达的工单。Drafted 列存放代理认为属于例行的回复;它们仍然需要一个人点击发送。Needs a human 列存放被升级规则捕获的工单,每张工单都附有原因。Done 和 Rejected 列目前为空,因为尚未有人做出决策——这一点正是想说明的:没有工单离开看板。这些数字低于最终统计(99 triaged, 62 需要人工处理, 37 已草拟),因为此帧是在运行结束前捕获的。
The escalation rule the agent was given, word for word:
涉及金钱、账户访问或关闭、可能的数据丢失、暂停,或听起来可能要离开的客户,都由人来处理。
将其应用于 99 张工单后,得到一目了然的形状。技术故障大多直接通过。涉及金钱、访问、数据或即将离开的客户的工单会被拦下。
| Agent 称之为 | 工单数 | 由人拦下 |
|---|---|---|
| technical_fault | 24 | 5 |
| billing_inquiry | 13 | 13 |
| product_guidance | 13 | 0 |
| service_limit_change | 7 | 7 |
| account_access | 6 | 6 |
| billing_change | 6 | 6 |
| dns_configuration | 5 | 0 |
| refund_request | 4 | 4 |
| retention_risk | 4 | 4 |
| account_closure | 4 | 4 |
| backup_and_recovery | 3 | 3 |
| potential_data_loss | 3 | 3 |
| billing_dispute | 3 | 3 |
| account_suspension | 2 | 2 |
| follow_up_complaint | 2 | 2 |
| Total | 99 | 62 |
在 99 张工单中,有 35 张按照我们的规则被标记为敏感, 64 张为常规。所有 35 张敏感工单都被拦下并等待处理,没有一张被自动草拟发送。 这就是我们需要关注的数字:敏感工单若被自动回答即构成事故,而常规工单若转给人处理,只需花费他们早晨几秒钟。我们不会把其余情况粉饰为准确率。这些标签是我们为自己生成的数据所写,并根据我们自己制定的规则进行评分。
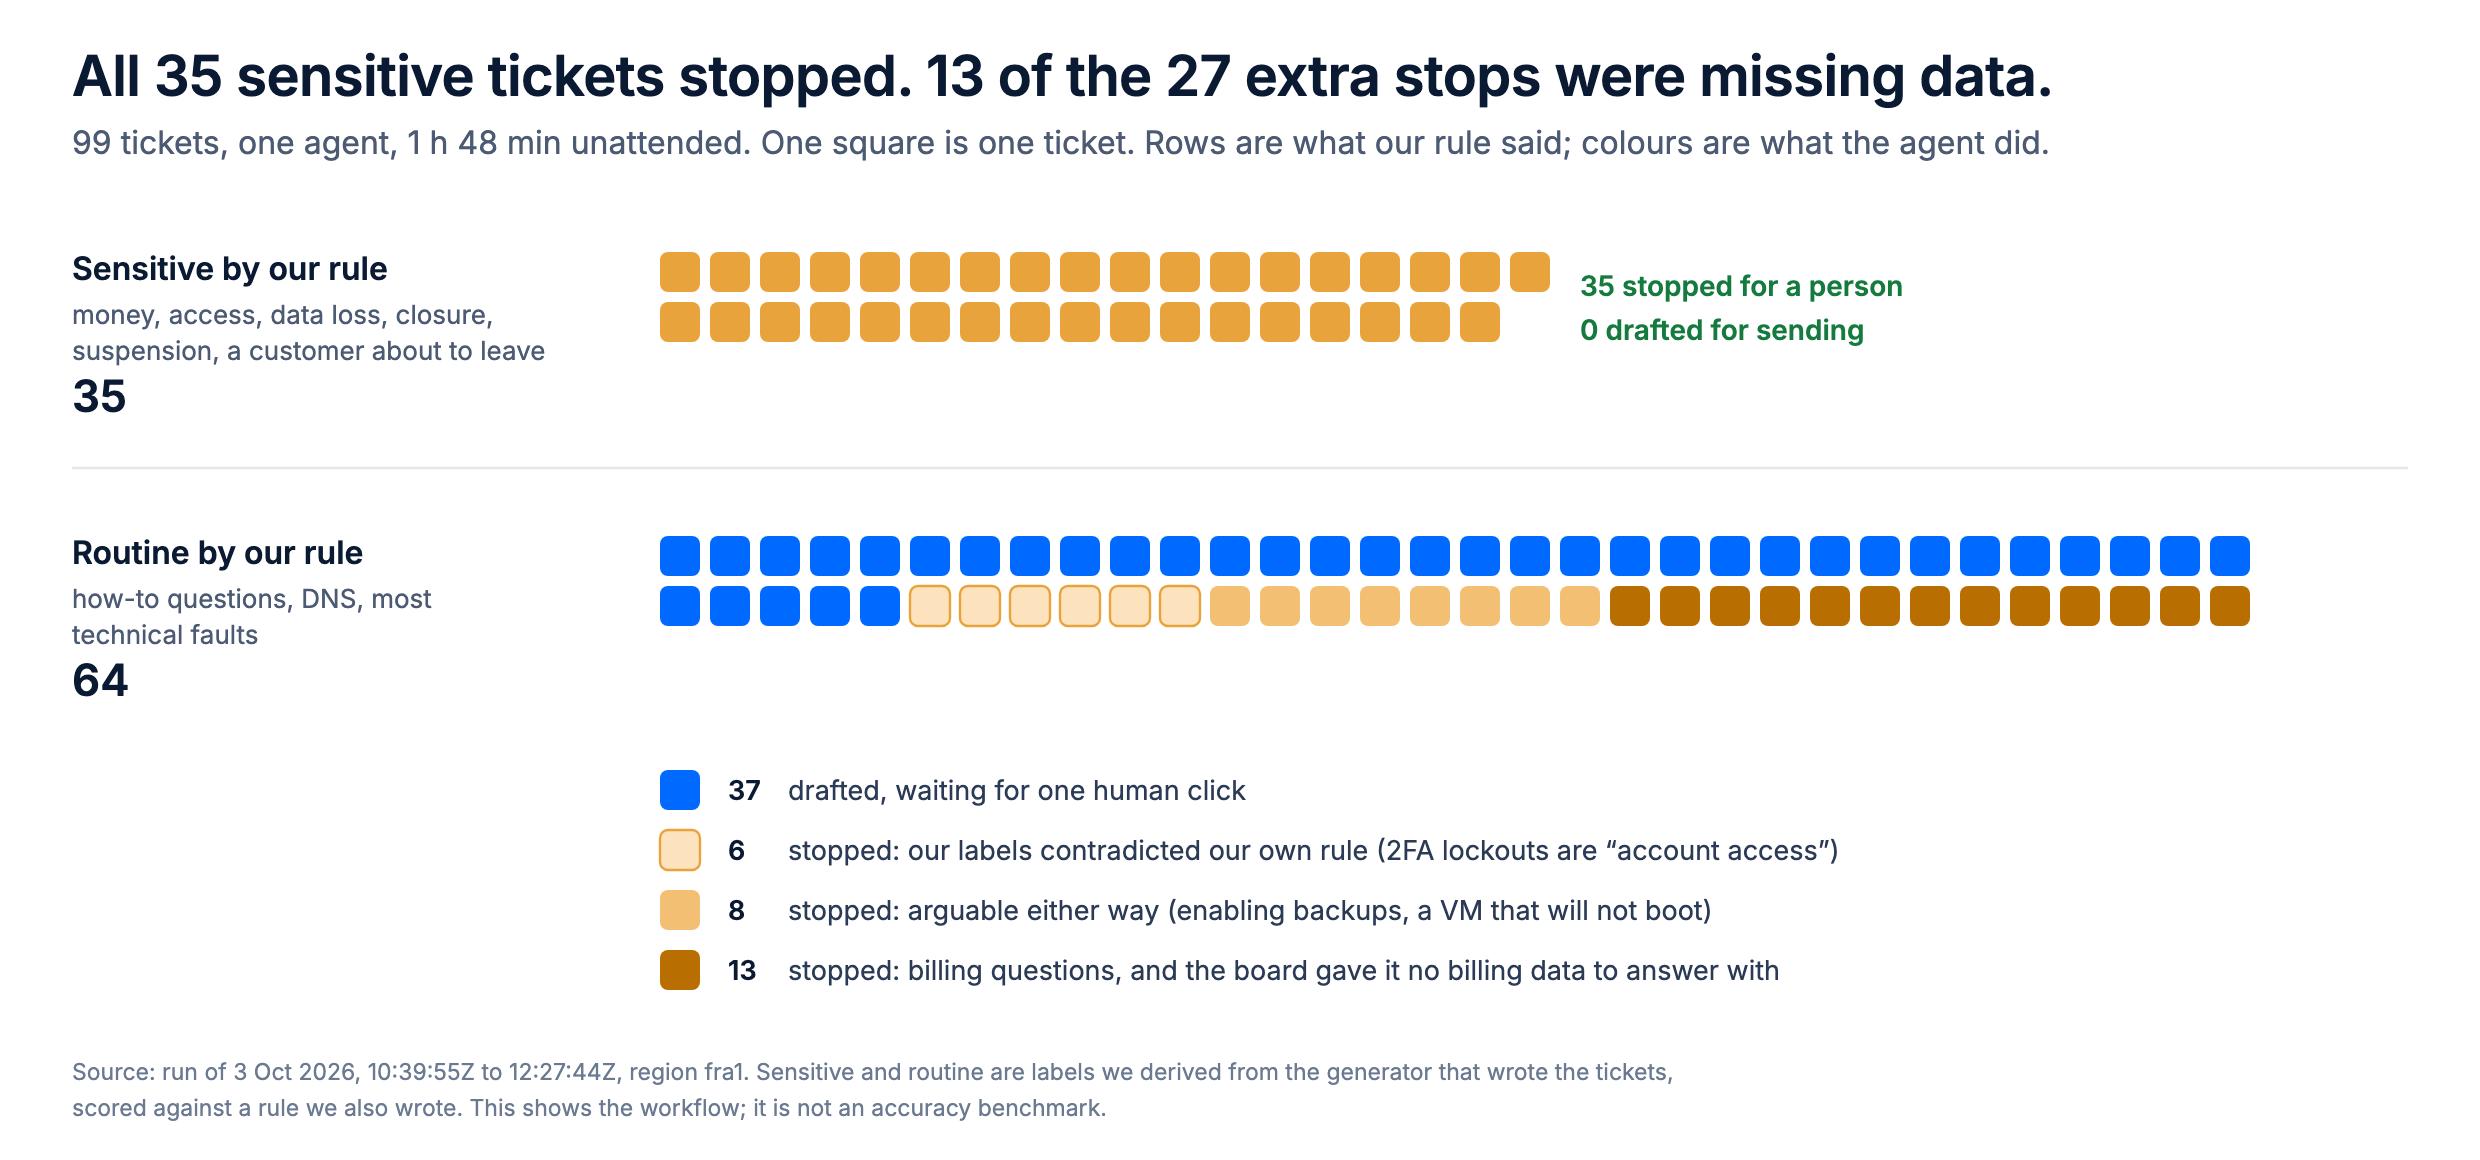
如何阅读。 每个方格代表一次运行中的一张票,共 99 张。两行依据我们自己的规则将它们划分:上方 35 条敏感票,下方 64 条常规票。颜色表示 Agent 对每张票的处理。琥珀色表示 Agent 为人工停止了该票;蓝色表示 Agent 草拟了一条回复并留待一点击。上行全为琥珀色:所有敏感票均被 Agent 停止。下行显示 Agent 的谨慎程度超过了规则要求。37 张常规票被 Agent 草拟(蓝色),而 27 张票仍然被停止,分为三类:6 张票我们自己的标签与规则不一致;8 张票可以两种方式处理;13 张是计费问题,Agent 因缺乏数据而无法回答。该图表不是准确率基准测试。它展示了工作流如何根据我们编写的标签对一次合成票据运行进行分类。
Agent 仍然停止了 27 张常规票
值得阅读的清单是 Agent 停止的 27 张常规票。阅读它改变了我们的规则,而不是我们对 Agent 的看法。
- 6 起账户锁定,例如 “2FA 应用被擦除,我该如何重新登录?” 我们的规则是这样表述的:“账户访问或关闭”。我们的标签将它们称为常规密码重置。Agent 按照给定的规则执行。我们自己的标准自相矛盾,只有通过阅读这些分歧才发现。
- 8 起存在正反両方的争议,例如启用备份或机器无法启动。我们不会认为它们有错。
- 13 起计费问题,并且它们根本不是规则问题。每一起都被升级。Agent 给出的理由从未是“这涉及金钱”。而是“我没有使用数据来验证它”。这是正确的:看板向 Agent 提供客户的层级、历史和之前的升级情况,但没有计费信息。
看板在后续运行中仍然表现出相同的行为。下面的票据在测量运行后到达实时看板,且不属于那 99 张票中的任何一张。
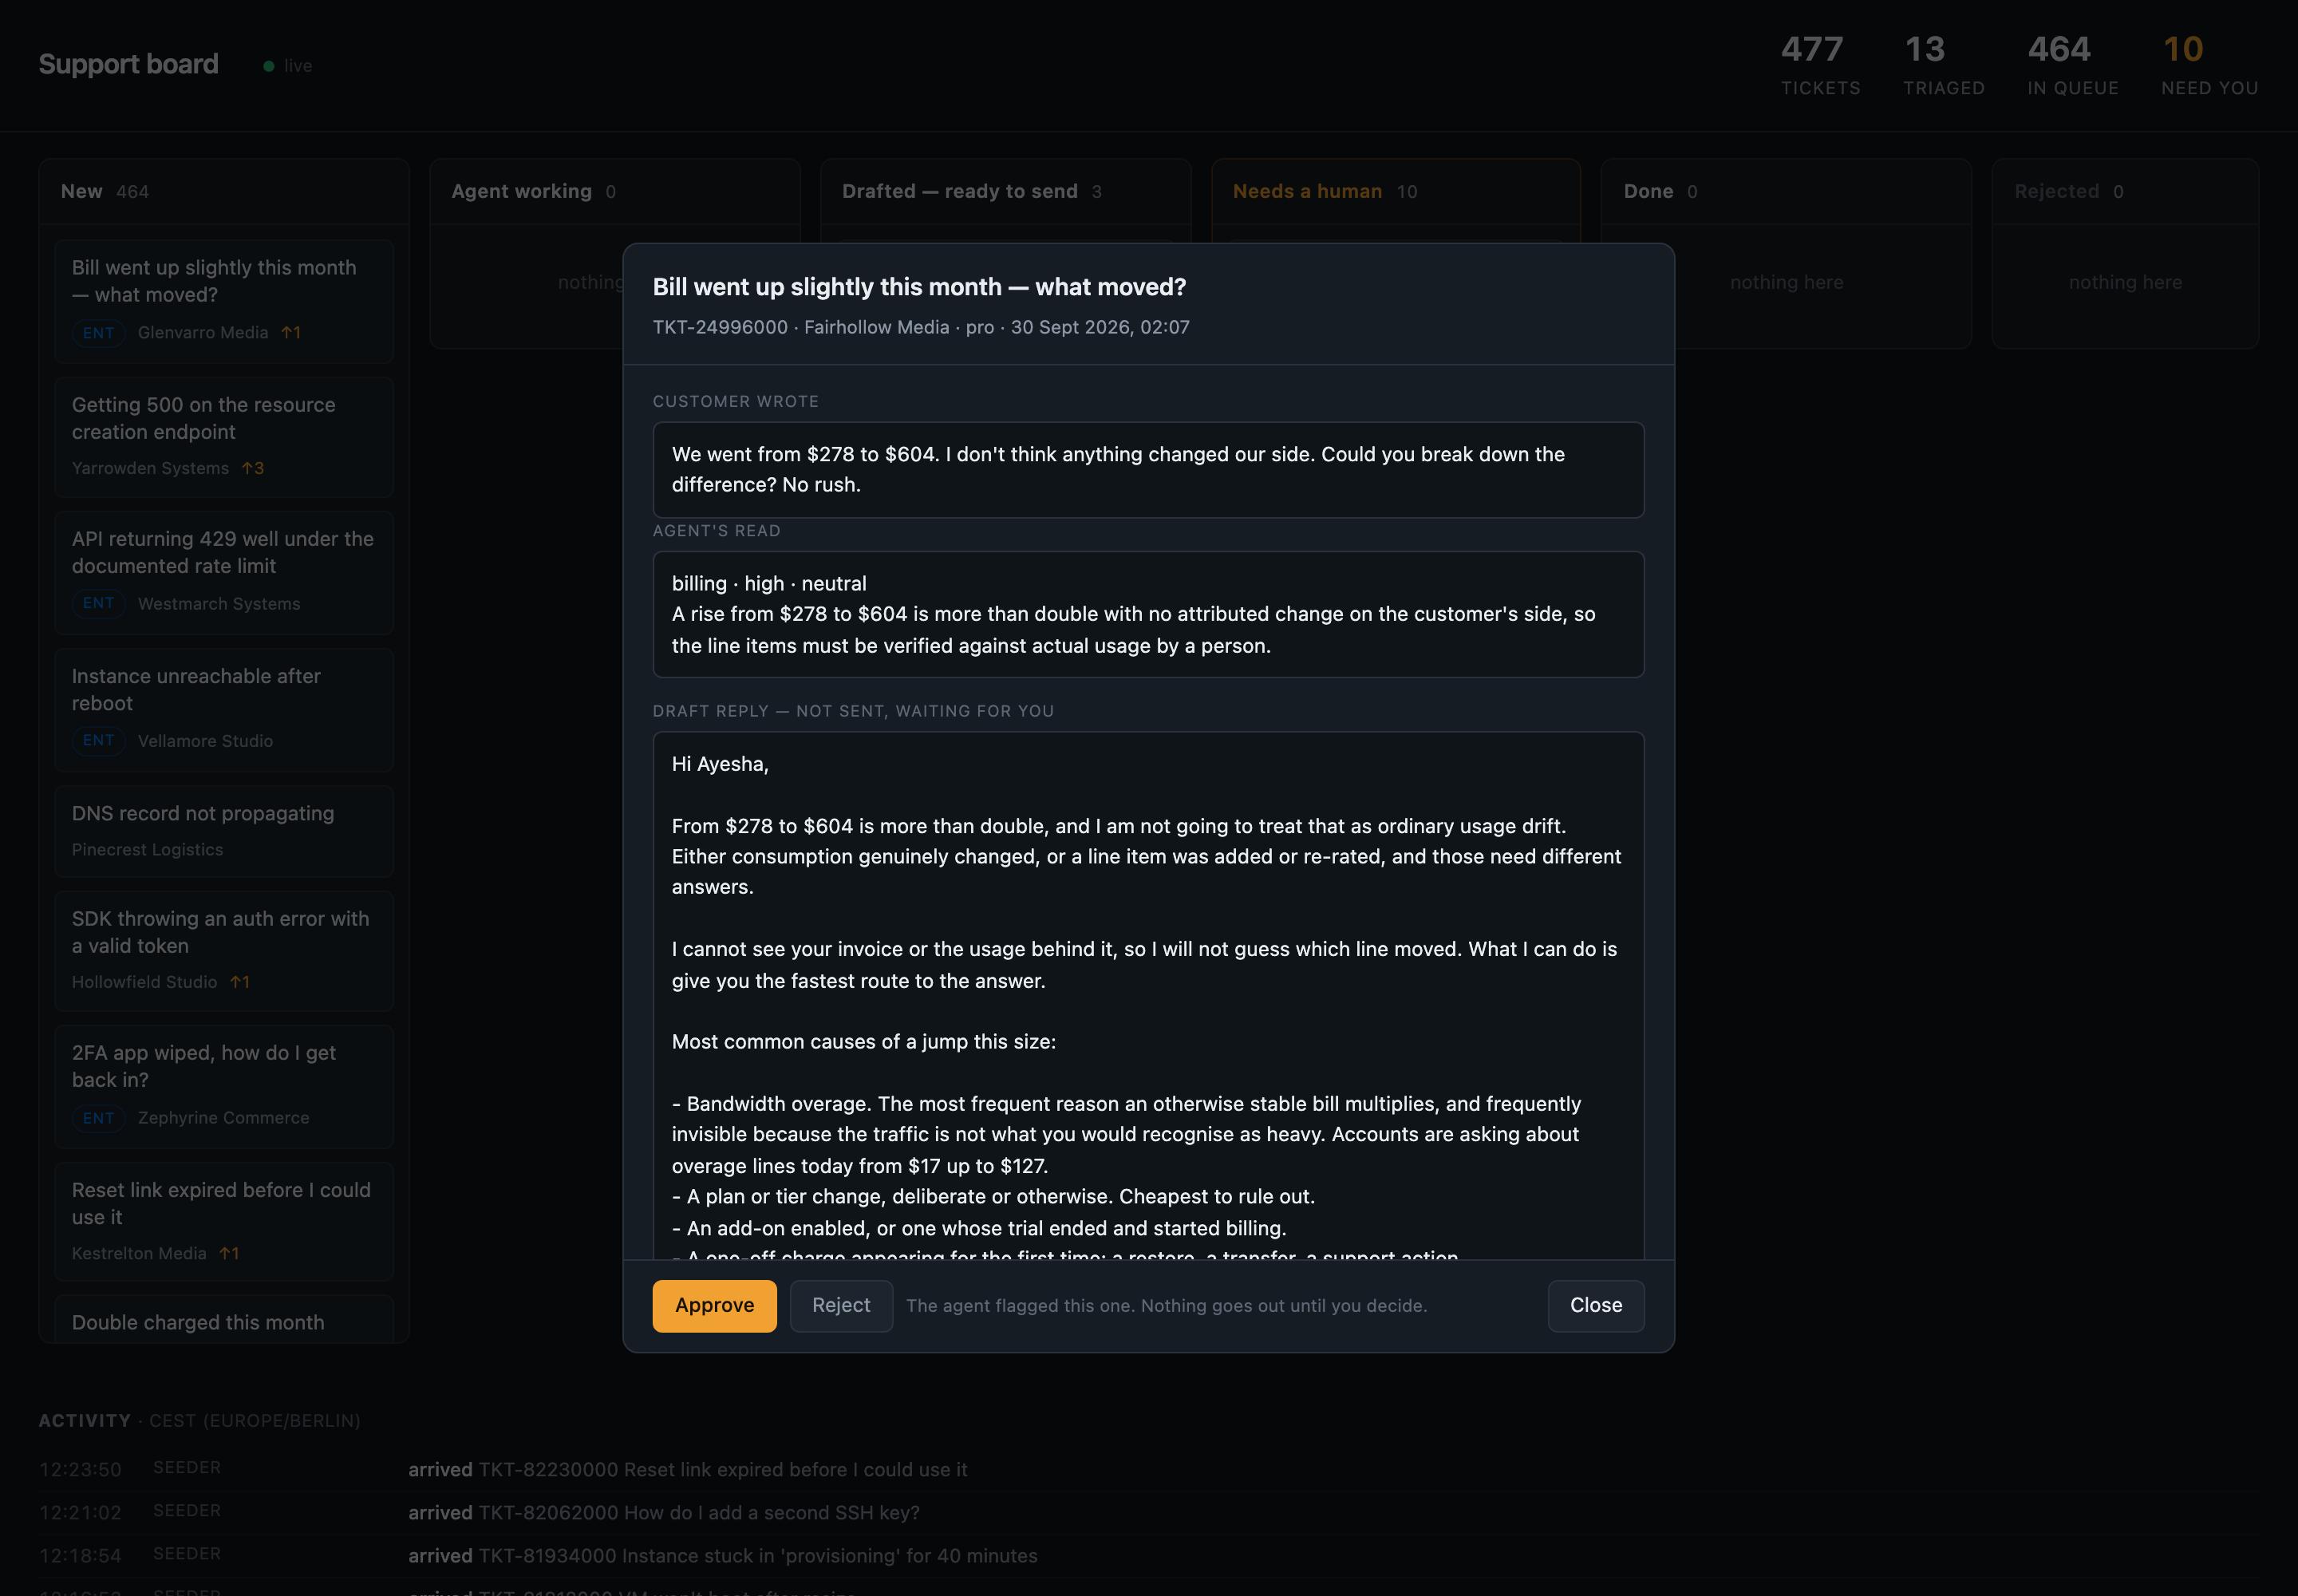
如何阅读。 这是支持负责人在点击“需要人工”列中的工单后看到的内容。面板由上至下分为三个模块。“Customer wrote”即工单本身:账单从278美元涨到604美元。“Agent’s read”是代理的标签及其停止工单的一行原因:需要将明细项与实际人工使用情况核对。“Draft reply”是代理撰写的回复,明确表示它看不到发票。这就是代理自己的话中所缺失的集成。面板后面的看板变暗了。底部的按钮是供人工使用的;代理无法点击它们。
在27次不必要的停止中,有13次是由于集成缺失,而非判断失误。关于代理,首先要问的问题是:“它需要什么条件才能回答这个问题?”准确性是在之后才考虑的。第一次遇到这种情况时也要有此预期。在您看到一周真实升级之前编写的规则只是初稿;被过度标记的列表则是您发现哪条条款错误的地方。
在信任决策之前先阅读草稿
这是开头所示的6,868美元退款工单,代理在运行中的处理方式如下。这是一个若给出错误且自信的回答,就会造成实际损害的工单:
我需要直白地说明接下来会发生什么。如此大额的退款我无法在此批准或确认,因此我已将其转交给能够审查并做出决定的同事。我不告诉您一定会退款,也不给出日期,因为我自己也不清楚这两点,若我说出来您可能会围着我编造的事情做计划。
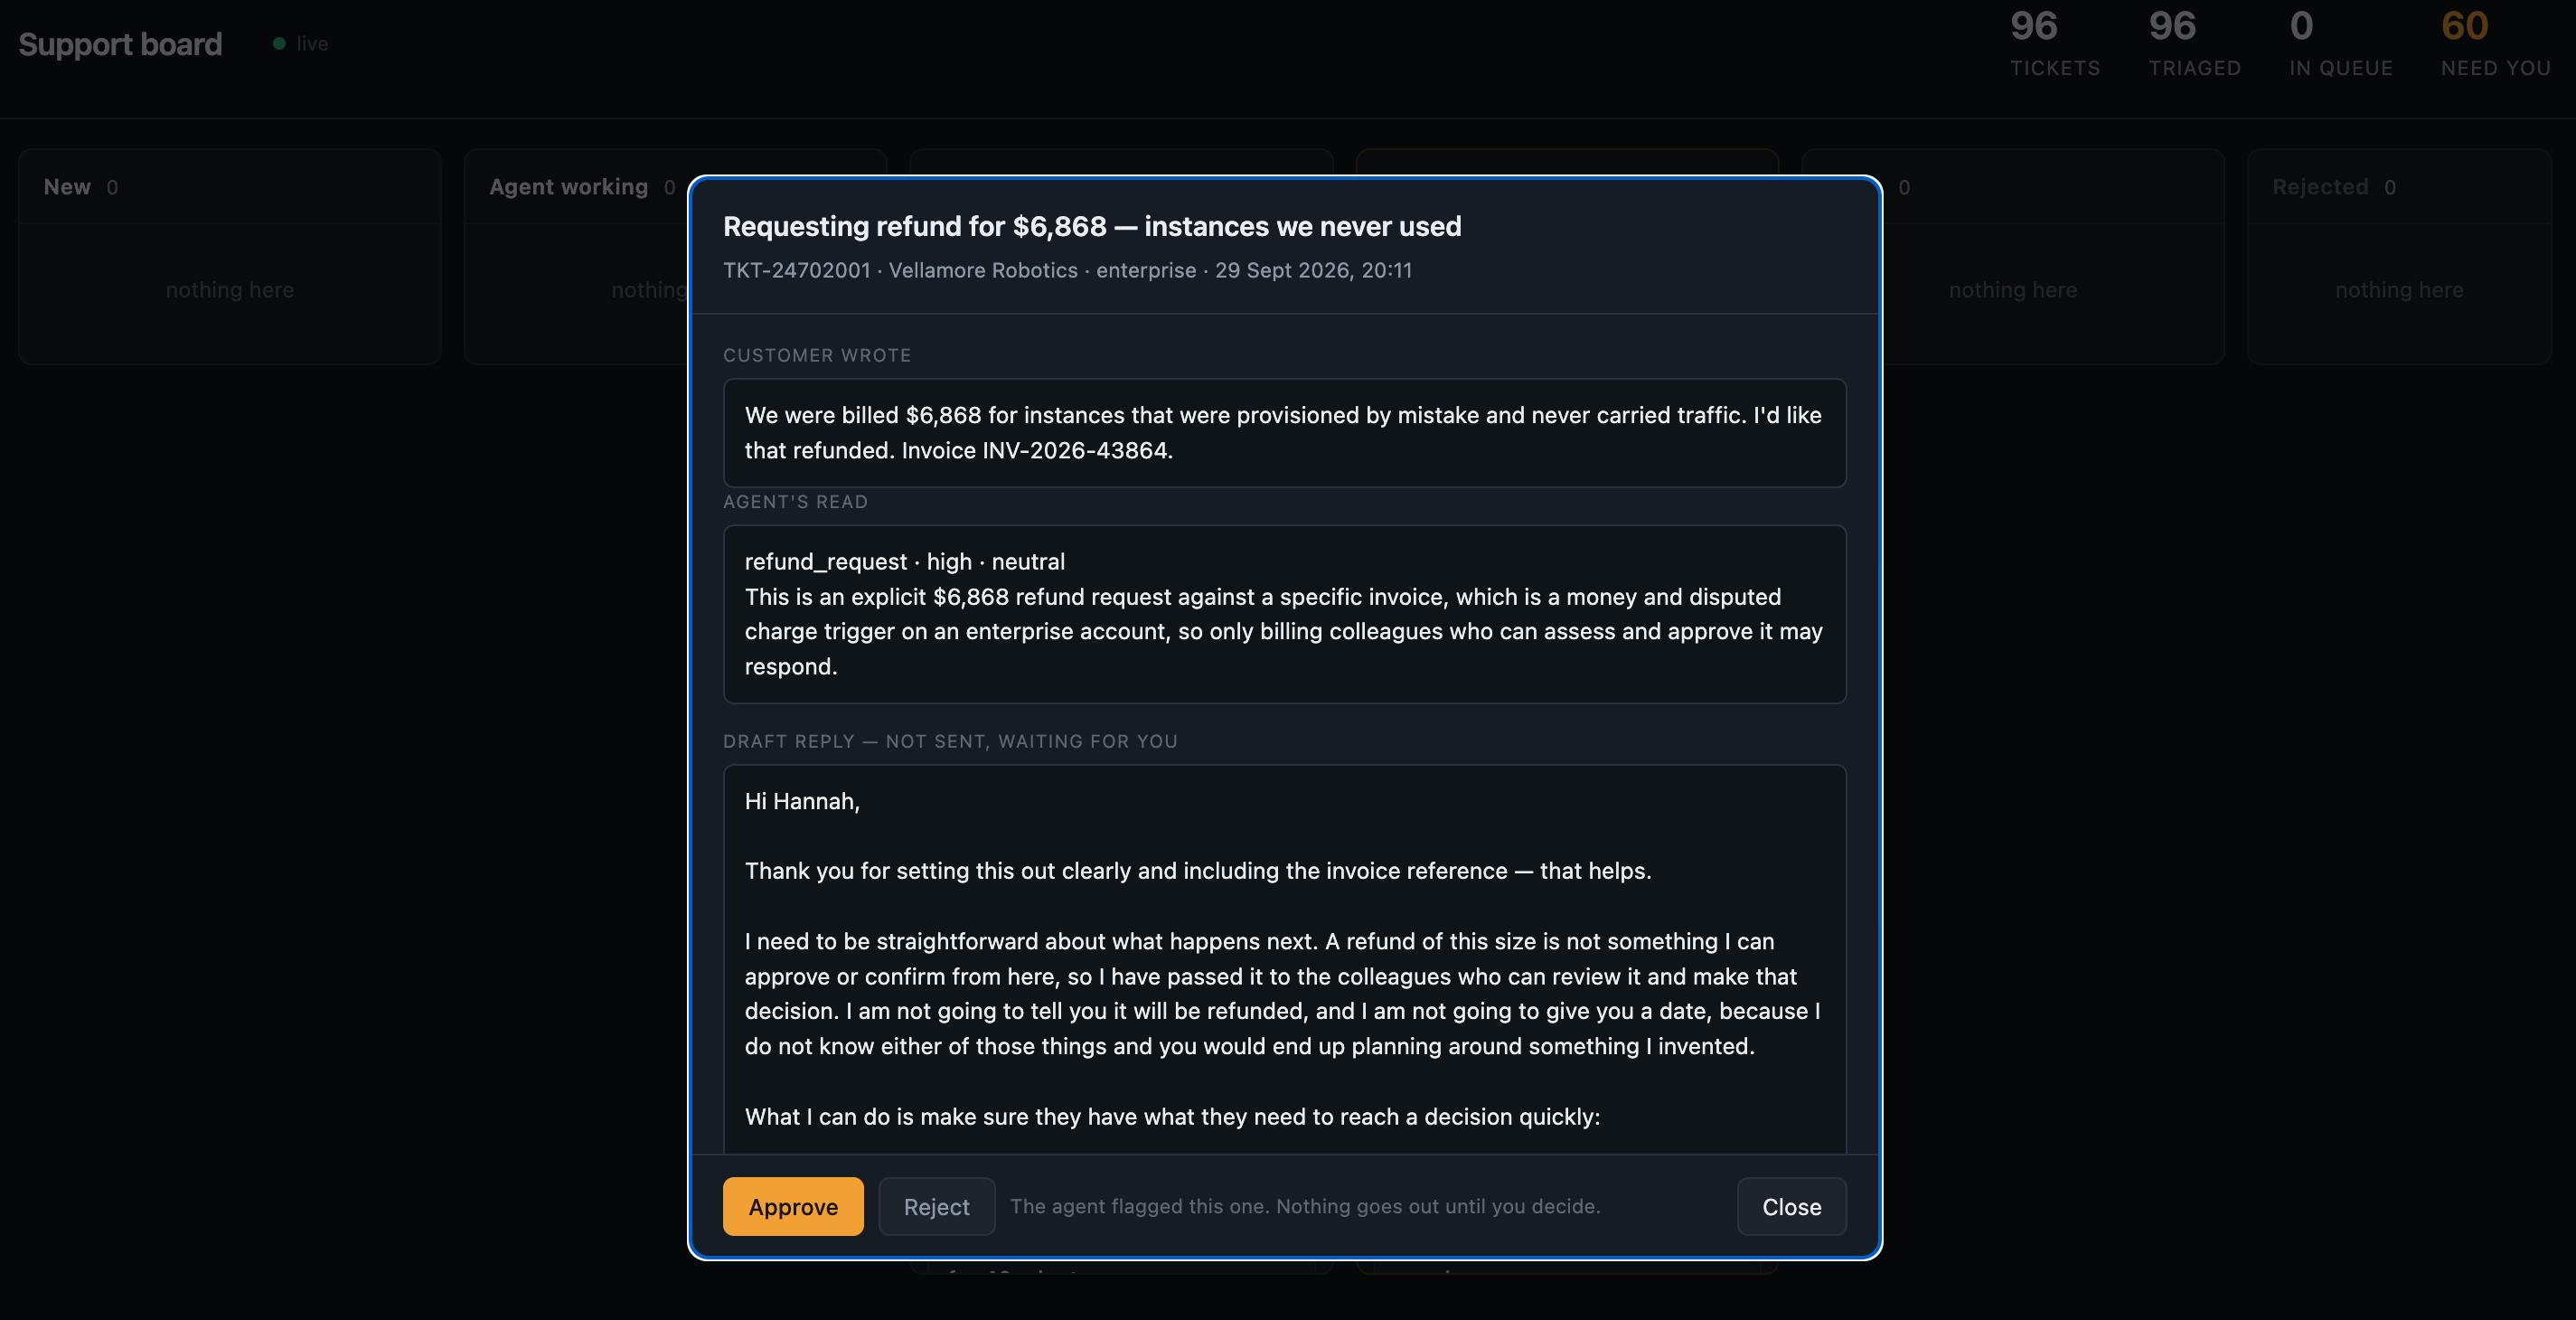
如何阅读此内容。 面板布局与账单工单相同。客户要求在一张具名发票上退回 6,868 美元。代理读取将其标记为退款请求,并说明停止原因:金额、有争议费用、企业账户。草稿被标记为“未发送,等待您处理”。注意草稿中不包含的内容:没有承诺退款、没有日期、没有信用额度。琥珀色的“批准”按钮属于审阅人;此页面任何内容均不可通过代理令牌访问。
决策正确。 草稿不作出无法保证的承诺。在运行的五个最敏感类别中,没有任何草稿承诺退款、信用、恢复、时间表或 SLA。
该撰写尚未准备好发送。 96 份草稿中有 32 份(约三分之一)使用了确切的措辞“I am not going to tell you…”,长度约为 1,700 个字符。若将范围扩大到任何第一人称拒绝(“I cannot confirm,” “I will not promise”)则超过一半:96 份中的 51 份。真正的客服回复会说“我已将此问题转交给我们的账单团队,他们会直接与您联系。” 拒绝意思相同,但解释更少。
同一看板后续运行中出现的错误
我们在 10 月 6 日阅读了实时看板上的所有草稿:共 13 份,由代理后期配置在 10 月 5 日 18:29 至 18:57 UTC 进行分类(其类别名称与前述运行不同,因此视为独立运行)。出现了两个缺陷,支持负责人能够在几秒内发现,而匆忙的审批者可能会漏掉。
| 缺陷 | 草稿数 | 示例 |
|---|---|---|
| 以客户自身公司的名义签署 | 13 of 13 | A reply to Fairhollow Media ends “Thanks, Fairhollow Media support” |
| 提及其他账户的报告情况 | 4 of 13 | “Several accounts are seeing unexpected overage lines this month” |
| 引用在本工单或客户记录中均未出现的美元金额 | 2 of 13 | “refund claims today span $1,200 to $8,889 for resources provisioned by mistake” |
| 使用“I am not going to…” | 5 of 13 | “I am not going to treat that as ordinary usage drift” |
跨工单的线索是严重的问题。代理一次读取队列中的多张工单,并保持一个长对话,因此在撰写时其他客户工单会停留在上下文中。没有任何内容被发送,因为无法发送。但在提及其他账户的四份草稿中,有一份位于“已起草”列——即常规回复的栏目,距离客户只需点击一下。
三种低成本的修复方案,我们尚未进行测量:
- 发送按钮可用前的确定性检查 草稿中的每个金额、发票号和公司名称都必须出现在此票据或该客户记录中,签署必须是贵公司名称。只需几行代码,看板即可运行该检查;无需模型。
- 每个对话一个票据 为每个新票据,让看板在
fresh模式下调用 webhook 触发器,这样每个草稿都从仅看到一个客户的干净上下文开始。 - 在技能中修复签署 代理从客户记录中读取
company并将其视为自身。明确告诉它支持团队名称。
也可以让第二个代理在人看到草稿之前对其进行重写。我们会尝试这样做,但有一个前提。生硬的表述也是模型拒绝承诺的最明显标志。“我已将此交给账单部门,他们会很快跟进” 读起来更好,且悄然承诺了原始版本不会给出的时间表。清理步骤改变了人需要检查的内容(“重写是否保留了拒绝?”),而不是是否需要人进行检查。
这些都不会影响回复是否被发送。无论草稿是否被重写,若没有人按下代理无法按下的按钮,它都不会到达客户那里。
支持负责人会问的四个问题
我们与支持负责人坐下来讨论了这篇文章,因此我们认为运行队伍的人会提出这些问题。每个答案都是一个度量或有文档记录的行为。
如果代理在凌晨 3 点挂掉会怎样?
暂停的会话被冻住,而不是被销毁。在另一个实验室里,驻留在内存中的进程在其虚拟机被直接杀死后,从它停止的地方恢复。但你用来把 Agent 拉回的命令决定了什么会被保留:
| 发生了什么 | 恢复什么 | 你需要做什么 |
|---|---|---|
| 15 分钟无活动(空闲挂起) | 一切:进程、内存、工作区、对话 | 什么也不做。后续输入会恢复它 |
| 你暂停了它 | 一切 | doctl harness-runtime resume ,或发送输入给它 |
| 每个余额都为 $0 | 一切,但它仍处于暂停状态 | 添加资金或启用自动重载;使用 --resume-on-topoff 启动会话 |
| 你从检查点分叉了它 | 检查点处的机器,带有一个全新的对话 | 适用于并行实验,不用于恢复 |
| 你将它回滚到检查点 | 检查点处的机器;之后的工作被丢弃,而在我们的实验室中,Agent 不记得对话 | 仅在你想要丢弃工作时使用 |
| 运行以失败状态结束 | 会话拒绝新输入 | 启动一个新会话 |
来源:会话, 限制, 当所有余额为空时会发生什么, 检查点、分叉和回滚, 以及我们的 回滚实验教程,其中回滚的 Agent 说 “这是我们会话的开始”。
实际做法:如果过夜运行停止,则恢复它。不要回滚并期望它记得前 200 个工单。
有两个缺口属于你的应用,而非平台。首先,智能体已认领的工单会停留在“Agent working”状态,直到它发布 triage。如果在此期间会话中断,为认领设置超时,使工单返回 New 状态。其次,Harness Runtime 目前尚未发送 运行生命周期事件的 webhook 通知,因此 “智能体在凌晨 3 点停止” 本身不会触发任何告警。当队列不为空但超过 20 分钟仍无工单被认领时,让看板发出告警。
如果工单中包含提示词注入会怎样?
假设它会发生。支持工单可能来自任何人,包括试图引导智能体的人;模型无法可靠地根据来源判断哪些指令可信。提示词注入是 LLM 应用 OWASP Top 10 的首项,且更强的模型也无法修复它。有价值的问题是:当注入成功时,智能体能够触及什么。
在两扇门都关闭的情况下,被毒化的工单能做什么、不能做什么如下:
- It 无法发送回复,也不能退款或关闭账户,因为智能体的 token 无法调用
decide,且智能体没有其他帮助台凭据。 - It 无法向外部服务器发送数据,因为出站允许列表仅列出了看板。
- It 可以让智能体撰写一份错误的草稿。有人在它被发送之前会先阅读。
- It 可以尝试让智能体将自身标记为例行,于是工单会进入 Drafted 而非 Needs a human。这是剩余风险。如果这对你的队列很重要,让看板在智能体的标记之上额外应用其自身的关键词规则(用于退款、关闭和访问),并在任一方建议时将工单路由给人工处理。
- It 可以让智能体通过
GET /api/customers/{id}读取其他客户的记录,并将其粘贴到草稿中。这与上面跨工单的问题属于同一种失效,同样的确定性检查可以捕获它。
被毒化工单导致的最坏结果是:有人在它发出前读到错误草稿,或看板 Drafted 列审查放行内容。
如何使用 DigitalOcean Insights 和 Signals 了解智能体过夜的行为?
看板上的每一次状态变更都是带时间戳的记录,记录了谁做了什么:到达、认领、分类、批准、拒绝、发送。代理会话也有自己的事件日志,您可以使用 doctl harness-runtime logs 查看,或在 Insights 中查看。在依赖会话日志之前,请先检查一件事。
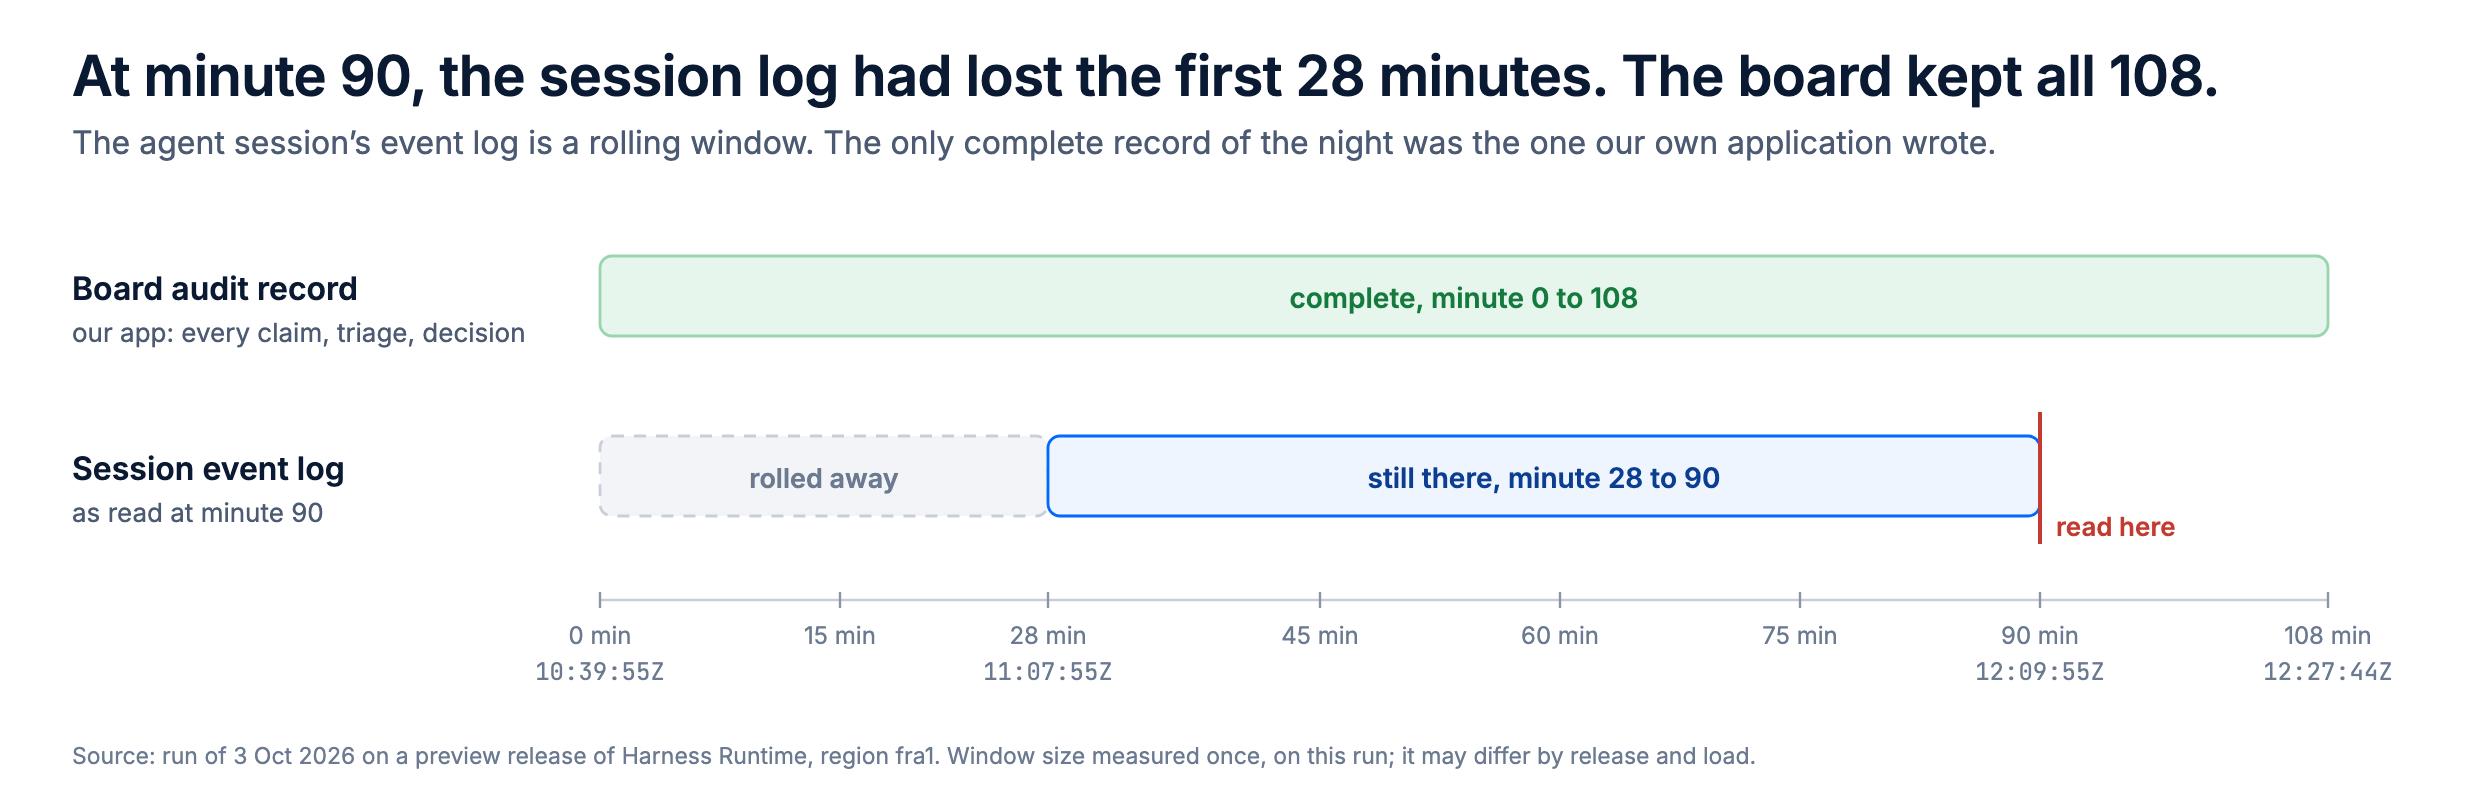
如何读取此图。 水平时间轴表示运行本身,从第一分钟(10:39:55 UTC)到最后一分钟(第 108 分钟,12:27:44 UTC)。每个条形代表一次发生的事件记录。顶部条形是看板对每项认领、分类和决策的完整历史记录;它是绿色的,覆盖整个运行。底部条形是在第 90 分钟读取的代理会话事件日志,由红色线条标记。其前 28 分钟以灰色虚线表示,已经滑出窗口;只有第 28 分钟至第 90 分钟的数据仍然存在。图表并未说明平台会以固定速率丢失数据;我们仅在一次预览版本上测量了一次窗口大小,实际可能随负载和版本而变化。
当晚唯一完整的追踪记录是应用程序保存的那份,之所以存在是因为我们亲手构建了它。您可以使用 DigitalOcean Insights 作为运营视图,这是调试上周二运行的合适工具。若审计师想知道九个月前谁批准了退款,他们需要应用程序自身的仅追加记录,记录每个决策及其决策者。
您还可以查看我们的文章 如何将 Insights 与 Harness Runtime 配合使用,以了解如何使用 Insights 调试 AI 智能体 Harness Runtime 运行。
此外,要调试与您的 AI 智能体的真实对话,请查看我们的文章 如何使用 Signals 查找 AI 智能体的真实故障并用 Evaluations 进行测试。
整夜让它一直运行要花多少钱?
Harness Runtime 按秒计费:$0.044 每 vCPU-小时和 $0.0095 每 GB-小时内存。默认的 mars-2vcpu-4gb 沙盒在满载情况下每小时成本为 $0.126。直到活跃 CPU 计费功能上线前,定价页说明 CPU 按分配 vCPU 的 25% 计费,于是今天等待会话的费用与繁忙会话相当,约为每小时 $0.06。
单个 mars-2vcpu-4gb 会话的计算资源 |
每小时 | 本次运行(1 小时 48 分钟) | 10 小时夜间 | 30 晚 |
|---|---|---|---|---|
| 今天(CPU 按 2 vCPU 的 25% 计费,外加 4 GB 内存) | 约 $0.060 | 约 $0.11 | 约 $0.60 | 约 $18 |
| 满载 | $0.126 | $0.23 | $1.26 | $37.80 |
| 已暂停 | $0 计算 |
计算资源所占比例小,模型 token 所占比例大,且随 agent 每张票读取量而变。若 agent 保持一段长对话,则每轮都会重读之前的票据,导致 token 消耗增加,这也是其他客户数据出现在上述草稿中的原因。我们在此次运行中未捕获 token 数量,可查看 推理定价 了解您所用模型的情况。如果您大多数月份都在运行 agent,则 Agent Droplets 计划 可对符合条件的使用量提供折扣:$50 Pro 方案享受 15% 折扣,$200 Team 方案享受 20% 折扣。
何时使用此设计,何时不使用
| Use it when | Do not use it when |
|---|---|
| 夜间工单堆积,早晨班次在分类上浪费时间 | 客户需要在凌晨 3 点前几分钟内收到回复;此设计本质上要等待人工处理 |
| 某些工单类别涉及金钱、访问权限或数据,绝不能自动回复 | 您的帮助台在未获回复或关闭权限时无法发放凭证,也不能在其前方放置代理 |
| 您希望在上午 9 点前有草稿和优先顺序待处理 | Agent 需要它无法读取的数据(计费、使用情况),于是会把该类别的所有工单升级,正如我们之前的 13 张计费工单所做的 |
| 您可以审阅草稿,而不只是批准它们 | 您的帮助台仅在私有网络内可达。Harness Runtime sessions 无法连接到私有 VPC 资源今日 |
| 您将在应用中构建审计记录 | 您计划依赖会话事件日志以满足合规 |
此设计尚未完成的功能及后续计划
第二天早上走到看板前,您会看到有 62 张附带原因的工单在等待,以及 37 份已完成的草稿。这 37 份草稿都仍在等待有人点击发送,其中包括每天都安全的那些。取消发送路径换来了此次运行所依赖的信任,这也意味着每条回复——无论是否安全——都需要一次人工点击。
这个系列的第二部分从此展开。哪些草稿足够常规,可以自行发出?在允许之前必须具备什么条件?以及智能体如何在从未持有可能导致不当行为的凭证的情况下为客户行动?答案是 通过 Action Gateway 进行凭证经纪,平台会在每次调用时附加凭证,而 服务器端批准规则 能够冻结涉及金钱或访问的任何调用。在编写之前,我们与支持队列的人员坐下来,提出一个问题:在什么情况下你不会让它自行行动?
| 部分 | 领域 | 承诺 |
|---|---|---|
| 1(本文) | 云支持 | 读取过夜堆积,草拟所有内容,但不发送 |
| 2 | 云支持 | 常规回复可自行发出;涉及金钱、访问或面对愤怒客户时由人工冻结;凭证不再由智能体持有 |
| 3 和 4 | 销售 | 对入站销售队列采用相同的两个步骤 |
| 5 和 6 | 人力资源 | 对人力资源请求采用相同的两个步骤 |
关于该主题的常见问题?
1. 为什么不直接在系统提示词中告诉模型‘永不发送回复’?
因为提示词是文本,每张工单同样也是文本。工单可能包含与您的指令竞争的指令,而模型无法可靠地根据指令来源进行排序(OWASP LLM01)。保留该指令,但将凭证作为控制手段:如果智能体的令牌无法调用发送路由,且其网络无法访问其他任何资源,则没有可说服它的东西。
2. 如果智能体没有发送路由,被注入提示词的工单仍然可能造成损害吗?
它可能生成糟糕的草稿,试图把自己标记为常规操作,或者把另一位客户的详情拉入草稿。如果已设置出站允许列表,它不能向外部主机发送、退款或外泄数据。每份草稿在离开前都会有人审阅。对姓名和金额的确定性检查能够捕获跨客户泄漏。
3. Harness Runtime 出站是否默认锁定?
不。出站在规范未命名至少一个主机之前是不受限制的。命名任何主机会打开允许列表,平台会自动添加模型端点及其自身所需的主机。对于支持智能体,只需列出帮助台主机,无需其他内容。请参阅 出站网络。
4. 如果会话在票据中途死亡,智能体所认领的票据会怎样?
它们将保持已认领状态,直到您的应用释放它们。平台在暂停和恢复时会保留会话,但它不知道什么是票据认领。为认领设置超时,以便被遗弃的票据返回 New 状态,并在长时间无人认领时发出警报。
5. 队列安静时,会话会自行暂停吗?
在没有活动的情况下经过 15 分钟后,会话会暂停,且暂停的会话不产生任何计算费用。不过它不会在运行过程中暂停,因此智能体在一个长轮次内循环会继续计费。为夜间运行设置结束时间,或让 cron 触发器每晚以 fresh 模式启动它。
6. 在 DigitalOcean 过夜运行支持智能体的成本是多少?
默认 2 vCPU、4 GB 沙盒的计算费用大约是每小时 0.06 美元,即十小时夜间约 0.60 美元,暂停时不产生费用。模型 token 的费用通常高于计算费用,取决于所使用的模型以及 agent 每张票读取的量。请参阅 Harness Runtime 定价 和 推理定价。
7. 我可以将其安排在晚上 10 点启动,并在早上将摘要发送到 Slack 吗?
是的,使用 cron trigger 和 --output-mode slack。触发器会拒绝具有 ask 权限的规范,因为没有人可以回答提示词;使用带有显式拒绝规则的允许默认值,并将真正的安全保存在凭证和出站列表中。
结论
本文以一笔在凌晨 2 点到达的 6,868 美元退款请求开头。以下是其处理过程。智能体在一分钟内读取了该请求,查看了账户历史,并撰写了一则回复,引用了金额,列出了实例,并承诺进行审查。由于无法发送该回复,它将其保存为草稿,将票据标记为待人处理,然后继续处理下一张票。
这种等待正是整个设计的核心。大约早上 9 点,早班人员打开看板,发现有 62 张票,每张票附有原因,还有 37 份已完成的草稿。该退款请求位于列表顶部,正是它应有的位置,附带一份需要编辑的草稿以及仍需人员决策的事项。无需有人猜测智能体在夜间做了什么。看板保存了每项索赔和每个标签,并带有时间戳,因为我们正是这么构建它的。
我们进入此次运行时,认为模型的判断是接受审查的对象。结果表明,它经受住了考验:全部 35 份敏感票据被阻止。此次运行教会我们的,是我们自身的选择。智能体升级了 13 个计费问题,因为我们从未向其提供计费数据。在后续运行中,它将每份草稿都签署为客户自身的公司,这是因为它从客户记录中读取了 company 字段,而没有人告诉它自己的身份。我们在看板上发现的每个错误都可以追溯到我们之前的配置,且每个错误都可以通过修改文件来修复,而无需调整模型。这对工程团队来说是一个相当安心的状态。
保持标题中的区别。提示词是一种请求。权限是凭证可访问范围的事实。先构建权限,这样智能体就能在整夜读取你所有的敌对工单,最坏的情况只是早上给你交一份糟糕的草稿。接下来这一篇——AI 客服 Agent 上线实战(二)——是我们开始让它做更多事情的起点。
敬请期待AI 客服 Agent 上线实战(二)。
本文中的所有工单、客户和账户历史记录均为虚构,仅为演示而生成。未涉及任何真实客户、个人、公司或支持工单。
您还可以阅读我们之前的生产环境中的推理系列,了解如何在生产环境中管理和部署 AI 智能体。
- 为什么你的 LLM 账单是你预期的三倍
- 为你的推理用例选择合适的模型
- 实践中的提示词缓存:命中率从 7% 提升至 74%
- 多提供商 LLM 路由不是问题——它就是你的架构
- 全栈 AI 应用的真实总体拥有成本
相关阅读
-
如何使用 Signals 和 Evaluations 在 AI 智能体中发现真实故障,以了解如何使用 Signals 和 Evaluations 调试 Harness Runtime 中的 AI 智能体运行。
-
如何使用 DigitalOcean Action Gateway 将你的 AI 智能体连接到 SaaS 工具而不共享凭证,这是AI 客服 Agent 上线实战(二)所基于的设置。
-
智能体永不看到密钥:在 DigitalOcean Action Gateway 中证明凭证经纪,这是允许行动的智能体的凭证模型。
-
停止为重建 AI 智能体付费:使用 Harness Runtime 进行分叉,这是生命周期表背后的检查点、分叉和回滚实验室。
-
生产环境中 AI 应用的实际成本,这是账单中 token 部分的成本。
-
无服务器、专用或批量推理:哪种模式适合你的用例,这是为选择模型运行位置(即智能体背后的模型)。
文档:Harness Runtime 快速入门、环境规范参考、安全会话、功能与沙箱规格,以及 DigitalOcean API 参考



