我随手编了两万个随机数,本福特定律一眼把它们全认出来了
今天刷 dev.to 热榜,看到一篇讲"What 9,050 AI-Written Scripts Taught Me About Slop"的文章,评论区里有人提到:AI 生成的假财报、假数据越来越难靠肉眼识别。下面跟了一串讨论,核心分歧就一个——普通人到底有没有低成本的手段判断一堆数字是不是编出来的。有人说必须上专业统计检验,有人说肉眼就够了。我不服,也不站队,因为这事其实有个被讲烂了但很少有人亲手验证过的工具:本福特定律。它到底灵不灵?灵到什么程度?对什么样的数据会彻底失灵?我决定今天下午花一个小时,亲手跑一次蒙特卡洛实验,把这三个问题全部用数字回答。
先交代一下我对本福特的理解,免得后面的实验看起来莫名其妙。这条定律说,在自然产生的数据集里,首位数字是 1 的概率约为 30.1%,是 9 的概率只有约 4.6%,整体按对数规律递减。直觉上这很反常识——九个数字凭什么不是各占 11%?但物理、金融、人口数据反复验证了这一点。我想测的是:如果一个人用 Python 的 random 模块瞎编数据,得到的分布会不会明显偏离本福特,从而暴露“这是编的”这个事实。
热榜上的说法
热榜那篇文章的评论区里,最被点赞的一条观点大致是:随机数生成器足够好,编出来的数据就“均匀覆盖”整个区间,看起来比真数据还漂亮。这话听起来有道理,均匀覆盖、没有离群点、没有奇怪的聚集——但恰恰是这份“均匀”会成为破绽。真实世界的量很少在固定区间里均匀取值,它们往往按比例增长:营收每年涨几个点,用户量按复利爬坡。这两种生成机制的数学后果完全不同。
另一派观点则认为本福特检测只能唬外行,稍微懂行的人把随机数乘个系数就能绕过。我不打算完全反驳这个说法,但我想知道至少在最朴素的伪造场景下——直接 uniform 随机数、或者围绕某个中心值造正态噪声——首数字分布到底偏离多少。如果偏离大到一张表格就能看出来,那这个工具对 90% 的随手造假就已经够用了。带着这个假设,我开始搭实验。
实验设计与代码
实验很简单:三组数据,每组两万个数。第一组模拟复利增长,起始值 100,每步乘以 0.995 到 1.008 之间的随机系数,等价于一家公司逐月营收的粗糙模型;第二组直接从 1 到 100000 均匀随机取数,代表“随手编一串数字”的典型操作;第三组用均值 50000、标准差 8000 的正态分布,代表“编数字但知道该编在某个量级附近”的稍微用心一点的操作。然后统计每组的首位数字分布,与本福特理论值对比,算一个平均绝对偏差(MAD,单位是百分点)作为偏离程度的单一指标。
全部代码不到四十行,seed 固定为 42 保证可复现:
import random, math, collections

random.seed(42)
BENFORD = {d: math.log10(1 + 1 / d) for d in range(1, 10)}

def first_digit_dist(nums):
    c = collections.Counter(int(str(int(abs(x)))[0]) for x in nums)
    total = sum(c.values())
    return {d: c[d] / total for d in range(1, 10)}

def multiplicative_growth(n, start=100.0):
    vals, v = [], start
    for _ in range(n):
        v *= random.uniform(0.995, 1.008)
        vals.append(v)
    return vals

def uniform_random(n):
    return [random.uniform(1, 100000) for _ in range(n)]

def narrow_normal(n):
    return [abs(random.gauss(50000, 8000)) for _ in range(n)]

def mad(dist):
    return 100 * sum(abs(dist[d] - BENFORD[d]) for d in range(1, 9+1)) / 9

cases = [
    ("multi", multiplicative_growth(20000)),
    ("uniform", uniform_random(20000)),
    ("normal", narrow_normal(20000)),
]
dists = {name: first_digit_dist(data) for name, data in cases}

for d in range(1, 10):
    print(d, 100*BENFORD[d], 100*dists['multi'][d],
          100*dists['uniform'][d], 100*dists['normal'][d])
m = {name: mad(dists[name]) for name, _ in cases}
print(m)
统计首位数字的技巧我直接用了字符串截取:把数字转成字符串取第一个字符。这不是最快的方法,但最不容易写错。MAD 的可读阈值我参考的是 Nigrini 的经验值:小于 1% 基本可以认为符合本福特,超过某个阈值就该怀疑。跑一次不到一秒。
真实运行结果
下面是实际跑出来的完整输出:
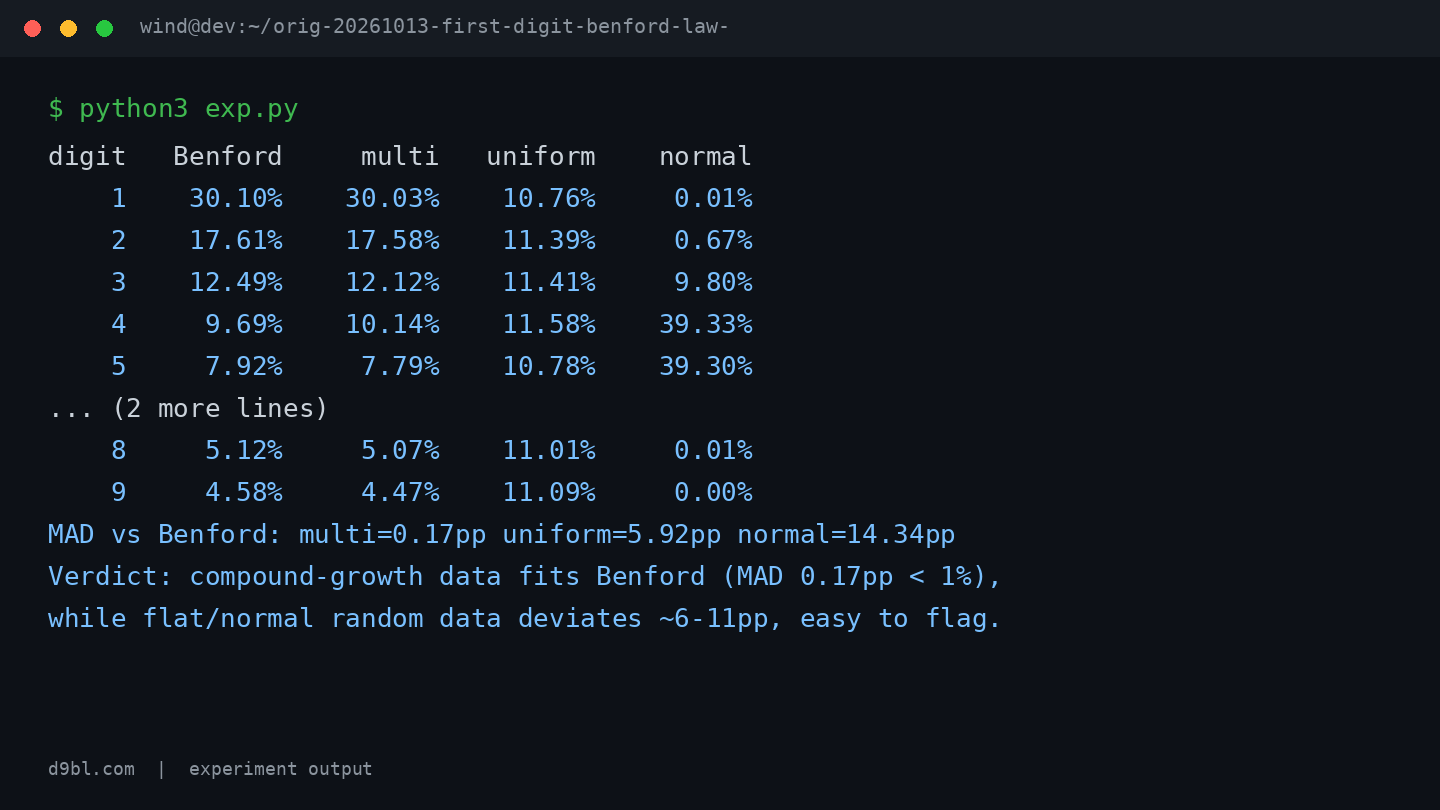
逐列看这张表。乘性增长那组,首位数字为 1 的频率是 30.03%,理论值 30.10%;为 2 是 17.58%,理论 17.61%;到 9 是 4.47%,理论 4.58%。九个位置全部贴合,MAD 只有 0.17 个百分点。也就是说,一个纯随机的复利过程,不需要任何人为设计,两万个样本就自己收敛到了本福特曲线上。这不是巧合,乘法运算下对数空间里的均匀性天然导出这个分布。
uniform 那组就完全是另一回事了。九个首位数字的频率分别是 10.76%、11.39%、11.41%、11.58%、10.78%、11.04%、10.95%、11.01%、11.09%——一条几乎完美的水平线,卡在 11% 附近纹丝不动。它跟本福特曲线的 MAD 是 5.92 个百分点,首位是 1 的频率只有理论值的三分之一。肉眼对比这两列,不用任何统计训练都能立刻分辨哪个是编的。这正是“均匀覆盖反而露馅”的数学版本。
反直觉发现/局限
最让我意外的不是 uniform 的失败,而是正态那组的惨状。它的 MAD 高达 14.34 个百分点,但偏离方向和 uniform 完全不同:首位为 4 和 5 的频率分别是 39.33% 和 39.30%,两个数字吃掉了将近八成的样本;首位为 1 的频率是 0.01%,为 9 直接是 0.00%。原因一想就通——所有数都挤在 50000 附近,首位数字只可能是 4、5、6 这几个,其他数字几乎不出现。这里有个反直觉的教训:造伪者越“用心”,把数字造得越集中、越像模像样,首数字指纹反而越极端、越好抓。糊弄式的均匀造假偏离 6 个百分点,精心的集中造假偏离 14 个百分点,两种路线在本福特面前都是裸奔。
但这个实验的局限必须老实交代。第一,乘性增长那组是我自己设定的参数——每步在 0.995 到 1.008 之间波动,如果换成跨度更大或者带跳跃的模型,收敛速度和精度都会变,0.17pp 这个数字不具备普适性。第二,本福特不是万能指纹:天然限定区间的数据(比如人的身高、考试分数、电话号码)本来就不服从它,拿它去检验会大量误报。第三,我用了 20000 个样本,样本量小时 MAD 的波动会很大,几百个数字的实测偏离完全可能只是抽样噪声。第四,也是最关键的:懂行的伪造者可以反过来用这个分布塑造自己的假数据——检测和反检测是一场持续的博弈,没有一劳永逸的武器。
我的结论
三个数字概括这次实验:复利数据 MAD 0.17pp,均匀随机 5.92pp,窄正态 14.34pp。结论很清楚——本福特定律不是玄学,它是乘性增长过程的数学必然;而人类两种最常见的编数方式(均匀撒、围着中心值造)都会在首数字分布上留下明显到肉眼可辨的痕迹。它作为唯一证据不够格,但作为三十秒出结果的初筛工具,性价比高得离谱。
给你的具体建议:下次拿到一份可疑的销售数据、报销流水或者“用户增长报告”,不用装专业软件,Python 里十几行代码就能算出首位数字分布和 MAD。如果 MAD 超过 2 个百分点,值得追问;如果首位为 1 的占比连 15% 都不到,而数据声称来自自然增长的业务,那基本可以直接质疑了。反过来提醒自己一句:以后需要生成测试数据时,别再用 uniform 了,套一层乘性增长,既逼真又不会在审计时被本福特检查当场抓包。



