背了二十年的找零规则,我造了500套假币制把它打崩
“贪心找零永远最优”——这条结论我大概在大学算法课上背过,后来在无数面试题解里又见过十几遍。推理过程很顺:先用最大面额,再用次大面额,一路往下凑,剩下的金额最小,硬币数自然最少。听起来天衣无缝,我也从来没怀疑过。直到某天review同事代码,看到一个用贪心处理自定义代币面额的函数,我突然意识到一件事:这条规则我从没亲手验证过。它到底是数学定理,还是只是恰好被美元币制惯出来的错觉?我决定写个实验把它钉死。
这篇就是我那次验证的全过程。我造了500套随机币制,让贪心算法和动态规划同台对打,结果比我想象的难看得多。
这条规则是从哪来的
先把规则本身说清楚。贪心找零的流程是:把币制面额从大到小排序,对每个面额尽量多地取用,取完剩下的金额交给下一个面额,直到凑齐或者凑不齐。直觉上它成立,因为“面额越大,单枚硬币抵掉的金额越多”,多用大面额似乎总不吃亏。
但这个直觉有个隐藏前提:硬币面额之间要“配合得好”。比如对任意面额 c,比它小的所有面额加起来,至少要能覆盖一个 c 的价值——美元的 25、10、5、1 就满足这种结构性条件。教科书里其实提到过,贪心找零只对“规范币制”成立,问题是这句话经常被一句话带过,读者记住的只有结论。我自己就是典型的例子:结论背得滚瓜烂熟,规范币制的判别条件一个字都说不出来。
更麻烦的是,现实中非规范币制并不稀奇。很多国家的旧币制、代币系统、优惠券面额组合,都不满足规范条件。如果工程师拿这条“常识”去写实际系统,可能埋下的是真金白银的浪费。
按它推算出的预期
动手之前,我先按教科书逻辑推一遍该看到什么结果。美元币制 [1, 5, 10, 25] 是最经典的规范币制,如果规则成立,贪心在这套币制上跑任意金额,结果应该和动态规划的最优解完全一致,一次都不能错。
换成随机币制呢?说实话,我动手前的预期是“贪心偶尔会差一点,但大部分时候还是对的”。理由是随机生成的四币制里,面额之间多少还有些大小关系,贪心的失误应该是小概率事件,差距应该也就多一两枚硬币。换句话说,我当时赌的是“规则大体靠谱,只是边界情况要小心”。这个预期后来被数据扇得很响。
实验设计也在这里定下来:两组对比。第一组用标准美元币制,跑1000个1到500之间的随机金额;第二组生成500套随机四币制(强制包含面额1,另外四个面额从2到50随机取,去重排序),每套随机一个1到200的金额。贪心和动态规划各算一遍,记录一致的次数、贪心多花的次数、以及最惨的差距。
实验验证过程
代码不长,两个函数是核心。贪心照老套路写,动态规划用一维数组从小到大递推,每个金额记录最少硬币数,这是找零问题的标准DP写法:
def greedy(coins, amount):
    n = 0
    for c in sorted(coins, reverse=True):
        n += amount // c
        amount %= c
    return n if amount == 0 else -1

def dp(coins, amount):
    INF = 109
    best = [0] + [INF] * amount
    for a in range(1, amount + 1):
        for c in coins:
            if c <= a and best[a - c] + 1 < best[a]:
                best[a] = best[a - c] + 1
    return best[amount] if best[amount] < INF else -1
随机种子固定为42,保证结果可复现。跑完1000个美元金额加500套随机币制,输出如下:
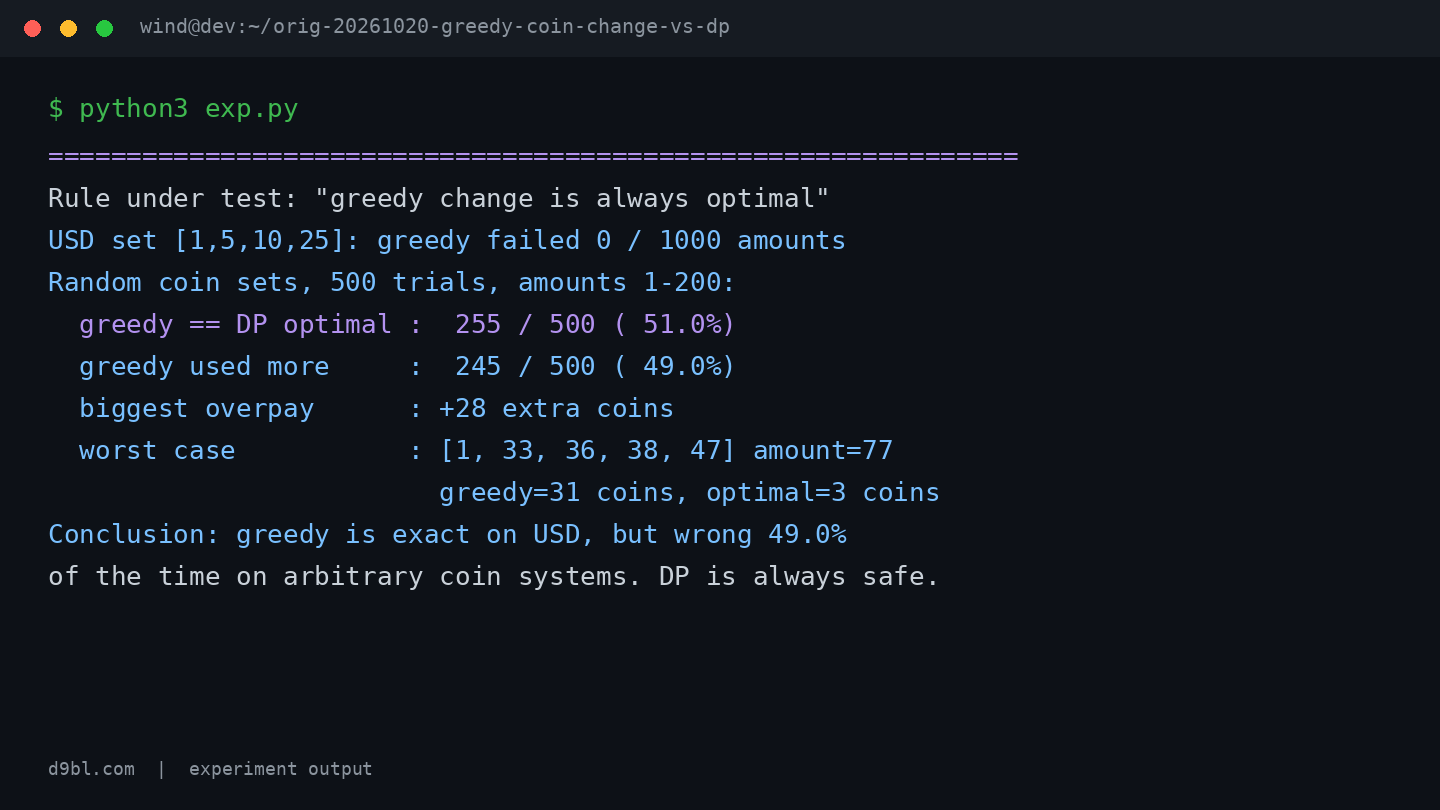
最刺眼的一行是最坏案例:币制 [1, 33, 36, 38, 47],金额77。贪心先拿一枚47,剩30,拿不到33/36/38,只能用30枚1分硬币硬凑,总共31枚。而最优解是33+36+8?不对——最优解是3枚,DP找到的组合直接跳过了47这枚“最大面额”。31比3,多花了28枚硬币,效率只有最优的十分之一不到。这个数字我盯着看了好一会儿,因为它把贪心的死穴暴露得干干净净:贪心根本没有回退能力,它拿走47的那一刻,就已经注定输掉这一局。
数据与理论对上没有
先说对上的部分。美元币制下,贪心在1000个随机金额上失败了0次,和理论预言完全一致——规范币制确实零失误。这一半实验算是对教科书做了次正面确认,规则在它的适用范围内没掉链子。
随机币制那一半就完全对不上我动手前的预期了。500套币制里,贪心和DP打平的只有255套,占51.0%;贪心多花硬币的有245套,占49.0%。也就是说,在任意币制上,贪心几乎是抛硬币——一半概率给你次优解。我原本赌的“偶尔差一点”彻底破产:这不是边界情况,这是接近对半开的大面积失效。
回头看,理论上其实早有解释。贪心的正确性依赖币制的结构性条件,随机币制基本不满足这个条件,所以51%的打平率更像是“运气好撞上规范结构”,而不是规则在起作用。教科书没错,错的是我们把“在美元上成立”偷换成了“永远成立”。实验的价值就在这里:0/1000和49.0%这两个数字摆在一起,规则的适用边界一下子从模糊的脚注变成了可以触摸的事实。
边界在哪
这次实验有明显的局限,得老实交代。第一,我只测了四币制、金额上限200的规模,更大的币制或金额上失效比例会不会更高、更极端,我没有数据。第二,随机币制的生成方式(强制含1、其余2到50均匀取)本身就是一种分布,换成现实中更常见的“小面额密集、大面额稀疏”的分布,失效率可能是另一个数字。第三,DP的复杂度是 O(金额×面额数),金额到千万级就不实用了,所以结论不是“无脑用DP”,而是“先判断币制是否规范”。
反直觉的发现也值得单独说一句:最惨的案例里,贪心不是差一点点,而是差了28枚。这打破了我“贪心最多次优但不会太离谱”的另一个隐性假设。贪心的失效不是平滑劣化,是悬崖式的——一旦开局选错大面额,后面全盘皆输。
所以我的建议很具体:下次你要写找零、凑数、资源分配这类贪心逻辑时,先别问“贪心对不对”,先问“我的数据分布是不是规范结构”。拿随机样本和DP对拍几分钟就能验证,成本极低。如果币制不可控——比如面额是用户自定义的——那就直接上DP,49.0%的失效率不值得赌。这条“常识”我没推翻,我只是终于知道它的边界画在哪里了。



