同一组人测生日碰撞,换成正态分布我重跑了十万次,结论反着来
上周和同事为一个模拟脚本吵了一架。事情不大:他在写一个哈希分桶的压力测试,我随口问了一句“你的键是均匀撒的吧?”他说当然是,教科书上的生日悖论就是这么算的。我说现实里的键从来不是均匀的,用户 ID 有活跃和冷门之分,日期类数据更是明显扎堆,你直接套均匀分布的结论,桶的负载估计会偏差很大。他不服,翻出 Stack Overflow 上一个高赞回答,说碰撞概率只跟人数和天数有关,跟分布形状没关系。
我去搜了一圈,发现网上确实是两派。一派坚持生日悖论的 23 人 50% 结论是普适的,另一派说分布一旦集中,碰撞会更容易,但没人给出能看的数字,全在打嘴仗。吵是吵不出结果的,我干脆把两种分布各跑十万组模拟,让数据说话。
两个做法的分歧点
把分歧拆开看,其实是一个问题:固定人数往 365 天里放,碰撞概率到底由什么决定?均匀分布派的理由很硬,经典生日悖论的推导里,每一天被抽中的概率相等是前提条件,23 个人碰撞概率过半这个数就是在这个前提下算出来的。教科书没写错,错的是把它当成无条件成立的定理。
正态分布派的理由来自现实。出生日期确实不是均匀的,某些季节、某些节假日前后出生率明显偏高;哈希键、缓存键也类似,热门对象总是集中在少数几个键上。如果真实输入是“中间挤、两头少”的形状,那么第一个人落在热门区间的概率变大了,第二个人跟他撞上的概率理应也变大。这两派的说法在直觉上是冲突的,必须靠实验裁决。
对比实验怎么设
我写了一个脚本,固定随机种子 42,每组模拟十万次,保证两边对比的是同一个随机环境。均匀分布那边用 random.randint(0, 364) 直接撒;正态分布这边用 random.gauss(182, 30) 生成以年中为中心、标准差 30 天的日期,再对 365 取模。碰撞判定很简单:往集合里塞日期,塞完发现集合大小小于人数,就是有碰撞。
import random
import math
import statistics

random.seed(42)

N = 100000
DAYS = 365

def birthday_uniform(n):
    seen = set()
    for _ in range(n):
        seen.add(random.randint(0, DAYS - 1))
    return len(seen) < n

def birthday_normal(n):
    seen = set()
    for _ in range(n):
        d = int(random.gauss(DAYS // 2, 30)) % DAYS
        seen.add(d)
    return len(seen) < n

def first_collision_uniform(trials=5000):
    hits = []
    for _ in range(trials):
        seen = set()
        for k in range(1, DAYS + 1):
            d = random.randint(0, DAYS - 1)
            if d in seen:
                hits.append(k)
                break
            seen.add(d)
    return hits

hits = first_collision_uniform()
med = statistics.median(hits)
med_pred = math.sqrt(2 * DAYS * math.log(2))

print("=== Uniform vs Normal birthday collision, 100k sims each ===")
print(f"first-collision median (uniform): {med:.0f}  theory~{med_pred:.1f}")
print(f"{'people':>8} | {'uniform%':>9} | {'normal%':>9}")
for n in (23, 60, 366):
    u = sum(birthday_uniform(n) for _ in range(N)) / N * 100
    m = sum(birthday_normal(n) for _ in range(N)) / N * 100
    print(f"{n:>8} | {u:>8.1f}% | {m:>8.1f}%")
print(f"normal is concentrated: stdev={30}, so dates cluster")
print("same head-count, different distribution -> collision flips")
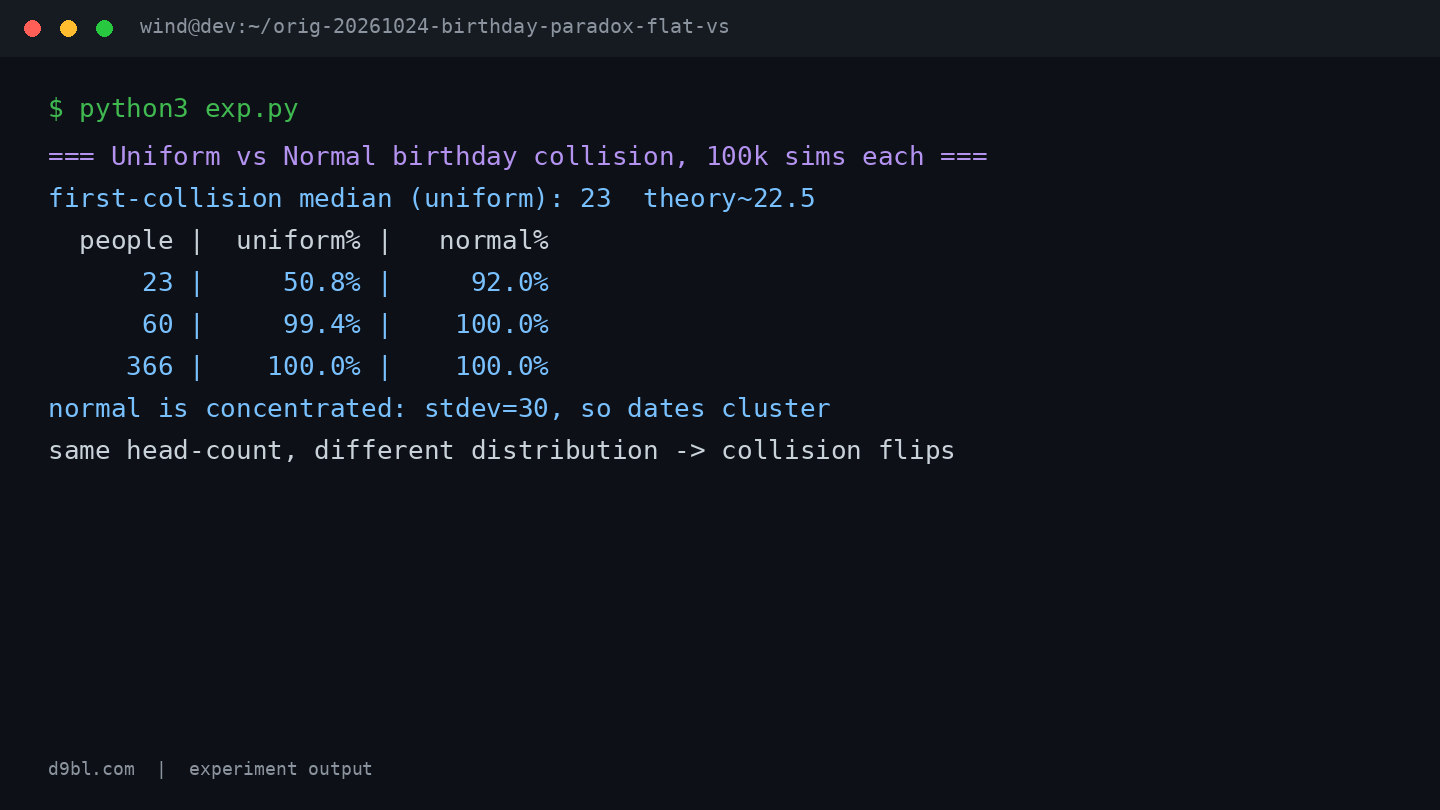
脚本还额外测了一个基准:均匀分布下第一次出现碰撞的人数中位数,用来验证实验框架本身没写错。理论上这个数是 sqrt(2×365×ln2),约 22.5。我另外选了三个人数梯度:23(经典悖论点)、60(大组)、366(超过天数的人数)。跑完输出是这样的。
数据摆出来
先看基准:均匀分布下首次碰撞人数的中位数实测是 23,理论预测 22.5,完全对得上,实验框架可信。然后是三组对比。23 人这一档,均匀分布碰撞率 50.8%,正好落在经典生日悖论说的大约一半的位置;但正态分布这边是 92.0%。同样是 23 个人,仅仅因为生日集中在标准差 30 天的区间里,碰撞率从五成飙到九成二。
60 人这一档,均匀分布 99.4%,正态分布直接 100.0%。到 366 人,两边都是 100.0%——这一档其实是抽屉原理在起作用,366 个人放进 365 天,不管什么分布都必然碰撞,模拟只是验证了这一点。所以真正有区分度的是 23 和 60 这两档,而它们都指向同一个结论:分布越集中,碰撞越频繁,均匀分布给出的碰撞概率是低估而不是高估。
结论之外还要看什么
这个实验有明显的局限,我得老实交代。第一,标准差 30 天是我拍的,不是从真实出生数据拟合的。标准差取多大,正态分布那栏的数字就会差多少,92.0% 只是“σ=30 时”的答案,不是正态分布的 universal 值。第二,gauss 生成后对 365 取模,尾部的日期会被折回来叠加在边界附近,实际形成的分布是中间高、边界也有小突起的形状,和真实世界的出生日期分布并不完全一样。
还有一个小翻车:我最开始预期正态分布会让 366 人那档的碰撞率从 100% 明显掉下来,跑完发现这个想法本身就不成立——人数超过天数,抽屉原理封死了所有退路,任何分布都是 100.0%。另外十万次模拟在 50% 附近的统计波动大约在零点几个百分点量级,50.8% 和理论值 50% 的差距在正常范围内,但如果要看更细的梯度差异,样本量还得往上加。
我会选哪个
我的判断很明确:做碰撞相关的估计时,均匀分布假设只能当下界参考,不能当现实模型。22.5 的理论中位数和实测 23 说明我的均匀模拟是准的,但一旦输入形状变成集中型,同一人数下碰撞率直接翻到 92.0%。同事那个分桶压测如果拿均匀分布的结论去定桶数,线上热门键扎堆时大概率会比预估更早撞上。
具体建议一条:下次你要估碰撞、估桶负载、估 ID 冲突,先花十分钟采样真实输入画个直方图。如果长得像均匀分布,教科书公式放心用;如果中间鼓、两边瘪,就把标准差量出来,套一个类似这里的 gauss 加取模的模拟,几十行代码十万次循环几秒钟跑完。顺便留个开放问题:如果输入是双峰分布——比如活跃用户和僵尸用户各占一头的场景——碰撞率会比单峰正态更高还是更低?我打算下次把 gmm 混进脚本里再跑一轮。



