给实例方法加 lru_cache,6000 次调用一次没命中
报价服务在压测环境里越跑越慢,我把采样工具挂上去看,热路径居然落在一个我两个月前亲手加的 lru_cache 装饰器上。第一反应是缓存没生效,可我清楚记得这个装饰器在单测里是命中过的。要么是我记错了,要么是我漏看了一层东西——而这两种可能,靠盯代码是分不出来的。
我遇到的现场
那段代码长得很正常:定价逻辑包在一个 Pricer 类里,price 方法上面顶着 @functools.lru_cache(maxsize=None),每次请求进来 new 一个 Pricer 对象,然后对请求里的 SKU 挨个调 price。我的想当然判断是:只要 SKU 一样,第二次就该命中,SKU 基数不大,缓存早晚会热起来。事实是 cache_info() 打出来,hits 一直贴着 0 走,currsize 却随着流量稳步往上爬,进程内存曲线跟着一路上台阶。
当时我不敢凭感觉下结论。lru_cache 的命中率受调用顺序影响,压测流量和线上流量分布不同;hits 为 0 也可能是热路径根本没走到缓存,比如 key 里混进了时间戳或者请求 ID 之类的东西。这些都是"看一眼代码觉得没问题"说不清的。我决定把变量收窄到一个我能完全控制的规模里,做一个只有一处差异的对照实验,让数字自己说话。
还有一个促使我做实验的原因:这个 bug 的表现太温和了。服务没报错,接口没超时,只是慢一点、内存涨一点。温和的 bug 最容易被"可能是机器抖动"糊弄过去,我如果只凭压测里那点体感就改代码,改完也不知道自己是不是改对了。
还原实验怎么设
我构造了一个和线上形状一致的小场景:50 个 SKU,300 个请求,每个请求随机抽 20 个 SKU,总调用数 300 × 20 = 6000 次。被缓存的计算函数用一个确定性哈希代替真实定价——真实定价我控制不了耗时,占位函数能让我用一个全局计数器精确数出"到底真算了几次",这比看墙钟时间可靠得多。
对照组和实验组只差一件事:对照组每个请求 new 一个 Pricer,300 个请求就是 300 个短生命周期实例;实验组用一个全局 Pricer 跑完整个批次。两组的 SKU 序列完全一致,随机种子固定成 42,保证差异只来自实例生命周期。为了不让两次实验共用同一份缓存,我用工厂函数每次重新定义一个类——lru_cache 是挂在函数对象上的,类重新定义一次就得到一份干净的缓存,不用手动 clean。
import functools
import random

random.seed(42)

SKUS = ["SKU-%03d" % i for i in range(50)]
REQUESTS, PER_REQ = 300, 20
CALLS = REQUESTS * PER_REQ
work_count = 0

def compute(sku):
    # deterministic stand-in for the real pricing work
    global work_count
    work_count += 1
    total = 0
    for ch in sku:
        total = (total * 31 + ord(ch)) % 1000003
    return total

def make_pricer_class():
    # a fresh class means a fresh lru_cache per experiment
    class Pricer:
        @functools.lru_cache(maxsize=None)
        def price(self, sku):
            return compute(sku)
    return Pricer

batch = [random.sample(SKUS, PER_REQ) for _ in range(REQUESTS)]

work_count = 0
Many = make_pricer_class()
pricers = [Many() for _ in range(REQUESTS)]
for req, skus in zip(pricers, batch):
    for sku in skus:
        req.price(sku)
m = Many.price.cache_info()
work_many = work_count

work_count = 0
One = make_pricer_class()
single = One()
for skus in batch:
    for sku in skus:
        single.price(sku)
s = One.price.cache_info()
work_one = work_count

print("setup      requests=%d  skus=%d  per_req=%d  calls=%d" % (REQUESTS, len(SKUS), PER_REQ, CALLS))
print("300 objs   hits=%-5d misses=%-5d hit_rate=%5.1f%%" % (m.hits, m.misses, 100.0 * m.hits / CALLS))
print("1 obj      hits=%-5d misses=%-5d hit_rate=%5.1f%%" % (s.hits, s.misses, 100.0 * s.hits / CALLS))
print("compute    method=%-5d single=%-5d ratio=%.1fx" % (work_many, work_one, work_many / work_one))
print("cache rows method=%-5d single=%-5d ratio=%.1fx" % (m.currsize, s.currsize, m.currsize / s.currsize))
print("rows/obj   %d per instance, %d instances pinned in cache" % (m.currsize // REQUESTS, REQUESTS))
print("dup rows   %d of %d (%.1f%%) never reused" % (m.currsize - s.currsize, m.currsize, 100.0 * (m.currsize - s.currsize) / m.currsize))
print("hit gap    %.1f pts: 300 short-lived objs vs 1 long-lived obj" % (100.0 * (s.hits - m.hits) / CALLS))
print("verdict    key=(self, sku): cross-request reuse = %d" % m.hits)
写脚本时我特意保留了 work_count 这条独立通道,没有只信 cache_info。原因很实际:如果哪天发现 misses 和真实计算次数对不上,那就说明统计本身有问题,而不是缓存策略有问题。这两件事混在一起查,会浪费掉一整个下午。
跑出来的数据
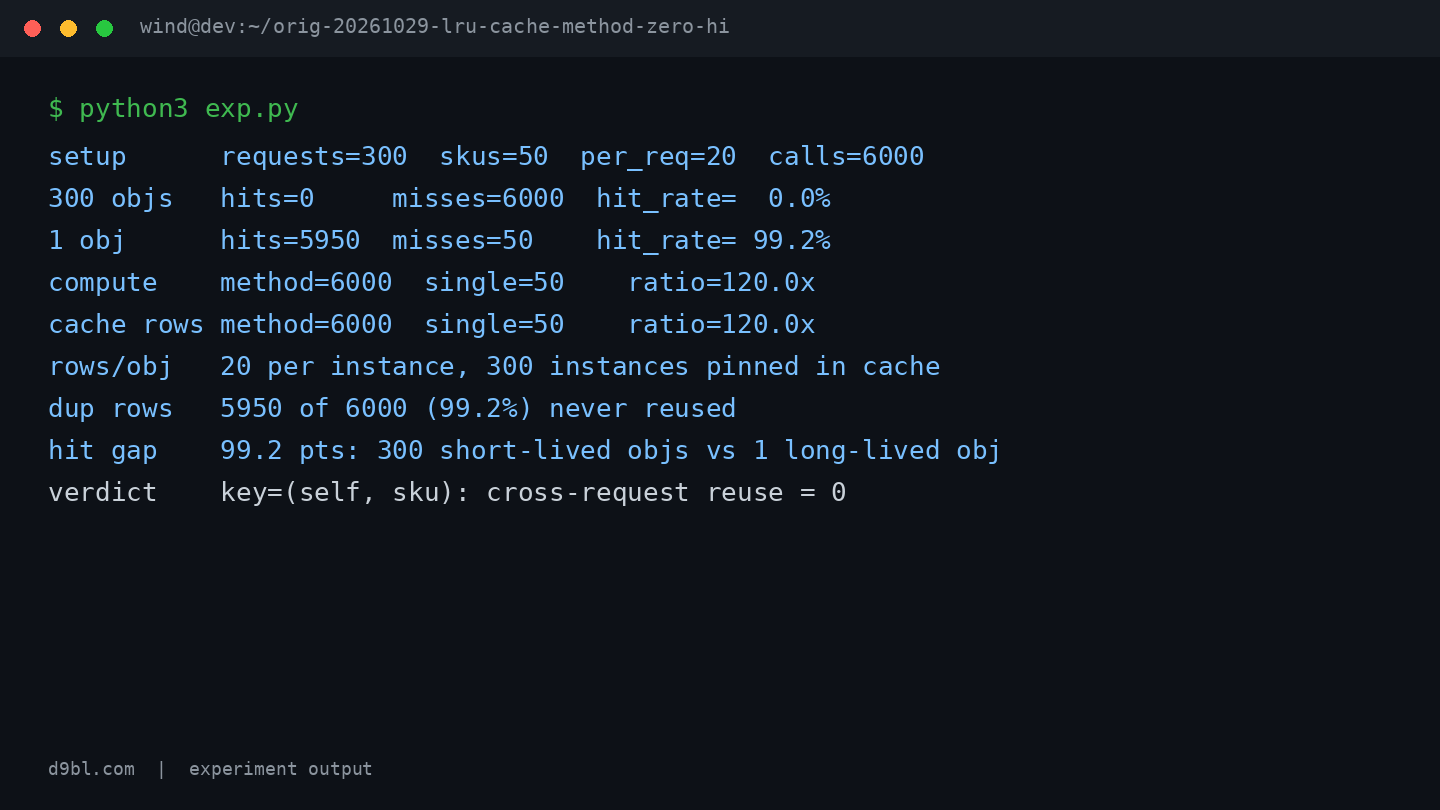
先看前两行。300 个对象那组 hits=0、misses=6000、命中率 0.0%;单对象那组 hits=5950、misses=50、命中率 99.2%。同样是 6000 次调用,同样那 50 个 SKU,唯一差别是 Pricer 实例活多久。这个差距不是"优化幅度",是"有和没有"的区别。
compute 那一行是 6000 对 50,比值 120.0x;cache rows 那一行是 6000 对 50,也是 120.0x。缓存行数和真实计算次数一一对应,说明每一行缓存都是拿一次真实计算换来的,没有一行是白捡的。rows/obj 那行更直白:每个实例 20 行,300 个实例被钉在缓存里。
dup rows 这条是我盯着看了最久的一行:5950 of 6000 (99.2%) never reused。缓存里 99.2% 的行,从写进去到脚本结束,一次都没被读过。最后 verdict 那行把结论钉死:key=(self, sku),跨请求复用 = 0。hit gap 报的 99.2 pts,就是"300 个短命对象"和"1 个长命对象"之间那道沟的宽度。
我原来想错在哪
我一直以为 lru_cache 缓存的是"参数"。实际它缓存的是完整调用签名,落下来就是一个 (self, sku) 二元组。self 是实例本身,默认 __hash__ 继承自 object,按对象身份走。每个请求 new 出来的 Pricer 都是新对象,身份不同,key 天然不同,所以一次都命中不了。这个机制我其实早就知道,但知道和在自己的代码上认出来,是两件事。
更让我意外的是错误的方向。我以为加了缓存最差也就是没效果,实测是有害:6000 行缓存全是死行,而每一行都持有一份 self 的强引用。只要类上的那个 lru_cache 还活着,这 300 个 Pricer 实例一个都回收不掉。这不是"没优化",这是拿内存换了个空,还顺手把 GC 的路堵上了。
实验的局限也在这里必须说清楚。compute 是合成哈希,稳定而且极快,所以 120.0x 只代表"计算次数",不代表"时间省了 120 倍";真实定价如果慢,方法组的绝对耗时会更难看,但比值不会是 120.0。另外我用的是 maxsize=None,这是最坏配置。换成一个小 maxsize,命中率照样是 0,但 LRU 会驱逐,实例会被提前放掉,内存问题就被伪装成纯性能问题,反而更难查。这个对照我跑完才想起来补,是这次实验里唯一让我后悔的地方。
还有一个反直觉的点:SKU 分布散不散,对这个 bug 完全没影响。哪怕 SKU 只有两个,只要 self 每次都换,命中率照样是 0。所以"我们 SKU 基数小,缓存肯定有效"这种判断,在这个坑面前一点用都没有,它判断的是错的变量。
下次怎么绕开
最短的修法是把缓存从类体挪到实例上,让 self 从 key 里消失。做法是在 __init__ 里把 lru_cache 绑定到一个内部方法上,对外仍然通过普通方法调用:
class Pricer:
    def __init__(self):
        self._price = functools.lru_cache(maxsize=None)(self._compute)

    def _compute(self, sku):
        return compute(sku)

    def price(self, sku):
        return self._price(sku)
这样 key 里只剩 sku,实例内部复用是有效的。但得清醒一点:在"每请求一个对象"的拓扑里,实例级缓存等于没有缓存,因为它跟着实例一起死。要真正跨请求复用,还是得走进程级缓存——模块级函数以 sku 为 key,或者显式维护一个有容量上界的字典。判据很简单:缓存的 key 里如果出现 self,先问一句,这个实例活得过下一次请求吗?活不过,这层缓存就是纯负担。
我把这件事落地成了一个能执行的动作,而不是一条记在脑子里的经验:在 code review 清单里加一条硬规则,@lru_cache 出现在 class 体内、且被装饰方法的第一个参数是 self,直接打回,同时加一个 grep 级别的检查跑在 CI 里。记性会失效,工具不会。至于更根本的问题——假设哪天标准库或者某个框架把 self 从 key 里自动剔掉,这个坑会消失吗?我持怀疑态度:一旦缓存被迫跨实例共享,实例状态和弱引用就会变成新的麻烦,那大概是下一次实验的题目了。



