我把 60 个点撒进 512 维,最近邻这个概念差点没了
调一个向量检索的小工具时,同事甩过来一句话:高维里欧氏距离没法用,最近邻跟随机点差不多。我没反驳,因为这话我在几十篇文章里见过,但我确实一次都没自己跑过。
这感觉有点别扭——一条被反复引用、写进无数篇科普的结论,我居然只是把它背下来了。于是我花半小时,用最笨的办法验一遍:撒点、算距离、看最近邻到底比平均距离近多少。不写抽象推导,只看数字。
这条规则是从哪来的
规则本身很朴素。在单位立方体里均匀撒点,维度越高,任意两点之间的欧氏距离越集中在同一个值附近,最近邻那点优势被抹平。这就是距离集中现象,是"维度灾难"里最常被引用的那一半。
我不满意的地方在于,大部分引用这条结论的文章,要么举一万维的极端例子,要么画一张高斯分布的示意图就收工。而我在工程里碰到的是几十维到几百维、样本几千到几百万——正好是中间地带,也是这些文章最含糊的地方。
所以我把它拆成两个能直接算出数字的量。一个是 nn/avg:每个点到它最近邻的距离,除以全体点对距离的平均值,这个数越接近 1,说明最近邻越不特殊。另一个是全体点对距离的变异系数 CV,也就是标准差除以均值,它衡量距离整体的离散程度,越小说明所有点看起来一样远。
按它推算出的预期
先算理论值。单位立方体里两个独立均匀点,每一维差值的平方期望是 1/6,所以 d 维下距离平方的期望是 d/6,距离期望就是 sqrt(d/6)。512 维时这个值大约是 9.24,后面会拿它跟实测对照。
更关键的是离散程度。距离是 d 个独立同分布项求和再开方,相对波动大致按 1/sqrt(d) 收缩。从 2 维到 512 维,维度涨了 256 倍,标准差与均值的比值理论上应该缩到原来的十六分之一,也就是比原来小一个数量级以上。
两个推算合起来给出一个明确预期:512 维时 nn/avg 应该非常接近 1,大概落在 0.94 到 0.95 之间;距离的 CV 应该掉到 0.03 附近。如果实测差得远,那要么是我对这条常识的理解有偏差,要么是实验设计有问题——两种结果都算有信息。
实验验证过程
代码短到可以整个贴出来。60 个点,维度分别取 2、8、32、128、512,每个维度重新撒一批点,seed 固定 42。对每个点算出到其余 59 个点的距离并排序,最小那个作为最近邻;同时把所有点对距离收集起来算均值和总体标准差。没有 numpy,没有 sklearn。
import math, random, statistics

random.seed(42)
N = 60
DIMS = [2, 8, 32, 128, 512]

def probe(dim):
    # iid uniform points in the unit cube, fresh draw for each dimension
    pts = [[random.random() for _ in range(dim)] for _ in range(N)]
    nn, allr = [], []
    for i in range(N):
        ds = sorted(math.dist(pts[i], pts[j]) for j in range(N) if j != i)
        nn.append(ds[0])
        allr.extend(ds)
    avg = sum(allr) / len(allr)
    return sum(nn) / N, avg, statistics.pstdev(allr) / avg

print("Curse of dimensionality: nearest vs typical neighbour (unit cube)")
print(f"{N} random points per dim, all pairwise Euclidean distances, seed 42")
print()
print(" dim   nn_mean   avg_dist  nn/avg  dist_cv")
rows = []
for d in DIMS:
    nn, avg, cv = probe(d)
    rows.append((nn / avg, cv))
    print(f"{d:>4}  {nn:>8.4f}  {avg:>8.4f}  {nn/avg:>6.3f}  {cv:>7.3f}")
print()
print(f"nn/avg rose {rows[0][0]:.3f} -> {rows[-1][0]:.3f} from 2 to 512 dims")
print(f"distance CV fell {rows[0][1]:.3f} -> {rows[-1][1]:.3f}: spread collapses")
print(f"Verdict: in 512d nearest is just {(1-rows[-1][0])*100:.1f}% below the mean")
print(f"In 2d that same gap was {(1-rows[0][0])*100:.1f}%: the rule really does break")
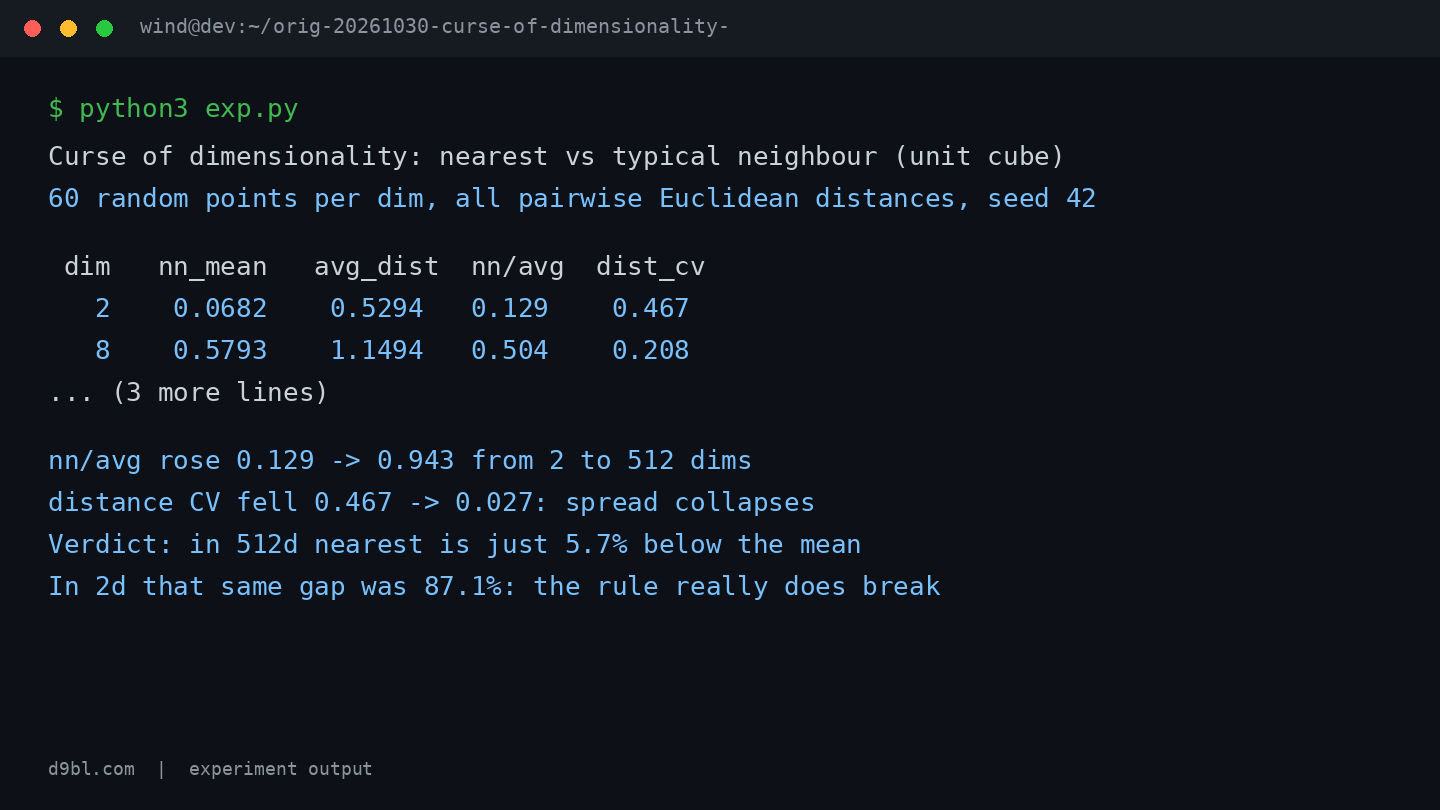
选 60 个点是有意的。点对距离一共 1770 条,对均值和标准差这种统计量够用;同时 60 个点在 512 维空间里稀疏得离谱,正好把"最近邻"这件事推到极限。真换成六万个点,我也不确定曲线会长什么样。
跑之前我猜 512 维那行会很难看,但没预料到 2 维那行会这么夸张。第一行数字出来的时候我盯着屏幕停了两秒,才继续往下看。
数据与理论对上没有
先看 2 维。最近邻平均距离 0.0682,全体平均距离 0.5294,比值 0.129。也就是说在一张平面图上撒 60 个点,每个点的最近邻只有平均距离的 12.9%,比平均值低了 87.1%——这正是"最近邻更近"这句常识最舒服、最不需要解释的形态。
往上走,nn/avg 依次是 8 维 0.504、32 维 0.771、128 维 0.890、512 维 0.943,单调上升,没有回头。距离的 CV 同步塌方:0.467、0.208、0.105、0.052、0.027,一路降到 0.027。两个量完全同步,说明它们确实在描述同一件事,不是某一个指标自己走偏。
跟推算对照。512 维的距离均值实测 9.2359,理论 sqrt(512/6) 约 9.24,对得上;CV 实测 0.027,按 1/sqrt(d) 推算约 0.029,同一量级。nn/avg 的 0.943 也落在我预设的 0.94 到 0.95 区间里。三处都对上了,说明这套理论描述在这个条件下没撒谎。
那 0.943 意味着什么:在 512 维里,一个点最近的邻居,只比随便挑一个点算出的平均距离近 5.7%。你拿着一堆距离排序,第一名和第三百名之间的差距,小到可以被任何一点数值噪声吞掉。至于最近邻距离绝对值从 2 维的 0.0682 涨到 512 维的 8.7077,那只是维度撑出来的尺度,不该拿来做判断。
边界在哪
这次实验有几个明显的窟窿。一是只有 60 个点,N 变大结论会不会动摇,我没测;二是分布只有均匀分布,真实的嵌入向量往往挤在低维流形附近,距离集中会被缓解,用真数据跑出来的数大概率比这个乐观;三是只用了欧氏距离,余弦距离在高维的表现是另一码事,别直接套过来。
还有个反直觉的发现。我原本以为 32 维这个常见维度就已经废了,实测 nn/avg 是 0.771——最近邻依然比平均距离近 23%,排序里保留着相当的信息量。真正开始难看的是 128 维往后(0.890)。"维度灾难"这个词被用得太随手,在 32 维这个量级上恐慌,多半是提前缴枪。
说个翻车细节。我第一版想省事,直接拿 512 维那批点的前 2 维当 2 维结果,跑出来数完全对不上——不同维度的距离尺度没有可比性,同一批点的维度切片也不是独立样本。后来改成每个维度重新撒点,代码注释里那句 fresh draw 就是那次留下的疤。
所以我的建议很具体:别信任何一篇告诉你"高维距离失效"的文章,包括我这一篇。拿你自己的数据算两个数就够了——每个点到最近邻的距离除以全体平均距离,以及全体距离的变异系数。几十行代码,一分钟跑完。CV 掉到 0.05 以下再考虑换度量或先降维;如果数据在 32 维附近而 CV 还在 0.1 以上,最近邻照样能用,别被吓住。我还在想另一件事:如果换成真实 embedding 再跑一遍,那条 0.943 的曲线会往上抬多少。