“我的 AI Agent 总是依赖已被取代的架构决策”,这个问题最直接的修法是写个小解析器:读取每个 ADR 的 Supersedes 字段,把旧记录标记为已替换。我们确实做了这么一个工具。然后拿它跑了另外两个仓库,分别有 270 和 93 条 ADR,结果它把仍在生效的决策报成了已废弃。在较大的那个仓库里,它判定为“已取代”的 5 条记录全是误报。
只抓取 ADR 编号的解析器不只是会漏东西。它还会自己制造误读,而 AI Agent 会信以为真。本文记录我们如何在 ELN workflow(我们内部给 Claude Code 用的插件套件)里重建 ADR 索引,让“哪些决策仍然有效?”由一套确定性的规则来回答,而不是靠模型去读 ADR 正文再猜。本文是上一篇文章的续篇:AI 忽视已有决策的真正原因:设计一个 ADR 上下文自动注入 hook。那篇文章结尾留了两个已知缺口:注入列表到 30 条就截断,另有 29 条用其他格式写的记录完全没被读取。
这些 hook 是 Claude Code 专用的。但问题本身不是:任何 coding agent,不管是 Claude Code、Codex 还是别的,只要在一个有几百条 ADR 的仓库里干活,都得搞清楚哪些决策仍然成立。
简要版
- 保留所有 ADR 文件,让索引来回答哪些仍然有效。 一个解析器每次运行时重新推导每条记录的有效状态。不做缓存,所以不会漂移。解析 167 条记录耗时 0.04 到 0.11 秒。
-
只抓编号的解析器会制造错误。 我们发现了四种模式,每种错法都不一样。“Supersedes: (none — amends ADR-xxxx)”把一条仍在生效的记录变成了“已取代”。重复的 ADR 编号把关系挂到了错误的文件上。小写的
status:标签让一条已接受的记录变得无法读取。另一个仓库的 ADR 编号指向了一条毫不相关的本地记录作为替代项。现在,只有当头部采用严格格式书写时,工具才会判定为“已取代”。 -
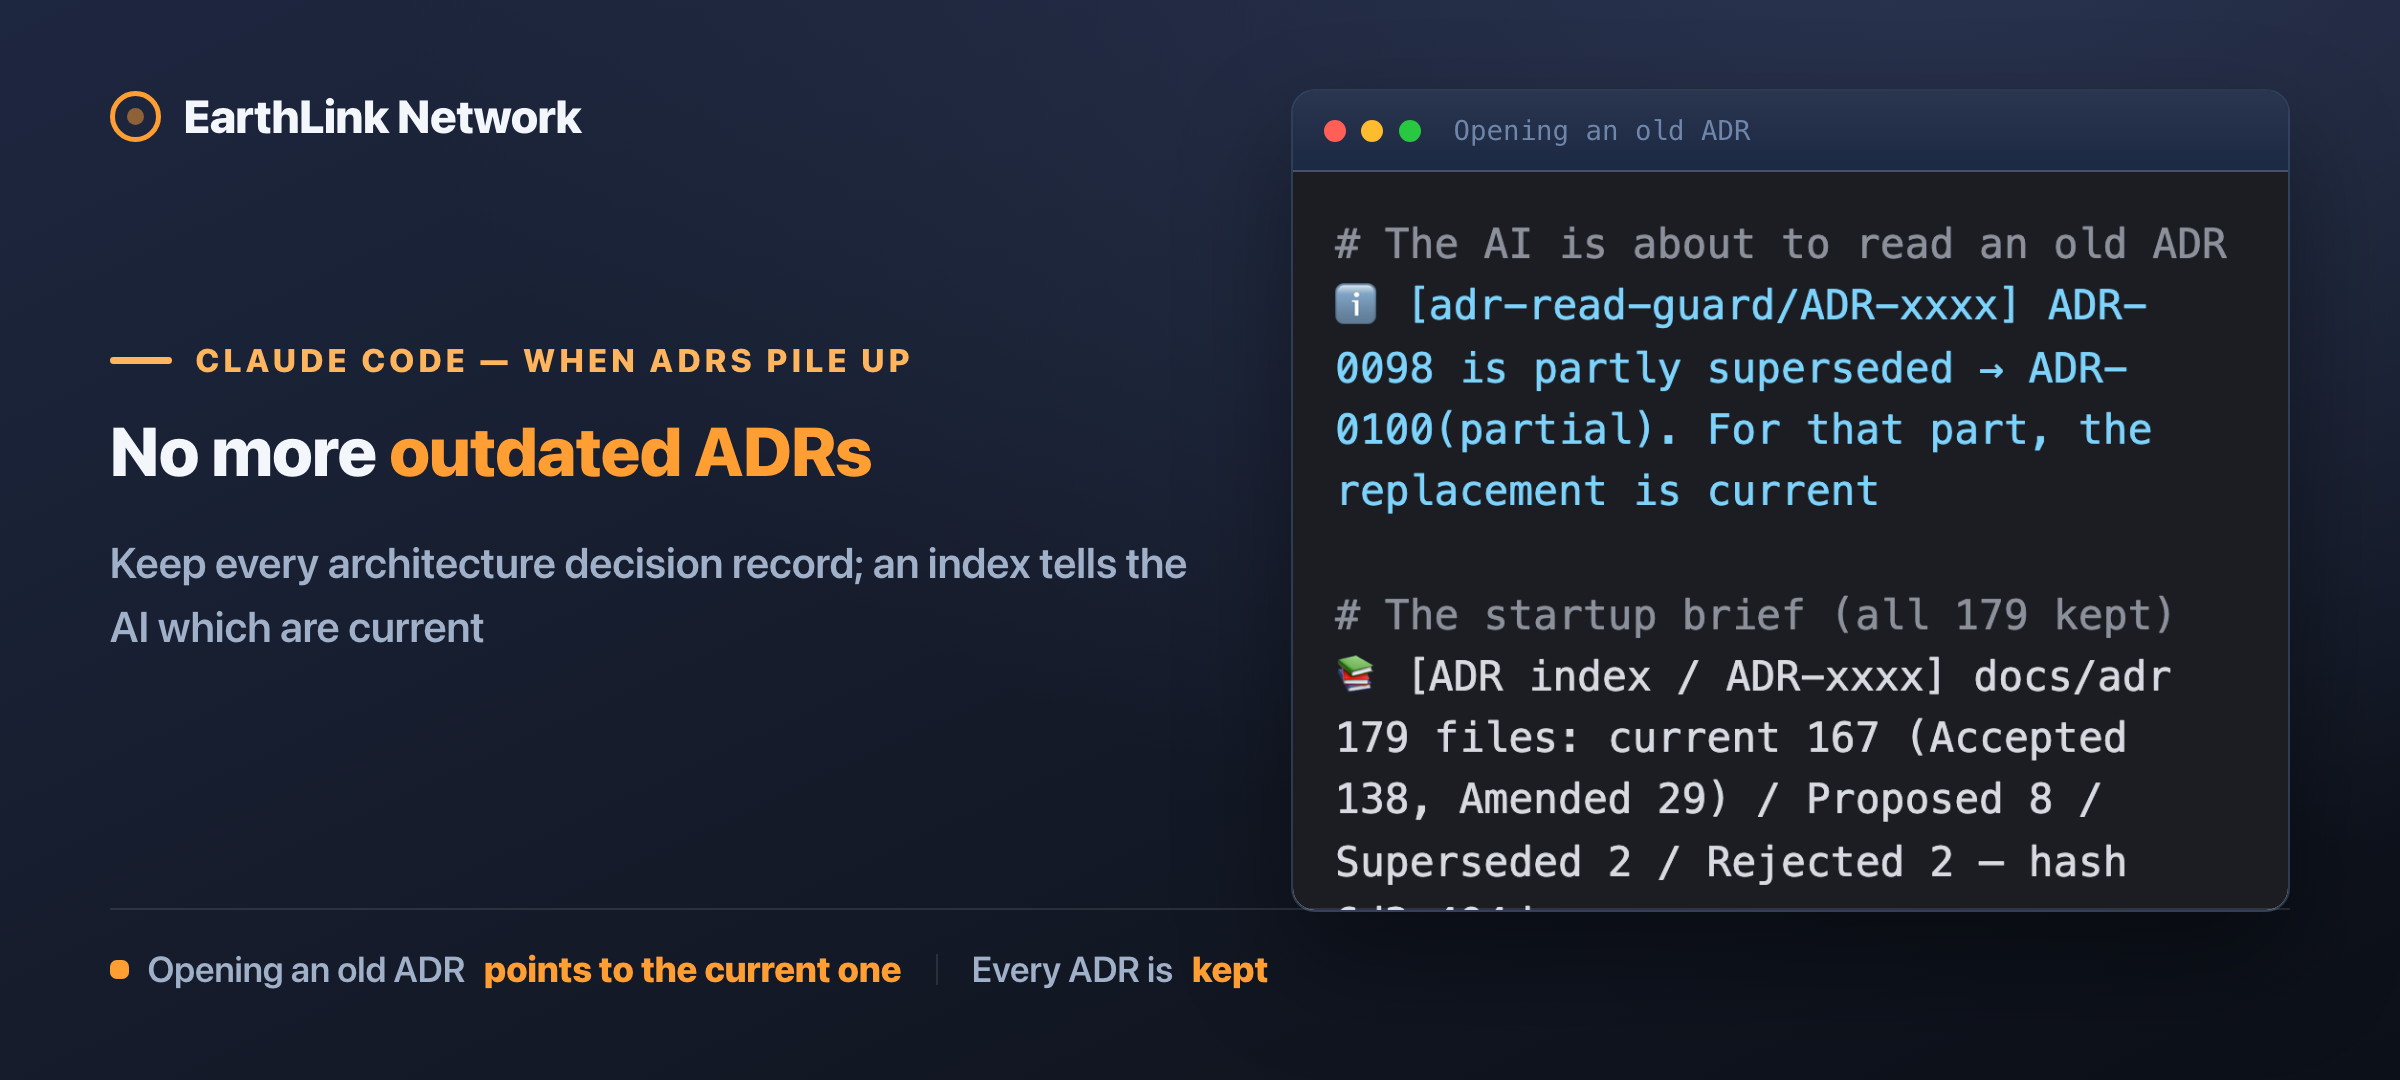
告诉 AI 的内容反而把它引向了最老的决策。 上一篇文章结尾提到的两个缺口在 167 条记录时依然存在:会话启动索引只列出最老的 30 条决策,并让 Agent 用
ls docs/adr/查看其余部分;另有 29 条有效决策因为状态行是粗体而不可见。只有 3 条记录在机器可读的头部声明了替代关系;76 条是在正文里提到的。
cat,且从不阻断);对拉取请求所改动的头部行做 CI 检查;以及一条命令,同时更新旧 ADR、新 ADR 和索引。只认数字的 ADR 解析器会误读的四种情况
第一版会抓取 Supersedes 和 Superseded by 字段中的每一个 ADR 编号。对照真实文件检查,并在另外两个仓库上运行后,发现它把四类头部信息读错了。
-
带注释的“none”。有些记录写的是
Supersedes: (none — amends ADR-xxxx):没有取代任何记录,只是修订了另一条。抓取编号会让被修订的记录看起来已被取代。在我们插件自己的仓库里,会有两条现行决策被误报为已被替换。另一个仓库有 7 条记录写成“none (does not overturn ADR-xxxx)”。 - 编号重复。两个不同文件可能带有相同的 ADR 编号(一个仓库有 9 对,另一个有 4 对)。只按编号追踪,会把关系挂到错误的文件上。
-
小写标签。
- status: Accepted没有被读取,于是一条已接受的记录被算作未知状态。 - 其他仓库的编号。“Superseded by: some-other-repo ADR-xxxx”指向了本地一条编号相同的无关记录,被当成了替代者。
由此得出的规则很短,主要讲的是解析器拒绝推断哪些内容:
- 只有当字段值是纯
ADR-NNNN编号列表时,记录才算已被取代。值中只要出现任何说明文字,就标记为部分取代,只展示不应用。 - 以
none(或日文“なし”)开头的值不建立任何关系,无论后面跟着什么编号。 - 如果声明方记录仍处于 Proposed 状态,旧记录保持现行,关系显示为待定。一条未经批准的新 ADR 不能在第一天就抹掉一条现行记录。
- 编号前面带有含连字符或下划线的标识符时,视为外部编号,仅以文本展示。
- 涉及重复编号的关系不予应用,因为工具无法判断指的是哪个文件。
- 解析器读不出的状态一律计为未知并显示出来,绝不悄悄丢弃。
Agent 实际收到的信息
有人建议把阅读规则写进 README。但一条 Agent 可能读、也可能不读的说明,没有机制上的保障,我不放心,所以先做了测量。当时仓库里有 167 份 ADR,总计 2,171,690 字节,最大的一份 68,777 字节。
-
会话启动索引只列出了最早的 30 条现行决策(3,511 字节),并提示用
ls docs/adr/查看其余部分。决策越新,Agent 越不容易看到。当初引入这个索引的 ADR 写过"超过 30 条后重新审视";167 是 30 的 5.6 倍。 -
29 条现行决策不可见。索引只认
- Status: Accepted,不认- **Status**: Accepted。有 30 条记录用了加粗写法,其中 29 条是现行决策。索引看到 126 条现行决策,实际数量是 155 条。 - 取代关系只写在正文里。3 条记录在头部字段声明了替代关系,76 条在正文某处提到过替代。
-
Agent 更多通过 shell 而不是 Read 读取正文。测量前四周的 38 个会话中,ADR 正文用 Read 工具读取 37 次(其中 33 次只读一个行范围),用
cat、sed、head或tail读取 80 次。原有的大文件警告只监控 Read 工具,而且只在超过 1,000 行时触发。最长的 ADR 有 648 行,警告从未触发。 - 手写索引表停在第 122 条记录,缺了 45 条。
我担心的那种行为——Agent 用 cat 一次性读取所有 ADR——在这 38 个会话里一次都没发生。它实际做的是列出目录(36 次),按文件名挑选,再逐个读取,这正是索引让它做的事。
保留文件,每次重建索引
ADR 存在的意义,是让今天设计背后的推理可以追溯;删掉旧记录就失去了这一点。所以文件保持原样:不删除、不移动、不拆分。插件的技能、钩子和脚本按编号和路径引用 ADR,167 条记录中只有一条 ADR 没有被任何地方引用。移动文件会破坏这些引用。
"这条决策是否现行?"由索引来回答,每次都由一个解析器从头部字段(状态、日期、取代、被取代)重新构建。仓库里没有提交 index.json,也没有缓存,因为存储的索引会像手写表一样逐渐偏离文件。
docs/adr/README.md 里那份供人阅读的表格还在,但它是自动生成的:eln-adr 会重写一个带标记的区块,如果该区块与重新运行生成的结果不一致,CI 就会失败。简报和读取警告从不使用那张表,它们用的是对文件的解析结果。
| 生效状态 | 含义 | 是否计为当前 |
|---|---|---|
| live | 已接受或已修订,未被取代 | 是 |
| partial | 部分被更新的记录取代 | 是,并显示取代它的记录 |
| superseded | 已被更新的记录取代 | 否 |
| proposed | 尚未接受 | 否 |
| rejected | 我们未采纳的选项 | 否 |
| unknown | 状态不在固定词表内 | 否,并计入计数 |
索引如何送达 Agent
没人读的索引改变不了任何事。送达路径有四条。
会话开始时的简报
Claude Code 启动时,一个钩子(Claude Code 在固定时机自动运行的脚本)会把以下内容放进 Agent 的上下文。

顺序是固定的:计数、CLI 用法、被取代记录表、按修订日期排序的最新 10 条记录、proposed 计数。预算为 1,200 字节,裁剪顺序同样固定(proposed 降为计数、缩短标题、最新记录减到 8 条、再减到 6 条、被取代记录表降为计数、标题再缩短,最后去掉最新记录列表)。计数行、CLI 行和被取代记录的数量始终保留。简报从不引导 Agent 去执行 ls docs/adr/。在 compact 或 resume 之后,只注入不超过 300 字节的指针:上下文刚被压缩就推回一大块内容,等于让压缩白做,而索引随时可以用 CLI 重新生成。
Agent 即将读取 ADR 时的警告
第二个钩子在 Agent 读取 ADR 之前运行,查出该记录的生效状态,只在确有影响时才出言提醒。

-
覆盖 Read 和 shell 两条路径。正文读取有三分之二走 shell,所以钩子还会检查
cat、head、tail、sed、awk、bat、less、more的参数里是否带 ADR 路径。 -
提示内容视情况而定。已被取代的记录给 ⚠️ 并附上替代记录。部分取代,或完整读取超过 16 KiB,给 ℹ️ 并提示用
show。三个及以上文件,或用通配符,则判定为批量读取。 - 只警告,不拦截。每次警告都会连同判断是否正确一起记入日志。只有在至少记录 25 次警告、且误报率不超过 5% 之后,才会升级为:读取已被取代的记录前先询问人工。
每条警告都带 CLI 路径。Claude Code 内部启动的子 Agent 收不到会话启动简报,对它们来说这条警告就是唯一的指引。
eln-adr show:先看要点
show 用不超过 2.5 KB 返回一条记录的核心信息。

这里一条 25,216 字节的记录压缩成了 878 字节。有了状态、替代记录、修订、标题所在行号和决策开头,就足以判断要不要继续读,以及读哪几行。
show 还会在部分被取代的记录上标 ⚠️,并把替代记录标注为“(partial)”,提示 Agent 那部分要去读替代记录。记录本身仍算现行有效,状态行写的是“effective: partial”。
CI 只查改动行,每个生命周期步骤一条命令
索引做得再对,下一个写错的头部就能把它毁掉。CI 检查 PR 新增或修改的 ADR,而且只查改动过的头部行:状态词、- Date: YYYY-MM-DD 行、取代字段的格式、只在单边声明的取代关系、新增的重复编号。每类失败都有对应的原因码。未改动的旧记录不会被拦,所以现有 167 个文件不必一次性重写。
接受、修订、取代各是一条命令。eln-adr supersede <old> --by <new> 会一次性写入旧记录的“Superseded by”、新记录的“Supersedes”以及索引表。默认是试运行,只有加上 --write 才真正写入。写入前会重新解析结果,只要以下任一项不通过就完全不写:目标字段之外的行保持不变、CI 检查零阻断问题、再次运行同一命令不产生任何变化、字段中已有的每条声明仍然存在。
数据
用同样的命令测量,之前 167 条记录,之后 168 条(这次变更本身的 ADR 也加了进去):
| 之前 | 之后 | |
|---|---|---|
| Agent 启动时收到的文本 | 3,511 B(最旧的 30 条) | 1,140 B(计数、被取代表、最新 10 条) |
| 索引中可见的有效决策 | 126 | 155 |
| 被取代表 | 0 行 | 5 行(另有 2 条待定) |
“用 ls docs/adr/ 查看其余” |
有 | 无 |
后来又测了一次,179 条记录:

- 179 条记录中有 167 条是当前有效的:161 条有效,6 条部分被取代。8 条提议中,2 条被取代,2 条被否决,0 条未知。
- 按旧的计数方式只能看到 139 条。28 条有效决策在旧索引中不可见。新索引把 167 条全部计入。
- 简报为 1,186 字节,又多了 12 条记录后仍在 1,200 字节预算之内。紧凑指针为 232 字节,低于 300。
收尾
保留全部ADR是正确决定。问题出在让模型自己从正文推断“这条是否仍然有效”。只要模型还在做这个推断,随着记录数量增长,启动列表就会越来越偏向旧决策,Agent不得不逐条打开正文核对,还要为此消耗token。我们把答案移入一个索引,每次依据同一套规则构建,在启动时以及即将读取旧记录时提供,并通过CI和一步命令让新记录的头部保持严格。最关键的一条规则是事先确定解析器不得推断哪些内容;没有这条规则,解析器自己就会把仍然有效的决策报告为已被取代。
注释:术语与截图
-
ADR(架构决策记录)。 记录一项设计决策、为何做出该决策以及还考虑过哪些方案的简短文档。ADR通常编号,存放在
docs/adr/。头部包含状态(Accepted、Amended、Proposed、Superseded、Rejected),以及它取代了哪些记录、又被哪些记录取代的字段。 - 钩子(Hooks)。 Claude Code在固定时机自动运行的脚本。SessionStart在会话开始时运行;PreToolUse在工具调用前运行。钩子的输出会进入Agent的上下文。
-
Read与Bash。 Agent在Claude Code中读取文件的两种方式:专用的Read工具,或通过Bash工具执行
cat、sed等shell命令。 -
截图。 四张图都是钩子和我们插件仓库中
eln-adr的真实输出,按终端样式排版。工具输出为日文,因此本英文版对标签做了翻译;数字、记录编号和字节数保持不变。其他改动:包含我主目录的CLI路径缩短为<plugin>/scripts/eln-adr.py;钩子打印的标签中,这套机制自身的设计记录编号显示为ADR-xxxx;简报“最新”列表中的标题,以及图2和图3中示例记录的标题和正文,因涉及内部系统名称或描述,用■遮蔽。记录编号均为真实编号。 - 数据采集时间。 前后对比在167条记录(之前)和168条记录(之后,加入了本次变更的ADR)时测得,当前数据在179条记录时测得,使用相同命令。会话数取自对话日志中的工具调用输入。
关于ELN工作流——我们自研的、用于保障AI开发质量的插件套件——的文章将继续以系列形式发布。感兴趣的话,欢迎点赞关注。
我们的产品:https://www.eln.ne.jp/products
EarthLink Network 自研产品,让整个公司跑在 AI 之上——每一款产品都源于一路走来的实际需求。以下是我们的产品全览:
→ EarthLink Network 自研的 18 款产品
想了解公司及各产品的更多信息,请访问 www.eln.ne.jp。