想理解神经网络是怎么工作的,从直线方程入手是个不错的选择。我在上一篇文章中正是这样做的,见用直线方程(y=ax+b)讲透神经网络的工作原理。
但如果输入和输出之间的关系不是线性的呢?
我们都知道,现实世界中的数据并不总是呈直线分布。有趣的地方就在这里:有时候,仅靠一条规则不足以描述变量之间的关系。
这时就需要非线性了。它让神经网络能够捕捉数据中不断变化的行为。
本文将探讨非线性的概念,以及它如何捕捉数据中的复杂关系。我们会通过一个简单的例子,理解分段线性曲线、ReLU 函数、S 形曲线和 sigmoid 函数,看看它们如何帮助神经网络学到直线无法描述的模式。
目录
前置知识
对线性函数有基本了解
熟悉深度神经网络的基本概念
直线够用的时候
直线方程意味着,无论在哪个区间,适用的都是同一条规则。
y = ax + b
y => Output variable
x => Input variable
a => Amount by which y changes when x changes (slope)
b => Value of y when x is 0 (y intercept)
我们可以通过一个例子来加深理解。
Poly 老师是一位数学老师,想为学生制定一份备考计划,帮助他们在期末考试中取得好成绩。她根据一个因素总结出一条经验法则:每周学习时长。也就是说,学生的分数与学习时间成正比。
基于这一假设,她得出了 y=ax+b 形式的方程。
y => Marks scored
x => Number of hours studied
a => Increase in marks for every hour studied
b => Minimum marks every student is capable of scoring without studying.
于是,季度考试结束后,她对学生做了访谈,收集了他们每周学习数学的小时数。她整理出一张两列的表格:每周学习小时数(x)和考试得分(y),并把这些数据绘制成图。
| 每周学习小时数 | 考试得分 |
|---|---|
| 0 | 40 |
| 1 | 40 |
| 2 | 41 |
| 3 | 40 |
| 4 | 48 |
| 5 | 58 |
| 6 | 69 |
| 7 | 80 |
| 8 | 80 |
可当她套用之前那个简单公式时,结果却和数据对不上——现实中的数据,往往没有这么规整。
直线不够用了
Poly 老师仔细观察图表,发现了几条规律:学习时间较短的学生,成绩提升有限;一旦超过某个临界点,多学一小时,分数就开始明显上涨;而过了另一个临界点之后,分数又趋于平稳。
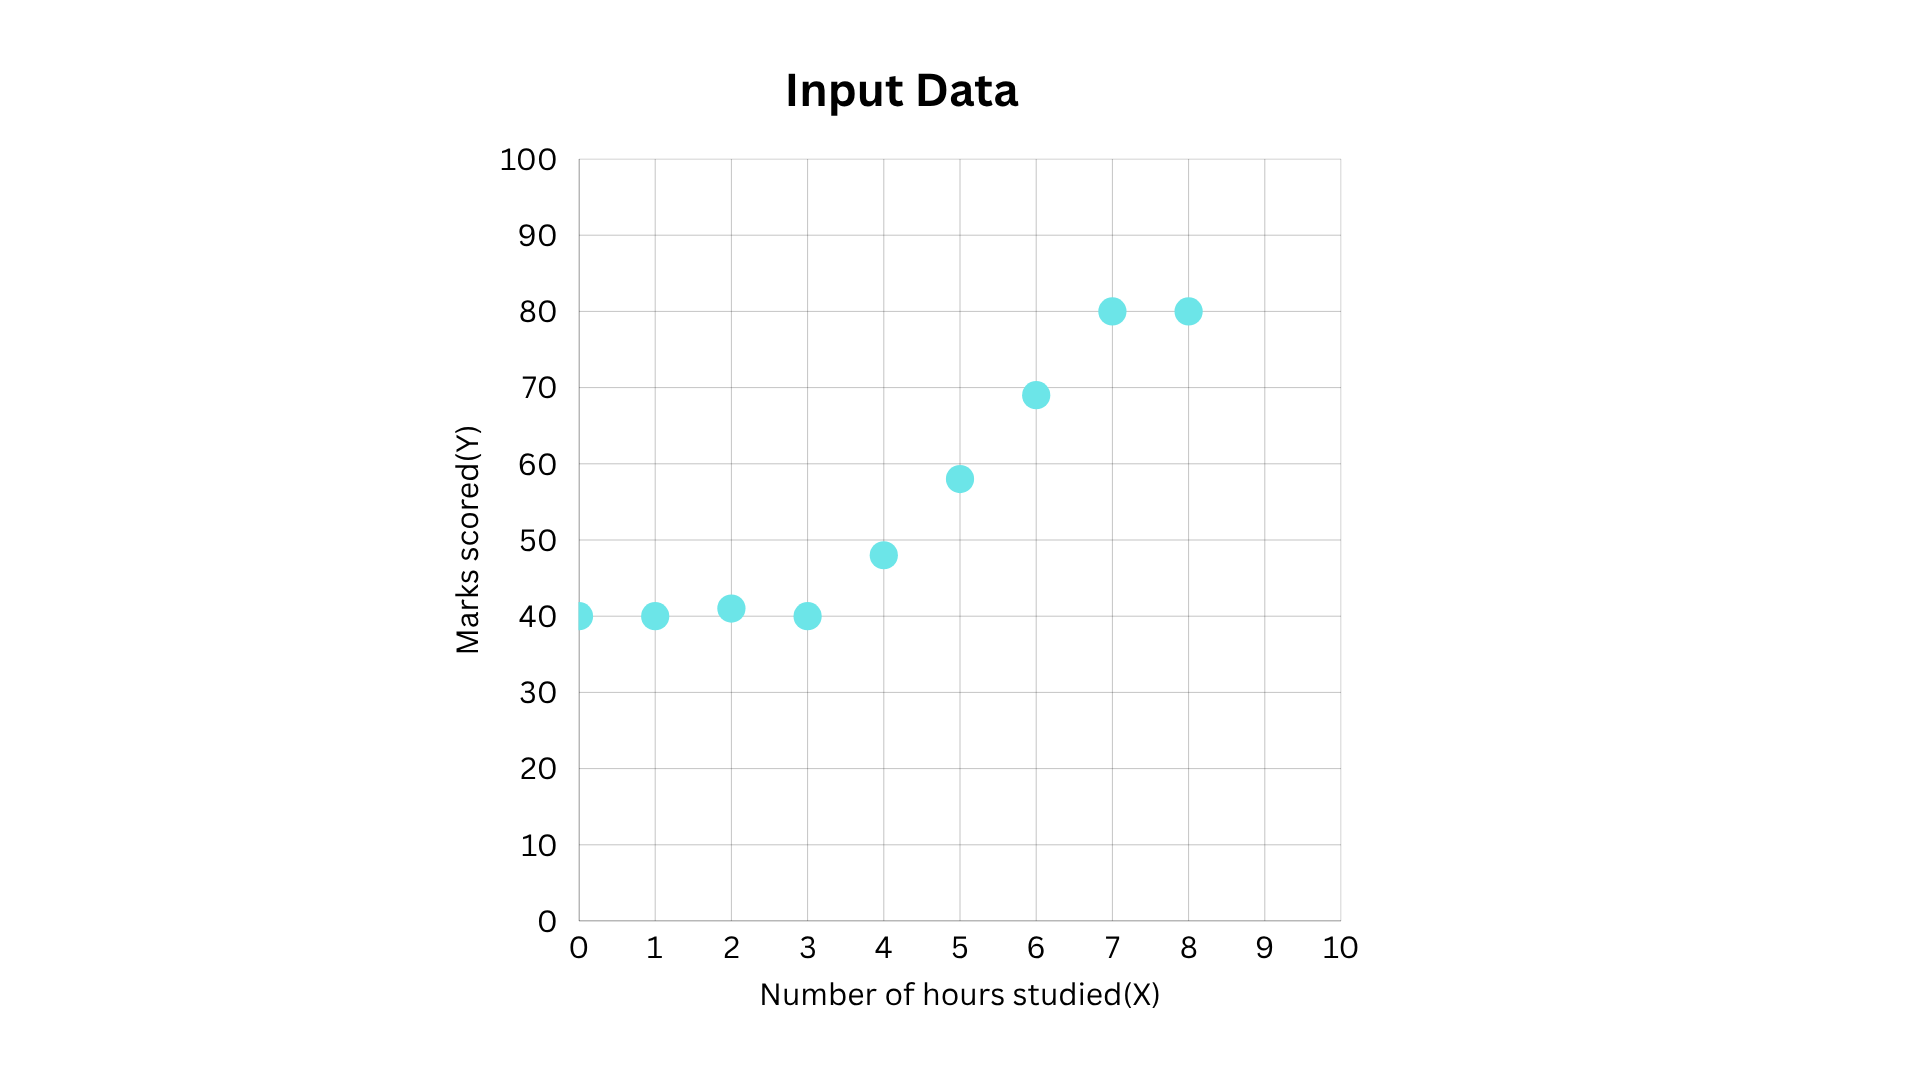
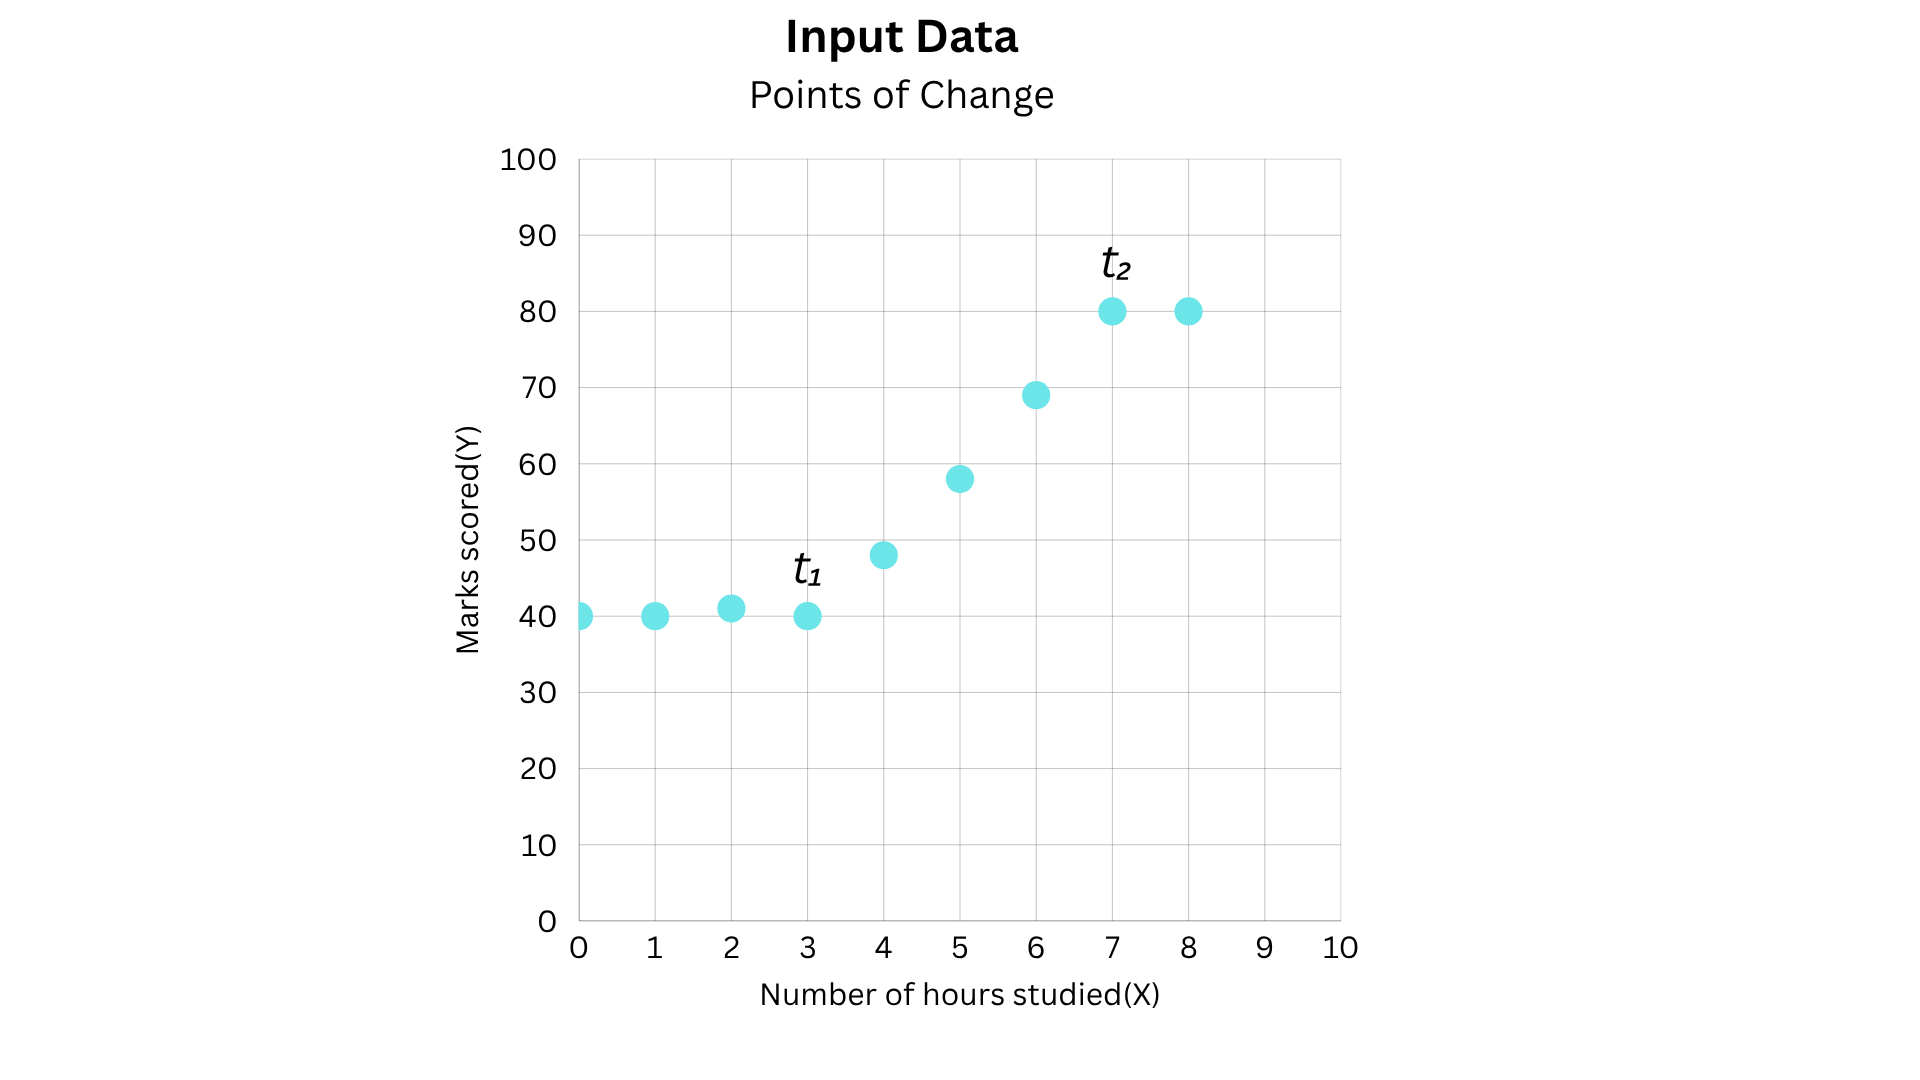
显然,单靠一条直线方程,已经无法刻画每周学习小时数(x)与考试得分(y)之间的关系了。
实际上,这条曲线可以分成三段来看:
Less than t₁ hours: Marks remain constant
t₁ to t₂ hours: Marks increase with study time
More than t₂ hours: Marks remain constant
因此,她可以为每个量程分别写出方程,形式如下:
y = 1st equation, x=t₂
这个例子让我们初窥了非线性问题的面貌:在特定点上,变量之间的关系会发生变化,因此单一直线方程无法胜任,行为需要在不同的点做出改变。
一种简单的处理方式是使用分段线性函数。
分段线性曲线
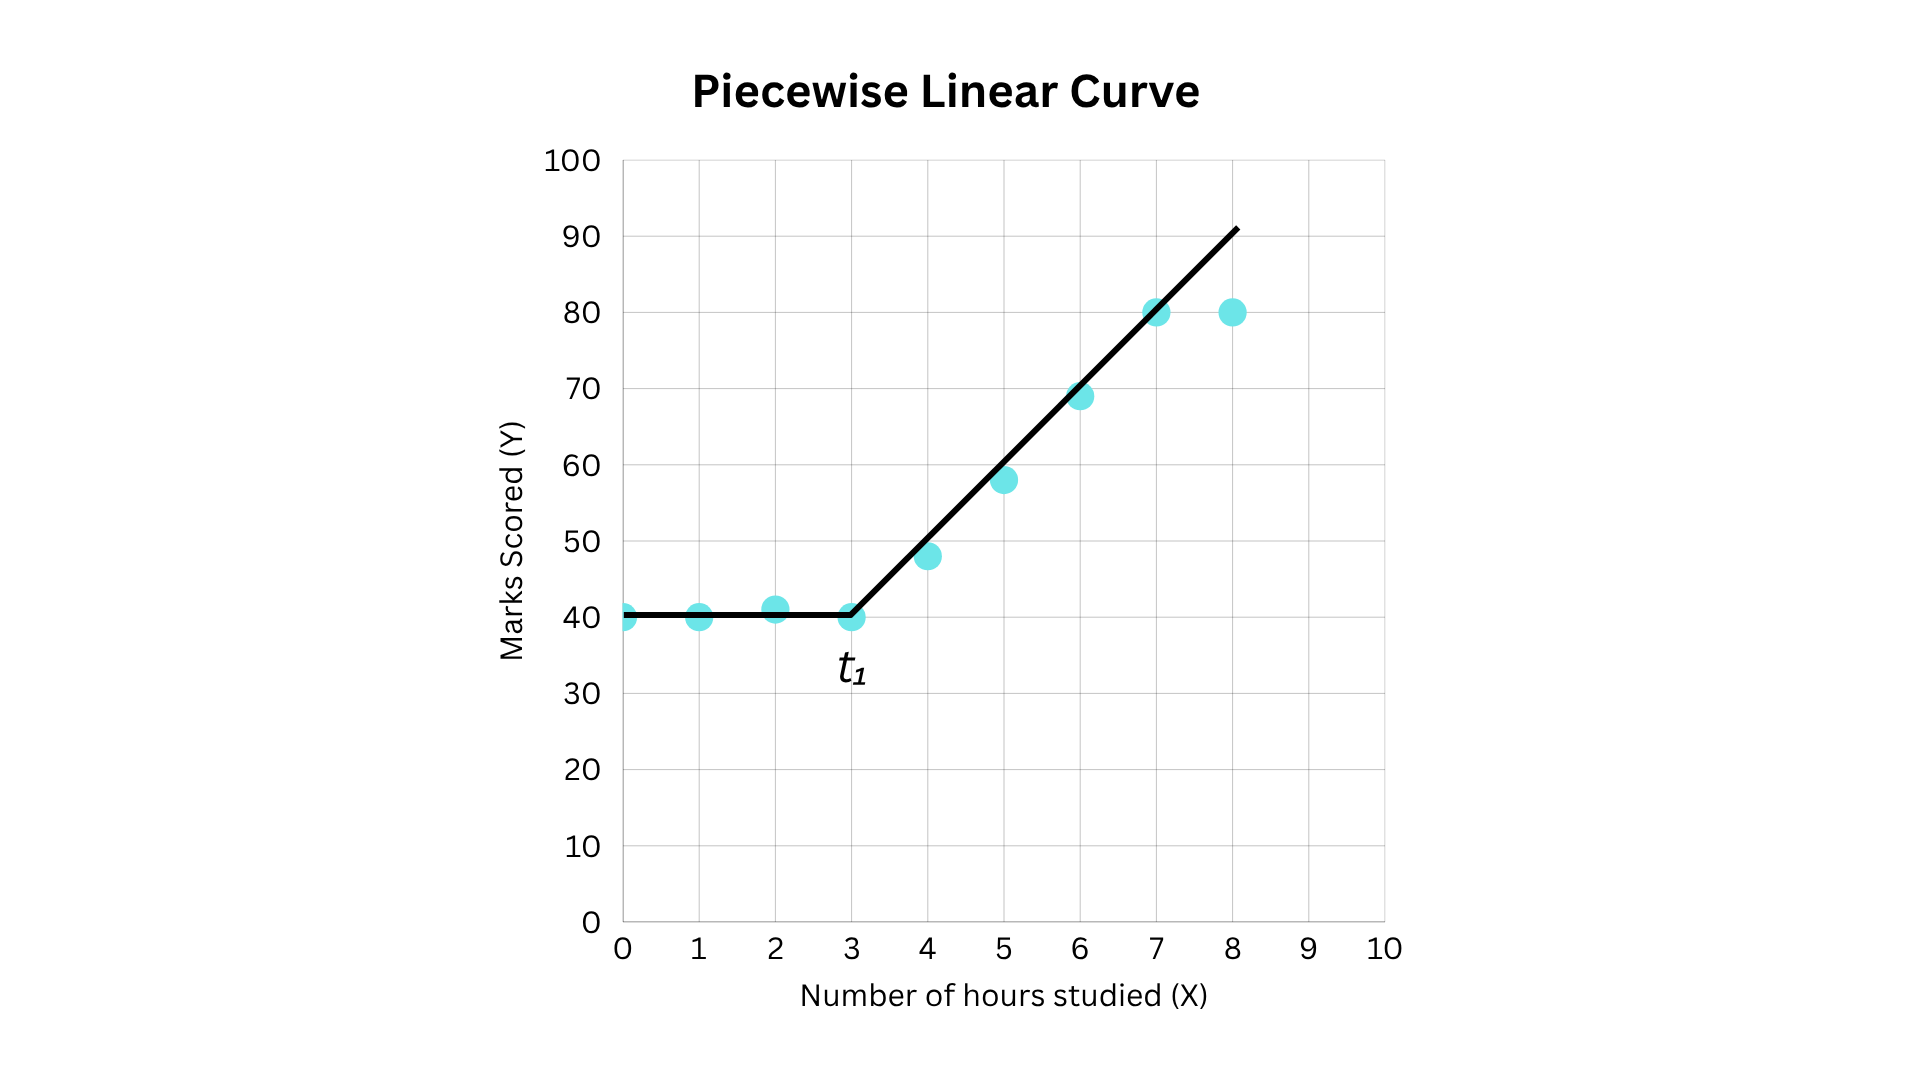
为简单起见,Poly 女士决定先只划分两个区域来考虑。
Region1: Hours of study < t₁
Region2: Hours of study >= t₁
第一段区间的数值基本在某个值附近波动。虽然这些点并不完全落在一条直线上,但她可以近似处理,用一条斜率为 0 的直线来表示这一区间。这说明分数大致保持不变。
第二段区间看起来呈上升趋势,于是她为这段陡峭的上升直线另选了一条直线方程。
最终,Poly 老师为上图写出了两个方程,因为单个方程无法描述整条曲线。规律随区间而变,规则自然也要跟着调整。
于是,她可以这样写:
y = 1st equation, x=t₁
单看每一段,似乎都是直线方程。但组合起来,整体关系就不再是直线了——当 x 越过某个值时,方程会切换成另一条。这叫分段线性函数:针对不同输入区间,采用不同规则的函数。
神经网络里最常用的激活函数之一——ReLU——正是基于这个思路。
什么是 ReLU 函数?
ReLU 全称 Rectified Linear Unit(修正线性单元),数学上写作:
y = ReLU(x) = max(0,x)
它让正数输入保持不变,把负数输入变成零。
这里也一样,单个片段是线性的,但整体函数却是非线性的。所以 ReLU 是一个分段线性函数,却能引入非线性。
下面的图展示了 ReLU 函数:
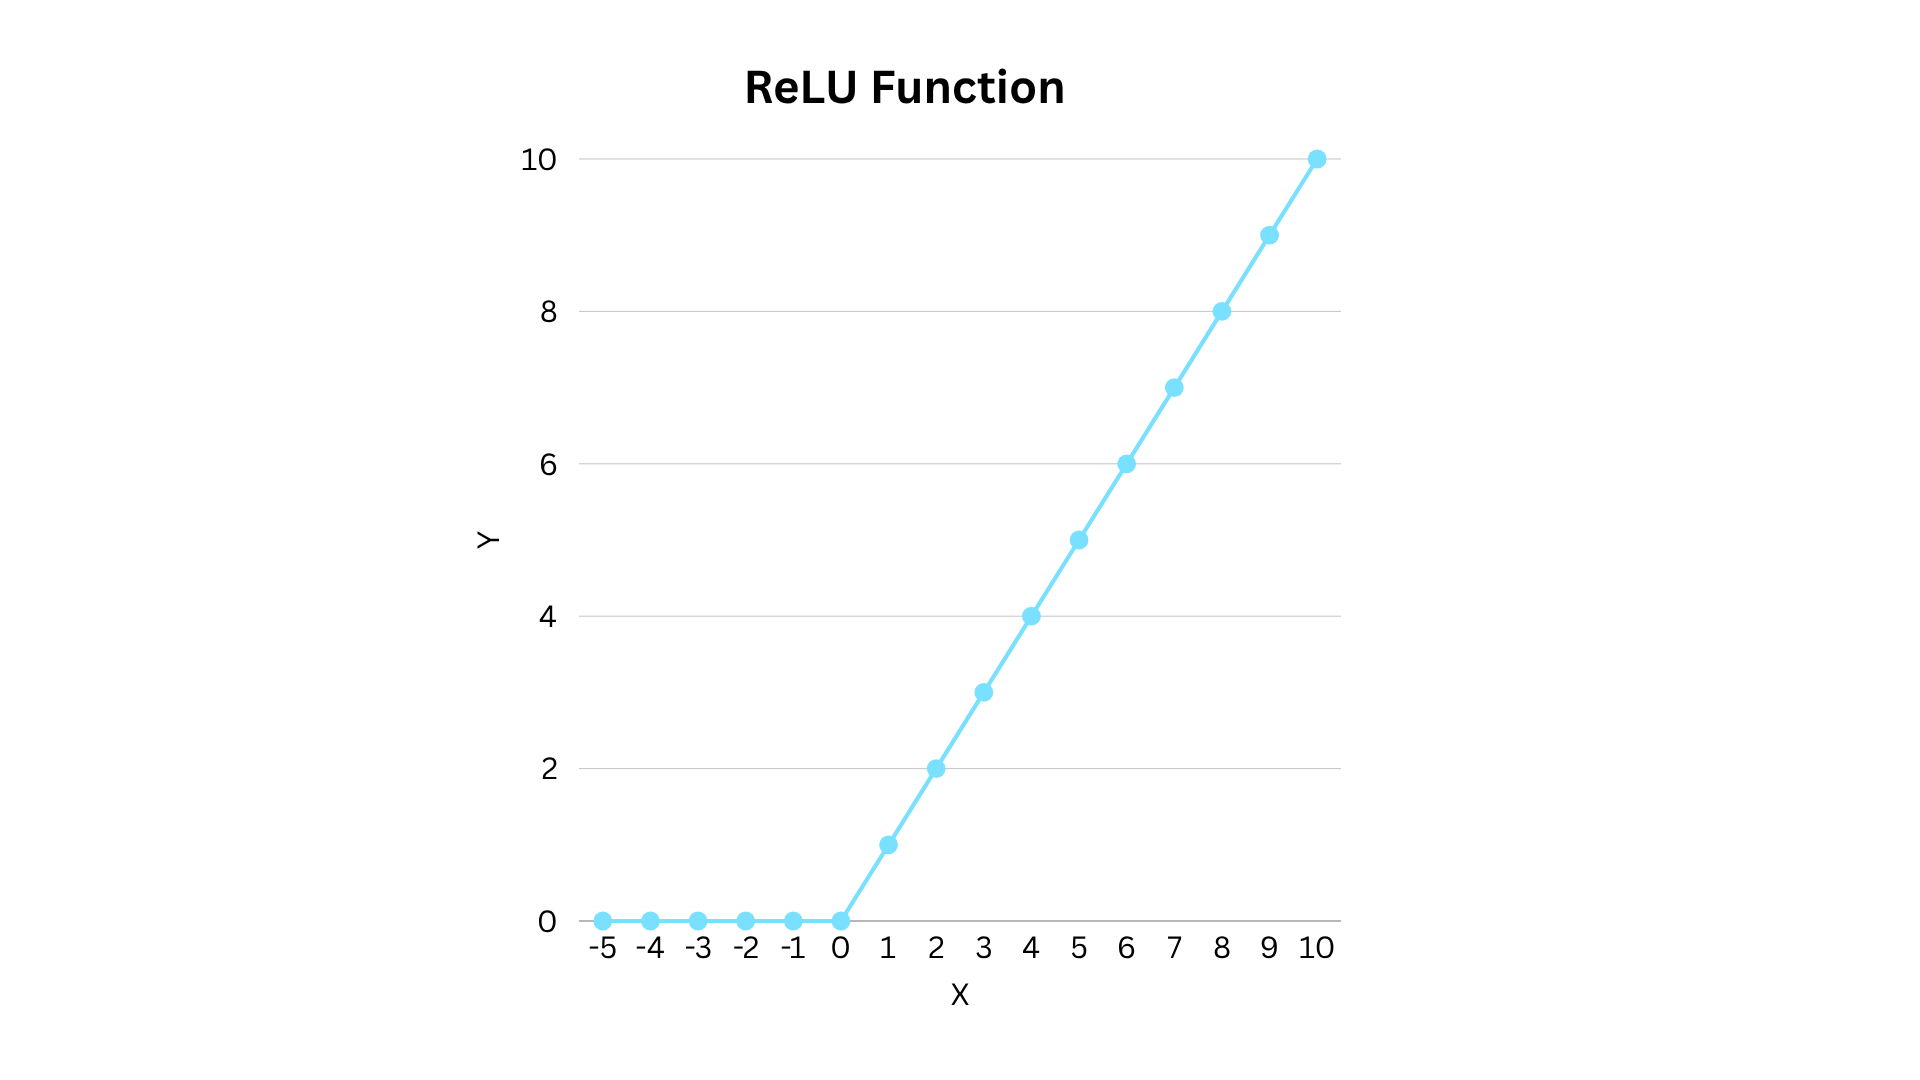
行为上这一简单的改动,让神经元可以对不同范围的输入做出不同反应,使神经网络得以超越单一的直线关系。
S 形曲线
现在,分段线性曲线已经能完成任务,但 Poly 女士注意到,从一个区域过渡到另一个区域时,曲线相当突兀。而且为了简化,她只考虑了两个区域,尽管这个分布其实可以划分成三个区域。
于是,她画出了一条大致穿过所有点的平滑曲线,如下所示:
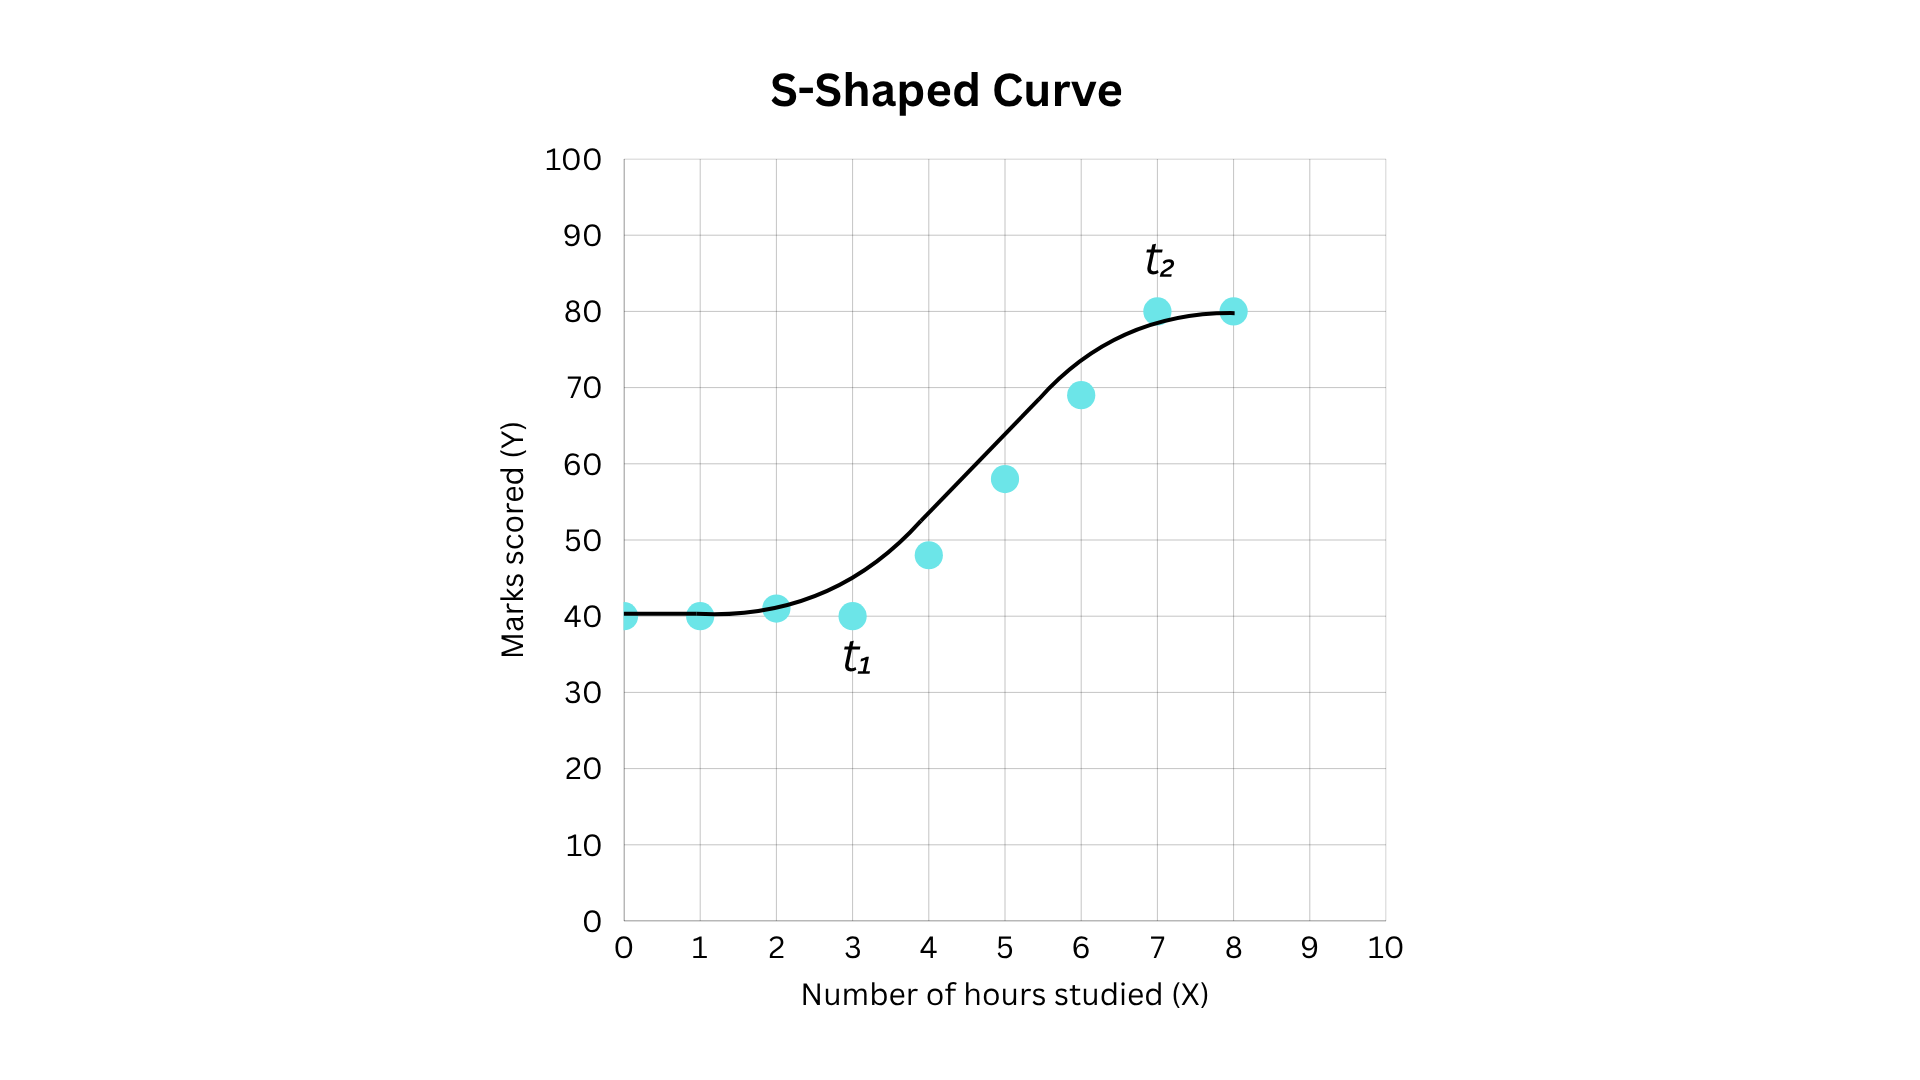
这条曲线表明:当学生学习时长不超过 t₁ 小时时,成绩几乎没有变化;学习时长从 t₁ 增加到 t₂,成绩随之上升,因此这一段有斜率;到了 t₂ 之后,曲线又趋于平缓。这种过渡是渐进且连续的,不同于用直线硬转折的分段线性曲线。
Poly 女士画的这条曲线并非随手涂鸦,它同样可以用数学来表达。sigmoid 函数就是能产生这类形状的函数之一。
什么是 Sigmoid 函数?
Sigmoid 函数是一种数学公式,它接收任意实数输入,将其映射到 0 与 1 之间:先从接近 0 的位置缓慢上升,中段快速攀升,最后逐渐趋平,稳定在接近 1 的位置。
y = σ(x) = 1 / (1 + exp(-x))
下图展示了 sigmoid 函数:
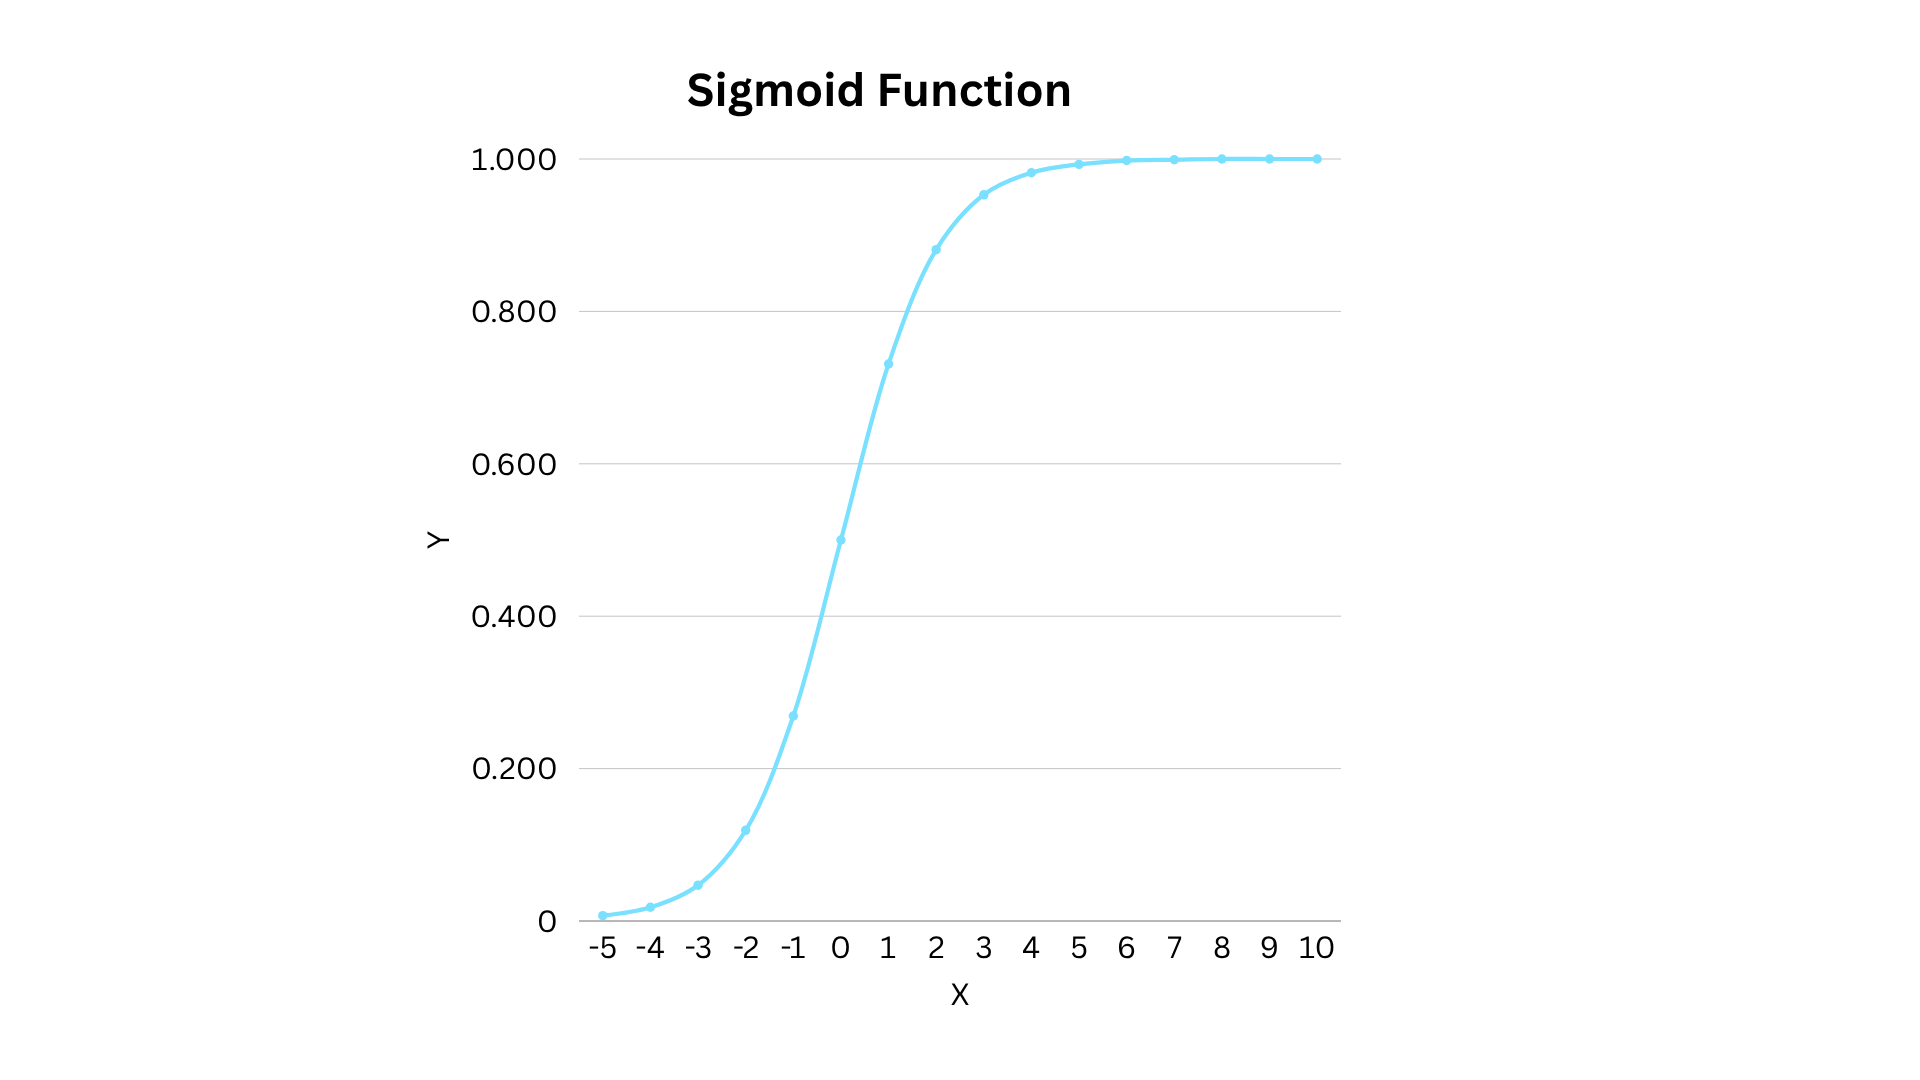
sigmoid 函数在神经网络中非常重要,因为它既引入了非线性,又能把输出限制在 0 到 1 之间。当输出需要表示概率时——比如学生通过考试的可能性——它就派上用场了。sigmoid 输出越高,说明学生通过考试的概率越大,反之亦然。
构建深度神经网络模型
现在,Poly 老师需要把线性方程和非线性方程结合起来,构建一个深度神经网络模型。她要用两种不同的方法,分别:
预测考试得分
预测考试通过与否
她使用了两个非常简单的未训练神经网络,权重和偏差都是手动设定的,目的只是演示计算过程。实际上她并不会自己挑选这些参数,而是让网络在训练过程中学习权重和偏差:反复将预测值与实际值对比,并调整参数,使误差最小化。
用 ReLU 预测得分
第 1 步:搭建网络
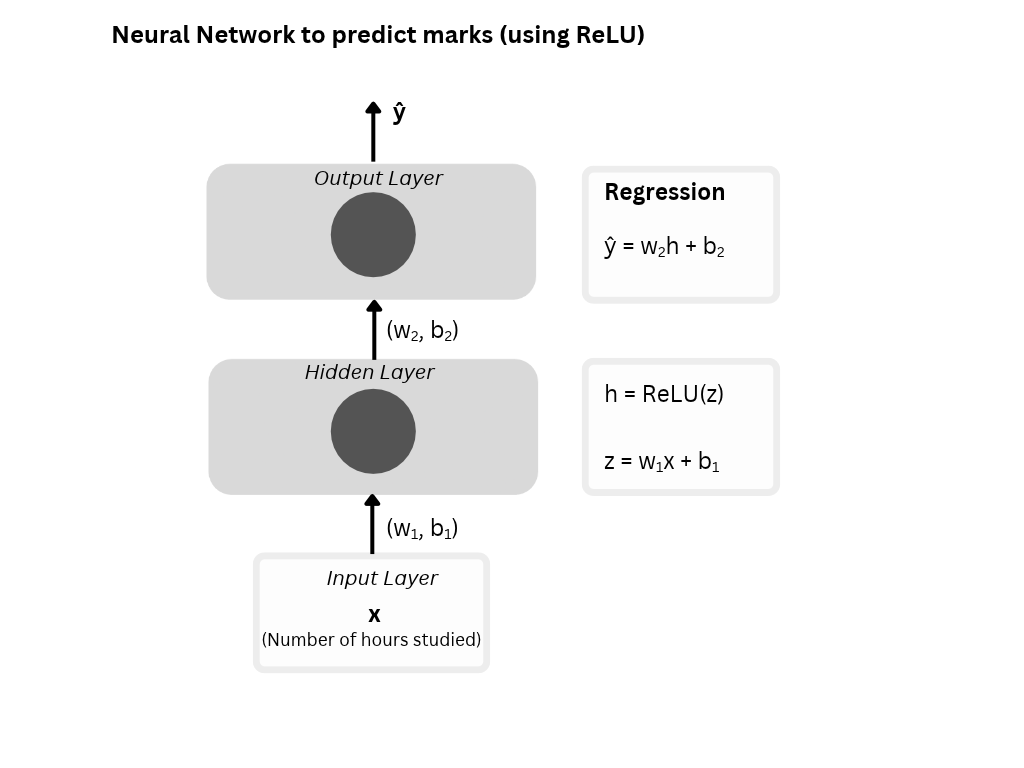
Poly 老师用如下简单方程搭建了这个深度神经网络:
输入层:接收学习时长(x)。
隐藏层:对输入做线性变换,再应用 ReLU。
z = w₁x + b₁, = x - 3      (w₁=1, b₁=-3)
h = ReLU(z) = max(0, z)
输出层:对隐藏层的输出h做线性变换,即可预测出分数。
ŷ = w₂h + b₂ = 10h + 40 (w₂=10, b₂=40)
第 2 步:计算预测分数
假设她想算出学习 5 小时的学生能得多少分,做法如下:
z = w₁x + b₁, = x - 3 = 5 - 3 = 2
h = ReLU(z) = max(0, z) = max(0, 2) = 2
最后计算预测分数:
ŷ = w₂h + b₂ = 10h + 40 = 10(2) + 40 = 60
神经网络预测出 60 分,而数据集中的实际分数是 58 分。
第 3 步:将预测结果与实际分数对比
Poly 老师拿到神经网络预测的全部分数后,将其与实际数据逐一对照,结果如下表:
| 学习时长(小时) | 实际得分 | 预测得分 |
|---|---|---|
| 0 | 40 | 40 |
| 1 | 40 | 40 |
| 2 | 41 | 40 |
| 3 | 40 | 40 |
| 4 | 48 | 50 |
| 5 | 58 | 60 |
| 6 | 69 | 70 |
| 7 | 80 | 80 |
| 8 | 80 | 90 |
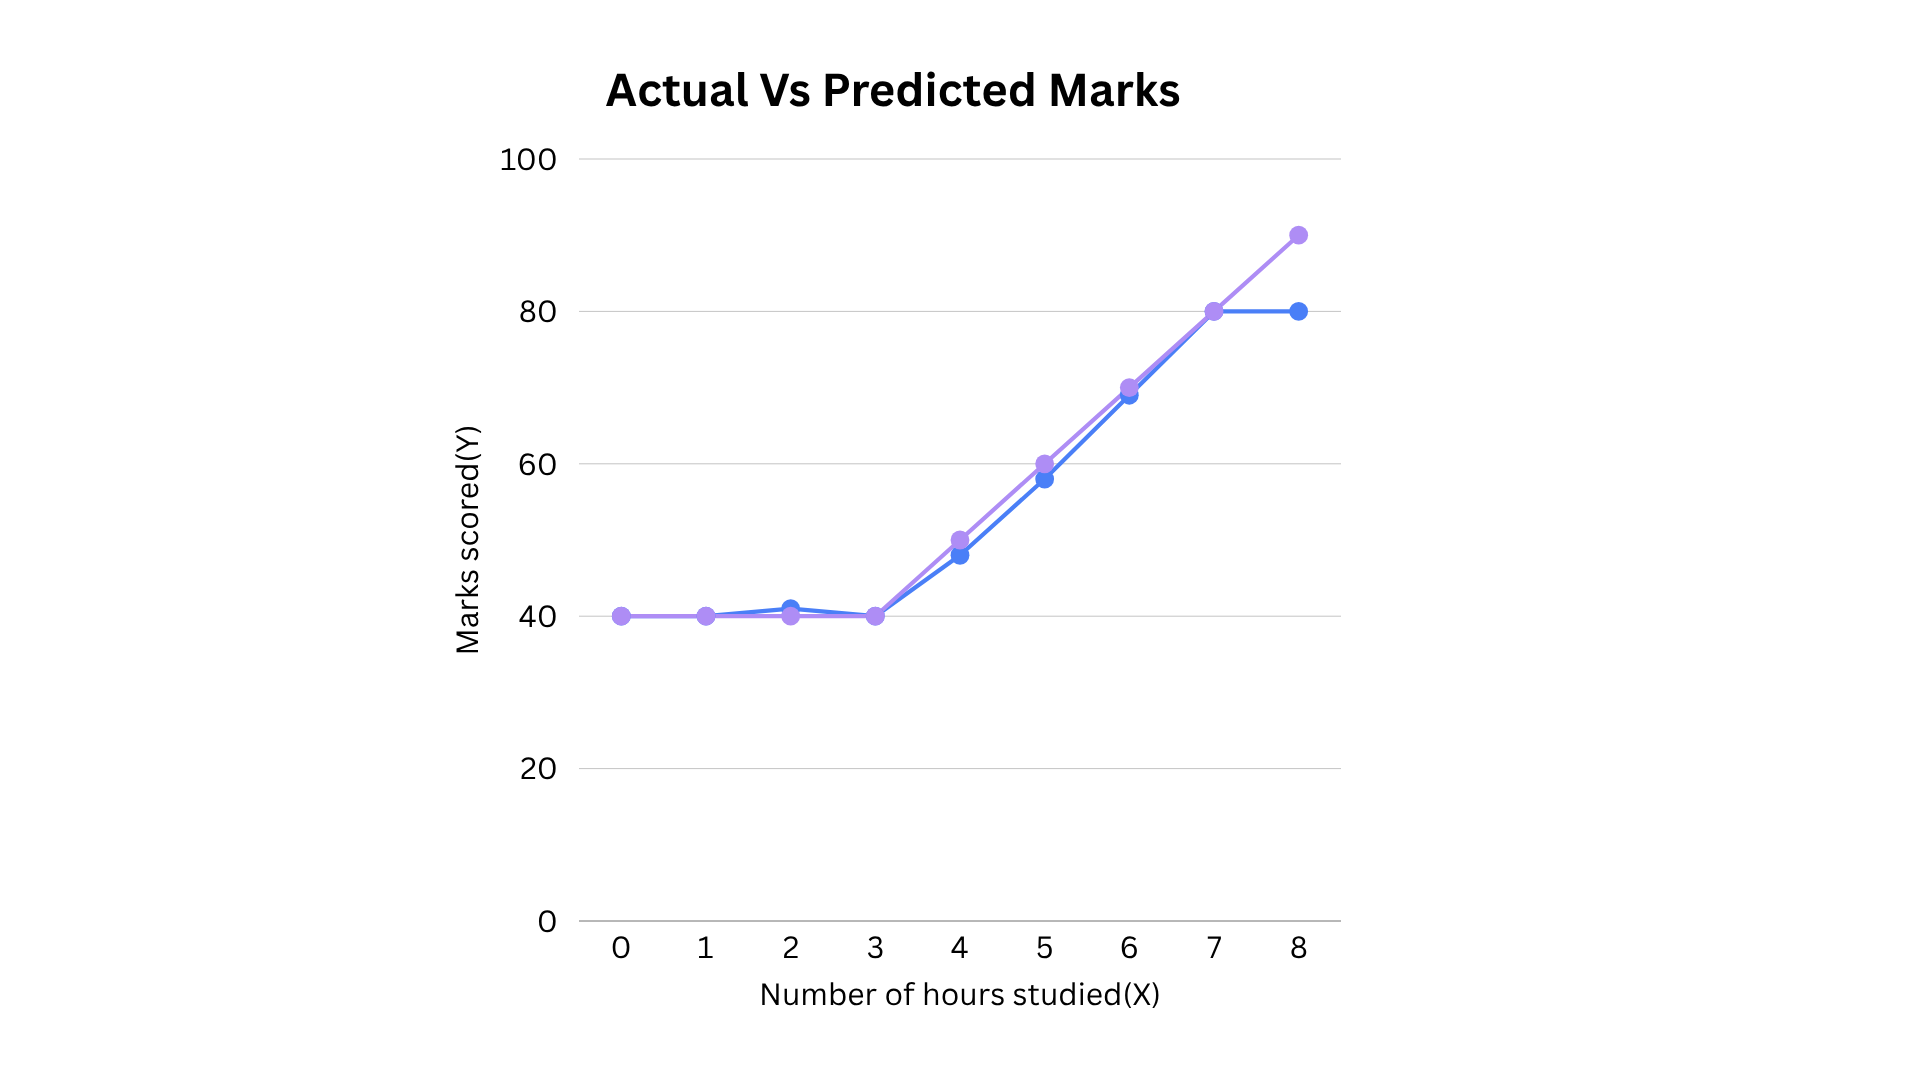
预测分数与实际分数并不完全一致,但已经相当接近。由于数值在超过 ReLU 阈值后会持续增长,分数也一路上升,到最后并没有趋于平缓。
通过这个例子,Poly 老师展示了 ReLU 如何帮助模型捕捉数据中的非线性关系。
用 ReLU 和 Sigmoid 预测考试通过与否
接下来,Poly 老师要用神经网络预测学生期末考试能否通过。她假设学生至少要拿到 50 分才算及格。这个网络将用来预测考试通过的概率。
第 1 步:搭建网络
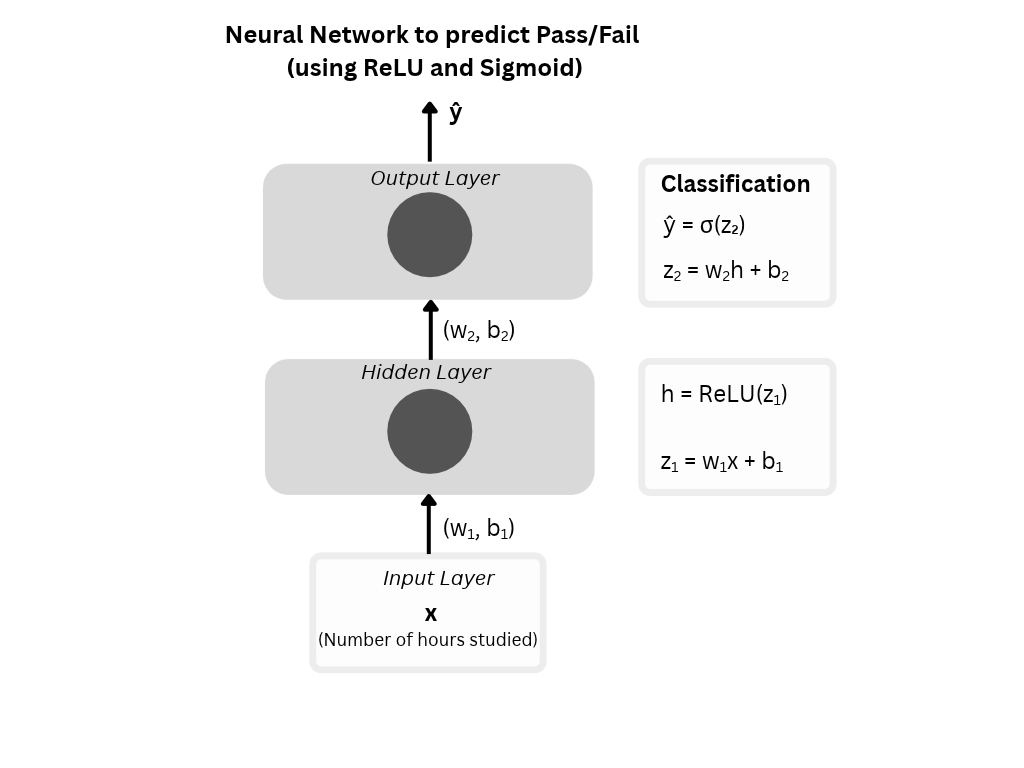
Poly 老师用几个简单的等式搭建了如下深度神经网络:
输入层:接收学习时长(x)。
隐藏层:对输入做线性变换,再套一层 ReLU。
z₁ = w₁x + b₁, = x - 4      (w₁=1, b₁=-4)
h = ReLU(z₁) = max(0, z₁)
输出层:对隐藏层输出(h)做线性变换,再经过 sigmoid 激活,即可预测通过或不通过。
z₂ = w₂h + b₂ = 2h - 1      (w₂=2, b₂=-1)
p = σ(z₂) = 1 / (1 + exp(-z₂))
ŷ = Pass, if p >= 0.5
ŷ = Fail, if p < 0.5
第 2 步:计算通过与否的预测结果
假设她想预测一名学习 3 小时的学生能否通过,做法如下:
z₁ = w₁x + b₁, = x - 4 = 3 - 4 = -1
h = ReLU(z₁) = max(0, z₁) = max(0, -1) = 0
预测学生能否通过考试:
z₂ = w₂h + b₂ = 2h - 1 = 2(0) - 1 = -1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-(-1))) ≈ 0.269
由于 0.269<0.5,这名学生的结果是不及格。
下面看学习 5 小时的学生会得到什么结果:
z₁ = w₁x + b₁, = x - 4 = 5 - 4 = 1
h = ReLU(z₁) = max(0, z₁) = max(0, 1) = 1
预测学生能否通过考试:
z₂ = w₂h + b₂ = 2h - 1 = 2(1) - 1 = 1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-1)) ≈ 0.731
由于0.731>0.5,该学生的结果为通过。
第3步:将预测结果与实际结果对比
| 学习时长(小时) | 考试分数 | 实际结果 | 预测分数 | 预测结果 |
|---|---|---|---|---|
| 0 | 40 | 不及格 | 0.269 | 不及格 |
| 1 | 40 | 不及格 | 0.269 | 不及格 |
| 2 | 41 | 不及格 | 0.269 | 不及格 |
| 3 | 40 | 不及格 | 0.269 | 不及格 |
| 4 | 48 | 不及格 | 0.269 | 不及格 |
| 5 | 58 | 通过 | 0.731 | 通过 |
| 6 | 69 | 通过 | 0.953 | 通过 |
| 7 | 80 | 通过 | 0.993 | 通过 |
| 8 | 80 | 通过 | 0.999 | 通过 |
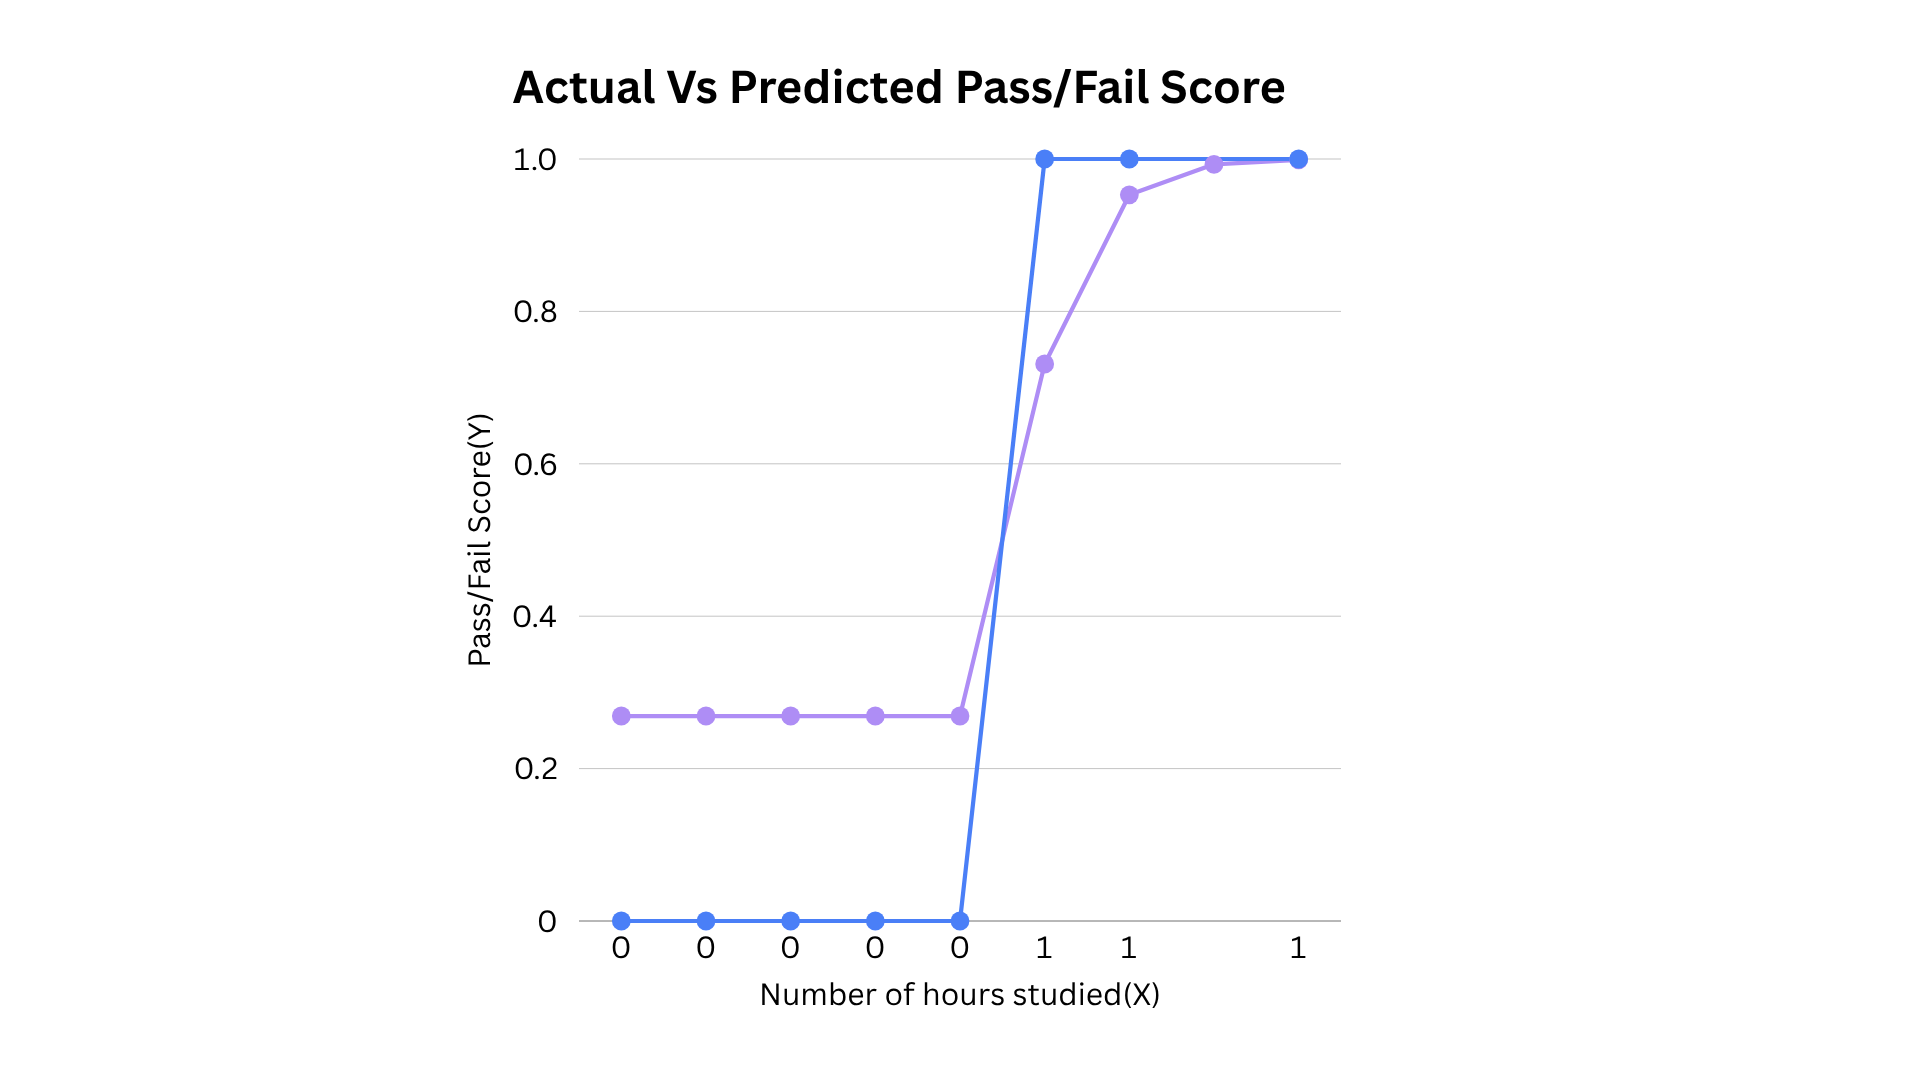
在这个例子中,神经网络正确分类了所有学生的结果。学习时长超过4小时后,预测分数随之上升,通过的可能性也越来越大。
通过这个例子,Poly女士演示了ReLU和sigmoid如何协同工作:ReLU在隐藏层中对输入进行变换,sigmoid则把输出转换成分数,用于预测通过与否。
结语
上面的简单例子揭示了一条关于神经网络的重要规律:输出和输入之间的关系,在输入的不同区间可能表现各异。要处理现实世界的数据并得出有意义的结果,就必须捕捉这种关系。
当数据中的关系简单而一致时,一条直线方程就够用了。但现实中的数据往往没那么简单。通过引入非线性,神经网络得以突破直线关系的局限,学到隐藏在数据中的复杂关系。



