中位数不怕离群值?我实测了它的崩溃点:正好50%
“中位数对离群值稳健,均值会被一个极端值拖飞。”这句话我在课本里背过,面试里说过,code review 里也写过。但写代码这么多年,我从来没亲手验证过两件事:一是均值到底坏得多快,是线性还是别的什么速度;二是大家常说的“中位数能容忍50%的污染”,这个50%到底是约数还是精确的临界值。书上写“不超过一半”,可49%和50%之间差多少,没人给我看过数字。
正好手头有Python环境,statistics模块里fmean和median都是现成的,我决定自己跑一遍,把这条背了无数遍的常识放到具体数字上称一称重量。实验设计不复杂:造1000个服从正态分布、均值100、标准差15的样本,然后往里面掺入值为1000000的离群值,观察两个统计量的误差怎么变化。
这条规则是从哪来的
先说理论背景。崩溃点(breakdown point)是稳健统计里的一个概念,指的是“污染数据到什么比例时,估计量会彻底失效”。均值的崩溃点是0%——理论上只要有一个无穷大的离群值,均值就变成无穷大,所以它对任意小的污染都不免疫。中位数的定义是排序后取中间那个数,只要真实数据还占多数,中间位置的数就永远落在真实数据那一侧,离群值堆在尾部根本够不着它。
顺着这个定义推,中位数能容忍的污染上限应该是50%减去一点:当离群值占比低于一半时,正中间那个位置仍由正常数据把守;一旦占比达到或超过一半,排序后中间位置就落进了离群值堆里,中位数直接“叛变”。这个推理在纸上很漂亮,但50%这个分界线到底多锋利,是从49%到50%渐进恶化,还是一步跳崖,我不记得任何教材给过实测曲线。这就是我想验的点。
按它推算出的预期
动手之前,我先在纸上写了预期。Part 1是往1000个正常样本后面追加k个百万级离群值,不删数据。此时污染比例是k/(1000+k),始终远低于50%,所以中位数应该几乎不动;而均值误差应该和k成正比——每个离群值贡献约(1000000-100)/1000≈999.9的误差,k个就是k倍。
Part 2更狠:我不是追加,而是直接替换,把前k个正常样本换成离群值,污染比例就是k/1000。按理论,30%、40%、49%时中位数都应该还活着,只是随着污染比例逼近一半,排序后中间位置离离群值堆越来越近,误差应该缓慢爬升;到50%那一刻应该发生质变。我预期50%时中位数误差会是一个和离群值同量级的巨大数字。写预期花了五分钟,跑实验也是。
实验验证过程
代码如下,固定seed保证可复现,全部用标准库:
import random
import statistics

random.seed(42)
CENTER = 100.0
OUTLIER = 1000000.0
base = [random.gauss(CENTER, 15) for _ in range(1000)]

print("Part 1: add k huge outliers, mean error should scale with k")
print(f"{'k':>4} {'mean_err':>12} {'median_err':>12}")
for k in (0, 1, 5, 10):
    data = base + [OUTLIER] * k
    m_err = abs(statistics.fmean(data) - CENTER)
    d_err = abs(statistics.median(data) - CENTER)
    print(f"{k:>4} {m_err:>12.2f} {d_err:>12.2f}")

print()
print("Part 2: replace a fraction of samples with outliers")
print(f"{'pct':>4} {'mean_err':>12} {'median_err':>12}")
for pct in (30, 40, 49, 50, 51):
    k = len(base) * pct // 100
    data = base[:]
    data[:k] = [OUTLIER] * k
    m_err = abs(statistics.fmean(data) - CENTER)
    d_err = abs(statistics.median(data) - CENTER)
    print(f"{pct:>4} {m_err:>12.1f} {d_err:>12.1f}")
运行结果如下:
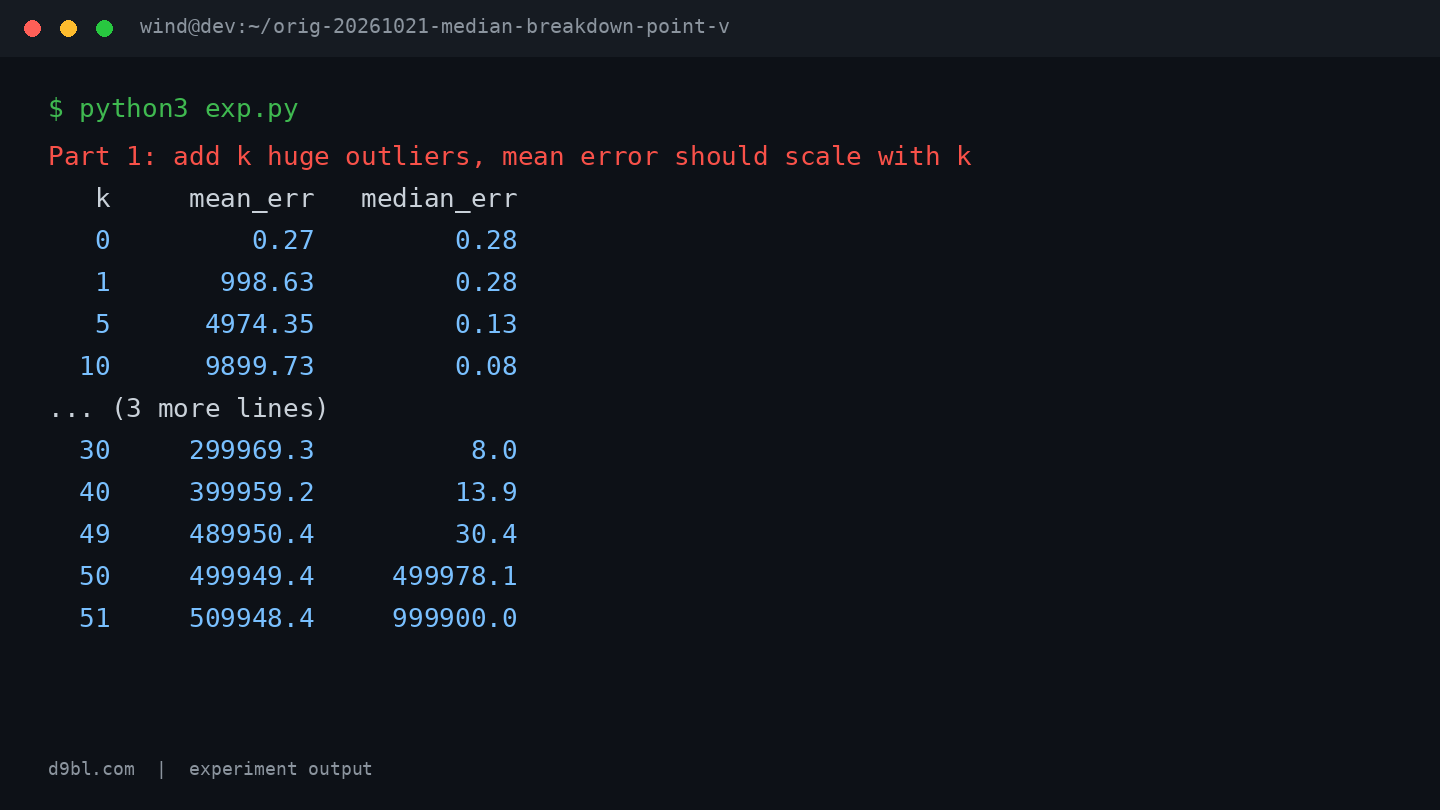
Part 1里,k=0时两个误差都在0.3以内,这是抽样噪声的本底。加入1个离群值后,均值误差从0.27跳到998.63——一个离群值就把均值拖出去近一千,而中位数误差还是0.28,纹丝不动。k=5时均值误差4974.35,k=10时9899.73,每加一个离群值误差精确地多999多一点,和纸上推算的999.9严丝合缝。
数据与理论对上没有
Part 1完全对上了理论:均值误差随k线性放大,1个离群值998.63,10个就是9899.73,几乎是十倍关系,斜率就是“离群值到中心的距离除以样本量”。这验证了均值崩溃点为0%——它对污染没有任何抵抗力,哪怕污染比例只有千分之一。
Part 2的曲线更有意思。污染30%时中位数误差8.0,40%时13.9,49%时30.4——在增长,但都还在正常数据的标准差两倍以内,可以认为“活着”。50%那一行,中位数误差直接从30.4跳到499978.1,四个数量级的跳变;51%时进一步到999900.0,几乎等于离群值本身减去中心值。理论说的“崩溃点恰为50%”不是约数,是一道墙:49%还在墙这边,50%已经在墙那边了。均值这边倒是全程惨不忍睹,30%污染时误差299969.3,基本被离群值统治。
边界在哪
这个实验有明显的局限,我得老实说。第一,我用的离群值是单一固定值1000000,现实中的脏数据是连续分布的尾巴,不会这么整齐;第二,1000个样本里我只测了整数百分比,49%到50%之间(比如49.5%)到底发生什么,这个粒度看不到,只确认了分界在50%附近而不是渐进恶化;第三,替换是替换最前面的k个,对排序后的位置结构有特定影响,换成随机位置理论上结论一致,但我没跑那个版本。还有一个反直觉的小发现:49%污染时中位数误差30.4,已经超过了3个标准差——在崩溃之前,中位数也会被大幅污染“顶”得偏离中心,只是幅度温和,稳健不等于精确。
落到实操上,我现在的做法是:拿不准数据干不干净的时候,均值和中位数一起算。如果两者差距巨大,说明数据里有重尾或者脏数据,这时候中位数是更可信的中心估计——只要污染不过半。反过来,如果你手里数据的中位数和均值已经贴近,也未必说明数据干净,只能说离群值没过半。这个50%的崩溃点是中位数的最后防线,不是质量证明。下次你在监控里看到一个指标的均值突然飘了,别急着调阈值,先看看它的中位数动没动——没动,大概率是离群值在捣乱;动了,那才是真的出事了。



