很多 AI Agent 教程的做法都是:先找个大模型,给它配几个工具,然后跑个循环直到它给出答案。这足以演示工具调用,但真正有意思的工程问题却没涉及。
工具执行失败了怎么办?参数由谁来校验?如何防止 Agent 无限运行、执行危险命令,或者把上下文窗口撑爆?如果不依赖模型那些不可预测的响应,这些又该怎么测试?
这些问题都属于Agent 框架(agent harness)的职责范围——它是介于大模型和运行环境之间的那层软件。
在本教程中,我们将用 TypeScript 构建一个小巧且不绑定特定供应商的 harness,并以编程 Agent 为例进行讲解。我们会从一个基础的执行循环开始,逐步加入工具校验、工作区隔离、执行预算、上下文管理、可观测性以及确定性的故障测试。
内容一览
前置条件
熟悉 TypeScript、了解 AI Agent 的基本概念会对你很有帮助。本文使用 Node.js 24 和 TypeScript 及其内置测试运行器,依赖极少。
完整实现已在配套仓库中开源:agent-harness-from-scratch。每个章节都对应一个 Git 标签,你可以跟随项目的演进逐步阅读,而不必一开始就面对最终代码。
1. 搭建基本的 Agent 循环
要跟着动手实践,请先检出初始里程碑:
git clone https://github.com/gkoos/agent-harness-from-scratch.git
cd agent-harness-from-scratch
git switch --detach 01-model-loop
npm ci
npm run typecheck
npm test
npm run demo
分离检出(detached checkout)会把你带到本文讨论的确切代码快照,且不会移动任何分支。进入下一节时,切换到对应的 tag 即可。你需要安装 Node.js 24 和 npm。
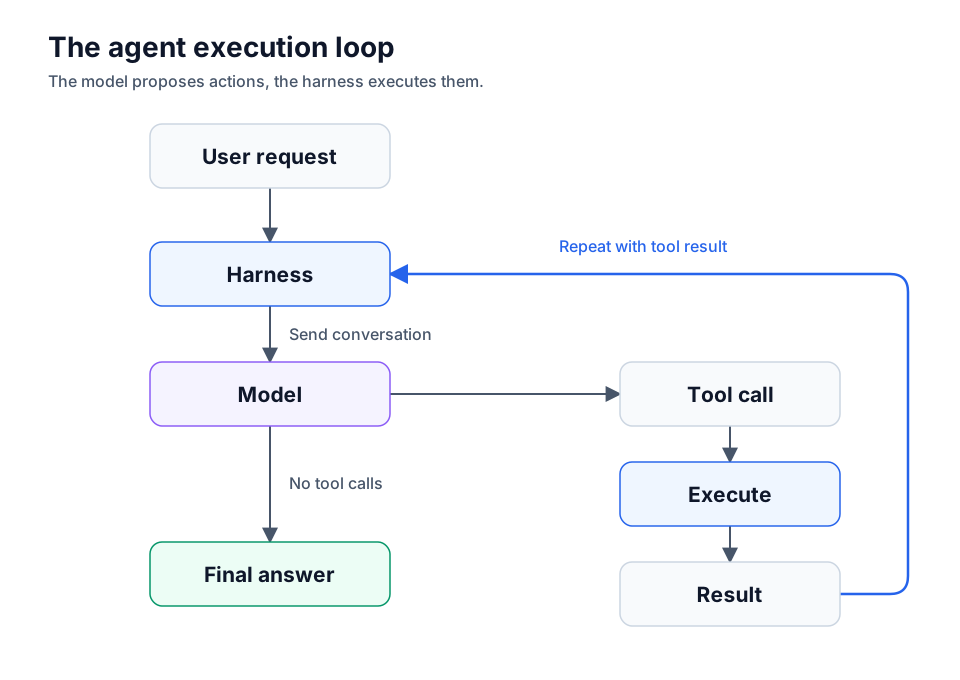
最重要的架构决策是:模型只负责提出动作,由 harness 负责执行。当模型请求调用工具时,实际上什么都没执行——它只是生成了一份包含工具名称和参数的结构化请求。harness 需要解析这份请求,调用对应的实现,再把结果返回给模型。
整个交互过程如下:
我们先在src/core/types.ts中定义相关契约。
export type ToolCall = { id: string; name: string; arguments: unknown };

export type Message =
  | { role: 'user'; content: string }
  | { role: 'assistant'; content: string; toolCalls?: ToolCall[] }
  | { role: 'tool'; callId: string; content: string; isError: boolean };

export interface ToolDefinition {
  name: string;
  description: string;
  parameters: Record; // JSON Schema for the model
}

export interface Tool extends ToolDefinition {
  execute(argumentsValue: unknown, signal: AbortSignal): Promise;
}

export interface Model {
  generate(input: {
    messages: readonly Message[];
    tools: readonly ToolDefinition[];
    signal: AbortSignal;
  }): Promise<{ content: string; toolCalls?: ToolCall[] }>;
}

export type AgentResult = {
  status: 'completed' | 'step_limit' | 'aborted';
  answer?: string;
  messages: Message[];
  steps: number;
};
Model接口刻意保持中立,不包含任何针对OpenAI、Anthropic或其他厂商的内容。各厂商的适配器只需在自己的API与这些类型之间做转换,无需改动harness本身。
注意工具参数的类型是unknown而不是any。模型生成的数据属于不可信输入,我们会在下一节执行前先做校验。
src/core/agent.ts中的Agent循环遵循一个简单的流程:
把对话历史和可用的工具定义发给模型。
把模型的响应追加到对话中。
如果模型请求调用工具,就执行这些工具,并把结果追加进去。
不断重复,直到模型给出最终答案,或达到harness的步数上限。
下面是src/core/agent.ts中初始循环的完整代码。工具定义交给模型,而可执行的实现由harness保留在本地:
import type { AgentResult, Message, Model, Tool } from './types.ts';

export async function runAgent(options: {
  model: Model;
  tools: readonly Tool[];
  prompt: string;
  maxSteps?: number;
  signal?: AbortSignal;
}): Promise {
  const { model, tools, prompt, maxSteps = 10 } = options;
  if (!Number.isSafeInteger(maxSteps) || maxSteps < 1) {
    throw new RangeError('maxSteps must be a positive safe integer');
  }
  const signal = options.signal ?? new AbortController().signal;
  const messages: Message[] = [{ role: 'user', content: prompt }];
  const registry = new Map(tools.map(tool => [tool.name, tool]));
  if (registry.size !== tools.length) throw new Error('Duplicate tool names');
  const definitions = tools.map(({ name, description, parameters }) => ({ name, description, parameters }));

  for (let step = 0; step < maxSteps; step++) {
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    let response;
    try {
      response = await model.generate({ messages: [...messages], tools: definitions, signal });
    } catch (error) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step };
      throw error;
    }
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    const calls = response.toolCalls ?? [];
    messages.push({ role: 'assistant', content: response.content, ...(calls.length ? { toolCalls: calls } : {}) });
    if (!calls.length) return { status: 'completed', answer: response.content, messages, steps: step + 1 };

    for (const call of calls) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
      const tool = registry.get(call.name);
      if (!tool) {
        messages.push({ role: 'tool', callId: call.id, content: `Unknown tool: ${call.name}`, isError: true });
        continue;
      }
      try {
        const result = await tool.execute(call.arguments, signal);
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({ role: 'tool', callId: call.id, content: JSON.stringify(result) ?? 'null', isError: false });
      } catch (error) {
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({
          role: 'tool', callId: call.id,
          content: error instanceof Error ? error.message : String(error),
          isError: true
        });
      }
    }
  }
  return { status: 'step_limit', messages, steps: maxSteps };
}
没有工具调用的响应会结束本次运行;否则,harness 会查找每个被请求的工具并执行它。
工具执行失败并不会自动终止 agent。harness 会记录一条错误消息,并关联到原始调用的 ID,让模型在下一轮针对缺失的文件或失败的操作做出反应。
我们还限制了模型的最大轮数。模型可以不断请求继续工作,但它无权决定自己能占用多少执行时间或迭代次数。
不用真实模型做测试
测试中不必发起不确定的 API 调用(还能省下 token 和 GPU 算力),我们在 src/models/fake.ts 里引入了一个按脚本运行的假模型。它返回预先定义好的响应:第一次返回工具请求,之后返回最终答案。
假模型会依次遍历响应数组。脚本耗尽即视为错误,因此模型多出来的意外轮次不会悄无声息地通过测试:
// src/models/fake.ts
import type { Model } from '../core/types.ts';

export function scriptedModel(
  responses: Array>>
): Model {
  let index = 0;
  return {
    async generate() {
      const response = responses[index++];
      if (!response) throw new Error('Scripted model exhausted');
      return response;
    }
  };
}
下面是tests/agent.test.ts的一个最小测试示例,用npm test即可运行:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';

test('executes a tool and returns the final answer', async () => {
  const result = await runAgent({
    prompt: 'Say hello',
    tools: [{
      name: 'hello', description: 'Return a greeting',
      parameters: { type: 'object' },
      async execute() { return 'Hello'; }
    }],
    model: scriptedModel([
      { content: '', toolCalls: [{ id: '1', name: 'hello', arguments: {} }] },
      { content: 'Done' }
    ])
  });
  assert.equal(result.status, 'completed');
  assert.equal(result.answer, 'Done');
  assert.deepEqual(result.messages[2], {
    role: 'tool', callId: '1', content: '"Hello"', isError: false
  });
});
配套示例也采用同样的模式。另外还有一些测试,覆盖了未知工具、步数上限和取消操作等场景,而且不需要 API 密钥、不用联网,也不消耗 token。
到这里,我们已经有了一个能跑起来的 Agent 循环,但它仍然完全信任模型生成的工具参数,对已注册工具能做什么也没有任何实质性限制。
2. 在执行前校验工具调用
在第一版循环里,模型可以按名称请求某个工具,其参数则被直接传给具体实现。演示没问题,但工具描述对模型来说只是一份请求,并不能保证模型返回的参数一定合法。
本节内容请参考配套仓库的第二个里程碑:
git switch --detach 02-tool-dispatch
这个标签新增了src/core/registry.ts,负责工具注册和运行时参数校验,同时改变了src/core/agent.ts中的失败处理逻辑。
带显式契约的注册表
ToolRegistry取代了最初循环里直接使用的Map。它会拒绝无效或重复的工具名,只向大模型暴露所需的定义:
import type { Tool, ToolDefinition } from './types.ts';

export class ToolRegistry {
  private readonly tools = new Map();
  constructor(tools: readonly Tool[]) {
    for (const tool of tools) {
      if (!/^[a-zA-Z][a-zA-Z0-9_-]*$/.test(tool.name)) throw new Error(`Invalid tool name: ${tool.name}`);
      if (this.tools.has(tool.name)) throw new Error(`Duplicate tool name: ${tool.name}`);
      this.tools.set(tool.name, tool);
    }
  }
  definitions(): ToolDefinition[] {
    return [...this.tools.values()].map(({ name, description, parameters }) => ({ name, description, parameters }));
  }
  get(name: string): Tool | undefined { return this.tools.get(name); }
}
用const registry = new ToolRegistry(tools)创建注册表,再通过registry.definitions()获取面向模型的工具定义。当响应中请求调用某个工具时,务必在执行execute之前校验传入的参数:
const tool = registry.get(call.name);
if (!tool) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `Unknown tool: ${call.name}`, isError: true
  });
  continue;
}

const validationErrors = validate(call.arguments, tool.parameters);
if (validationErrors.length) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `Invalid arguments: ${validationErrors.join('; ')}`,
    isError: true
  });
  continue;
}
这是一条关键边界。arguments: unknown在 harness 校验之前始终是不可信的。一旦校验失败,工具就永远不会执行,模型只会收到一条错误结果,并关联到它最初那次调用的 ID。
教程里的validate函数刻意只支持一小部分 JSON Schema 子集:基本类型和容器类型的type检查、对象的properties、required字段、additionalProperties: false、数组的items以及enum。它会报告诸如$.flags[0]这样的路径,方便定位格式错误的输入。这不是完整的 JSON Schema 实现,也不会在注册工具时校验工具 schema。
下面就是前文用到的校验器。它先检查声明的类型,然后递归检查对象属性和数组元素:
export function validate(value: unknown, schema: Record, path = '$'): string[] {
  const errors: string[] = [];
  const type = schema.type;
  if (typeof type !== 'string') return [`${path}: schema must declare a type`];
  const matches = type === 'object' ? value !== null && typeof value === 'object' && !Array.isArray(value)
    : type === 'array' ? Array.isArray(value)
    : type === 'integer' ? typeof value === 'number' && Number.isInteger(value)
    : type === 'number' ? typeof value === 'number' && Number.isFinite(value)
    : type === 'null' ? value === null
    : type === 'string' || type === 'boolean' ? typeof value === type : false;
  if (!matches) return [`${path}: expected ${type}`];
  if (Array.isArray(schema.enum) && !schema.enum.some(item => Object.is(item, value))) {
    errors.push(`${path}: not an allowed value`);
  }
  if (type === 'object') {
    const obj = value as Record;
    const properties = (schema.properties ?? {}) as Record>;
    for (const key of (schema.required ?? []) as string[]) {
      if (!Object.hasOwn(obj, key)) errors.push(`${path}.${key}: required`);
    }
    for (const [key, item] of Object.entries(obj)) {
      if (Object.hasOwn(properties, key)) errors.push(...validate(item, properties[key]!, `${path}.${key}`));
      else if (schema.additionalProperties === false) errors.push(`${path}.${key}: unexpected property`);
    }
  }
  if (type === 'array' && schema.items && typeof schema.items === 'object') {
    (value as unknown[]).forEach((item, index) => {
      errors.push(...validate(
        item, schema.items as Record, `${path}[${index}]`
      ));
    });
  }
  return errors;
}
并非所有错误都意味着同一件事
Milestone 2 还区分了工具失败和模型失败这两种不同情况。
如果工具不存在、参数无效或工具抛出异常,就会产生一条带有isError: true的role: 'tool'消息。模型可以查看这个结果,并在下一轮尝试其他方案。相比之下,如果model.generate()本身抛出异常,测试框架会以status: 'model_error'终止,并记录错误信息。
在循环中现有的model.generate()catch块里,把重新抛出改为返回结构化结果,并在AgentResult中新增'model_error'和可选的error?: string字段:
if (signal.aborted) return { status: 'aborted', messages, steps: step };
return {
  status: 'model_error', messages, steps: step,
  error: error instanceof Error ? error.message : String(error)
};
工具执行的catch块仍然会记录错误信息,然后继续循环。
确定性测试把这种区别落到了实处。在tests/agent.test.ts中,无效的echo参数不会触发工具调用就被直接拒绝;而工具抛出异常时,脚本化的模型仍能返回最终答案。tests/registry.test.ts则检查嵌套参数校验以及意外属性的处理。
3. 给Agent工具,但不给它整台机器
到目前为止,我们的Agent已经能请求工具,harness也会校验参数。但校验只能确认请求格式正确——一条读取../../secrets.txt的合法请求,依然是我们应该拒绝的请求。
欢迎查看配套仓库中的里程碑3:
git switch --detach 03-workspace-tools
这个里程碑新增了工作区文件工具和受限命令工具,两者都不依赖特定的模型提供商。
将文件操作限制在工作区内
编程 Agent 需要读写和编辑文件,但不应该自动获得整个文件系统的访问权限。Workspace 类在创建时会解析出一个规范根目录:
const workspace = await Workspace.open('/path/to/project');
const tools = workspaceTools(workspace);
由此得到的read_file和write_file工具接受相对于该根目录的路径。打开文件之前,Workspace会拒绝绝对路径、逃出根目录的路径,以及路径中已有目录层级里的符号链接。写入操作要求父目录已存在,该工具不会随意创建目录树。
Workspace内部的这两个方法负责执行路径检查。文件从node:path导入了isAbsolute、relative和resolve,又从node:fs/promises导入了lstat和realpath。Workspace.open()会把await realpath(root)的结果存到this.root里:
private lexical(path: string): string {
    if (!path || isAbsolute(path)) throw new Error('Expected a relative workspace path');
    const full = resolve(this.root, path);
    const rel = relative(this.root, full);
    if (!rel || rel === '..' || rel.startsWith(`..${process.platform === 'win32' ? '\\' : '/'}`) || isAbsolute(rel)) {
      throw new Error('Path is outside the workspace or refers to its root');
    }
    return full;
  }

  /** Reject symlinks in every existing component, not just the final file. */
  private async check(path: string, allowMissingFinal: boolean): Promise {
    const full = this.lexical(path);
    const rel = relative(this.root, full);
    const parts = rel.split(/[\\/]/);
    let current = this.root;
    for (let i = 0; i < parts.length; i++) {
      current = resolve(current, parts[i]!);
      try {
        const stat = await lstat(current);
        if (stat.isSymbolicLink()) throw new Error('Symbolic links are not permitted');
        if (i < parts.length - 1 && !stat.isDirectory()) throw new Error('Parent is not a directory');
      } catch (error) {
        if (allowMissingFinal && i === parts.length - 1 && (error as NodeJS.ErrnoException).code === 'ENOENT') break;
        throw error;
      }
    }
    return full;
  }
read 在打开已有文件前会调用this.check(path, false);write 则调用this.check(path, true),只允许最后一个文件本身不存在。父目录缺失或路径中出现任何符号链接,检查依然会失败。
这一边界由工具实现来强制执行,而不是指望模型自觉守规矩。模型可以请求../secret.txt,但工作区会拒绝打开它。随后框架把这个失败作为可恢复的工具结果返回,和第 2 章处理非法参数的方式一样。
作为额外的防护,实现层在支持的平台会用O_NOFOLLOW标志打开文件,避免路径末尾的符号链接被跟踪。但这并不能消除所有竞态条件:在检查和打开之间,目录层级的组件仍可能被替换。这是一个有教学价值的限制,不是操作系统级的沙箱。
让模型选择命令,而不是自己发明命令
执行命令的敏感性更高。我们没有让模型生成 shell 字符串再直接执行,而是注册了一批具名的命令预设:
const tool = commandTool(projectRoot, {
  test: {
    executable: process.execPath,
    args: ['--test', 'tests/example.test.js']
  }
});
模型可以请求 { "command": "test" },但无法指定其他可执行文件、附加参数或 shell 语法。命令工具的分发边界大致如下(位于其 execute(value, signal) 方法内部):
signal.throwIfAborted();
const name = (value as { command: string }).command;
if (!Object.hasOwn(presets, name)) throw new Error('Command not permitted');
const preset = presets[name]!;
const timeout = preset.timeoutMs ?? 10_000;
if (!Number.isSafeInteger(timeout) || timeout < 1) {
  throw new Error('Invalid timeout');
}

// Inside the Promise that collects the command's result:
const child = spawn(preset.executable, [...preset.args], {
  cwd, shell: false, signal, windowsHide: true,
  stdio: ['ignore', 'pipe', 'pipe']
});
const timer = setTimeout(() => child.kill(), timeout);
这里spawn来自node:child_process,cwd是配置好的项目根目录,presets就是上面开发者提供的映射表。结果处理器负责收集 stdout 和 stderr,只要任一捕获内容超过 65,536 个字符就杀掉子进程,并在出错或关闭时清除timer。注意,这里统计的是 JavaScript 字符串长度,而非精确的字节数。
这样限制了模型可选择的命令数量,但选中的命令未必就无害。测试脚本本身可能读文件、访问网络,甚至启动子进程。此外,杀掉超时的子进程,并不能保证其整个进程树都被可靠终止。要运行不受信任的代码仓库,仍然需要进程隔离,比如配置妥当的容器或操作系统沙箱。
Milestone 3 测试覆盖了正常读写、路径穿越攻击、符号链接、可恢复的访问失败,以及被拒绝的命令名等情况。
4. 给执行设限
现在我们的 Agent 已经可以调用经过校验的工具了,包括感知工作区的文件操作和预定义命令。但合法的操作并不等于可以无限放行。模型可能一次性发起成百上千次工具调用,也可能某条命令卡住,让 Agent 一直干等结果。
在本里程碑中,我们让执行限制成为 harness 自身的职责,而不是指望模型自觉遵守。
请对照仓库的对应版本跟着做:
git switch --detach 04-execution-limits
如果还没克隆项目,先执行git clone https://github.com/gkoos/agent-harness-from-scratch.git,然后cd agent-harness-from-scratch进入目录。
分别统计对话轮次和工具调用次数
原来的maxSteps限制的是模型响应次数,而非工具调用次数。一次响应可能请求多个工具,所以单靠轮次上限并不能约束总工作量。
我们为runAgent增加了两个新选项:
const result = await runAgent({
  model,
  tools,
  prompt: 'Check the project',
  maxSteps: 10,
  maxToolCalls: 30,
  timeoutMs: 15_000
});
每次请求的调用都会消耗工具调用预算,包括未知工具和参数无效的调用。这一点很重要,因为即使请求失败了,测试框架照样要付出处理成本。在循环之前初始化let toolCalls = 0,然后在查找每个已放行调用的工具之前立即递增。这样安排能把被拒绝的参数和未知工具也统计进去。
模型还可能一次返回多个工具调用。与其先执行前几个、然后才发现预算已经用光,测试框架会先检查整批调用是否都在预算之内:
if (calls.length > maxToolCalls - toolCalls) {
  return { status: 'tool_limit', messages, steps, toolCalls };
}
这可以避免因预算不足而导致的部分执行。但这并不意味着批量调用具备事务性:工具仍可能失败,执行也可能在中途被取消。
传递取消信号与截止时间
调用方可以传入一个 AbortSignal,而 timeoutMs 则会创建内部截止时间。执行框架通过 AbortController 将两者合并,并把合并后的信号传给模型和工具。
这种设置取代了初始循环中直接选用的信号:
const controller = new AbortController();
let timedOut = false;
const onAbort = () => controller.abort(options.signal?.reason);
if (options.signal?.aborted) onAbort();
else options.signal?.addEventListener('abort', onAbort, { once: true });
const timer = timeoutMs === undefined ? undefined : setTimeout(() => {
  timedOut = true;
  controller.abort(new Error('Agent deadline exceeded'));
}, timeoutMs);
const signal = controller.signal;
把这个signal传给model.generate()和tool.execute(),做法与原来的循环一致。再用try/finally包裹循环,确保正常结束和提前返回时都能释放计时器和监听器:
try {
  // The execution loop goes here, using controller.signal.
} finally {
  if (timer !== undefined) clearTimeout(timer);
  options.signal?.removeEventListener('abort', onAbort);
}
在执行边界处检查signal.aborted,并以timedOut ? 'timeout' : 'aborted'作为状态返回。结果中还会报告steps和toolCalls,调用方据此能了解终止前完成了多少工作。
这是协作式取消,而非强制终止。如果适配器忽略signal,某个未完成的操作可能会超过截止时间仍在运行。同样,杀掉子进程也未必能终止其后代进程。要想实现硬性执行边界,需要进程或容器级别的隔离。
无需等待真实故障,即可测试限制
budget tests使用脚本化模型请求一批超出预算的操作,并验证没有任何工具被执行。其他测试则检查:无效请求会消耗预算、预先中止的signal会阻止模型调用,以及协作式的模型和工具能在截止时间停下。
types.ts中的结果类型现在可以区分completed、step_limit、tool_limit、aborted、timeout和model_error。这些结果各有含义:一次运行可以正确停止,却并未完成用户的任务。
5. 管控上下文
至此,harness已经能限制运行时长,但对话仍在不断增长。模型的每次响应和每个工具结果都会成为新消息,再次发回给模型。一次文件读取就可能返回数千行内容。往往还没用完步数预算,几轮迭代就已经耗尽模型的上下文窗口。
里程碑5引入了一组区分:我们保留的完整记录与实际发送给模型的消息。实现代码如下:
git switch --detach 05-context
相关文件包括 src/core/context.ts、src/core/agent.ts 和 tests/context.test.ts。
绑定工具输出与面向模型的历史记录
新增的 context 选项设置了两个独立的限制:
const result = await runAgent({
  prompt: 'Inspect the project',
  model,
  tools,
  context: {
    maxContextChars: 32_000,
    maxToolResultChars: 8_000
  }
});
maxToolResultChars 限制的是每个工具结果进入记录前的长度。超长的结果会保留开头和结尾,中间以省略标记代替。被丢弃的部分之后无法找回,即使在 result.messages 里也一样。
这个截断辅助函数会先为省略标记预留空间,再把剩余空间平均分配给开头和结尾:
export function boundToolResult(content: string, limit: number): string {
  if (content.length <= limit) return content;
  const marker = `\n...[${content.length - limit} or more characters omitted]...\n`;
  if (marker.length >= limit) return marker.slice(0, limit);
  const remaining = limit - marker.length;
  const front = Math.ceil(remaining / 2);
  const back = Math.floor(remaining / 2);
  return content.slice(0, front) + marker + (back ? content.slice(-back) : '');
}
在记录成功结果和错误字符串时都要应用它:content: boundToolResult(content, context.maxToolResultChars)。这个紧凑版本显式处理了长度为零的尾部情况,避免 slice(-0) 意外保留完整结果。
maxContextChars 限制传给模型的序列化消息数组。框架在返回的对话记录中仍保留较早的消息,但 selectContext() 只会发送最初的用户请求加上尽可能多的近期轮次。这里没有任何摘要处理:被省略的历史在当前轮次对模型完全不可见。
这些都是字符限制,而非 token 限制。它们衡量的是 JSON 序列化后的 JavaScript 字符串长度,不包括工具定义和各家服务商特有的开销。真实的供应商适配器还需要感知 token 的精确核算,并为响应预留空间。
不要把工具调用和它的结果拆开
裁剪上下文并不是简单删掉最老的消息就行。一条 assistant 响应可能请求多个工具,每个工具由调用 ID 标识。如果只发送其中部分结果,对话就会变得无效或有误导性。
因此选择器把 assistant 消息和该批次的所有结果视为不可分割的整体:要么完整纳入,要么整体舍弃。它还会拒绝孤立的结果和不完整的批次,而不是悄悄拼出不一致的上下文。
下面是 src/core/context.ts 中的 selectContext(),使用第 1 节定义的 Message 类型。第一个循环负责校验并分组对话记录;第二个循环从后往前按完整组回溯,直到预算用满:
import type { Message } from './types.ts';

const size = (messages: readonly Message[]) => JSON.stringify(messages).length;

export function selectContext(messages: readonly Message[], maxChars: number): Message[] {
  if (!Number.isSafeInteger(maxChars) || maxChars < 1) {
    throw new RangeError('maxContextChars must be a positive safe integer');
  }
  if (!messages.length) return [];
  const groups: Message[][] = [];
  for (let i = 0; i < messages.length;) {
    const message = messages[i]!;
    if (message.role === 'assistant' && message.toolCalls?.length) {
      const ids = new Set(message.toolCalls.map(call => call.id));
      if (ids.size !== message.toolCalls.length) throw new Error('Duplicate tool call IDs in assistant turn');
      const group: Message[] = [message];
      i++;
      while (i < messages.length && messages[i]!.role === 'tool') {
        const result = messages[i]!;
        if (result.role === 'tool' && !ids.delete(result.callId)) throw new Error('Orphan or duplicate tool result');
        group.push(result);
        i++;
      }
      if (ids.size) throw new Error('Incomplete tool result batch');
      groups.push(group);
    } else {
      if (message.role === 'tool') throw new Error('Orphan tool result');
      groups.push([message]);
      i++;
    }
  }
  const first = groups[0]!;
  if (first[0]?.role !== 'user') throw new Error('Conversation must start with a user message');
  const recent: Message[][] = [];
  for (let i = groups.length - 1; i >= 1; i--) {
    const group = groups[i]!;
    const next = [...first, ...[group, ...recent].flat()];
    if (size(next) > maxChars) {
      if (recent.length === 0) throw new Error('Context budget too small for latest turn');
      break;
    }
    recent.unshift(group);
  }
  const selected = [...first, ...recent.flat()];
  if (size(selected) > maxChars) throw new Error('Context budget too small for required messages');
  return selected;
}
每次调用模型前,都用selectContext(messages, context.maxContextChars)作为它的messages输入。如果初始提示词或最近一组必需内容放不下,选择器会抛出异常,测试框架随即返回context_limit。这是执行层面的决定,而不是模型可以自行恢复的工具错误。
确定性测试覆盖了批次保留、孤儿消息检测、输出截断以及面向模型的投影。它们验证的不只是上下文变小了,还有它仍然呈现一段连贯的对话。接下来,我们要让这些决策变得可观察。
6. 让 Agent 执行可观察
Agent 可能最终给出了正确答案,但过程中做了一些意料之外的事:反复重试失败的操作、进行不必要的模型调用,或者把大部分时间花在某个工具上。仅凭最终答案,我们无从得知过程中发生了什么。我们需要捕获执行事件,但又不能把测试框架变成一个日志框架。
这个里程碑的代码可以在配套仓库中查看:
git switch --detach 06-observability
相关实现位于src/core/events.ts,并在src/core/agent.ts中集成。
在执行边界发射事件
我们为runAgent添加了一个可选的onEvent回调。harness 会在调用模型前后发射model_start和model_end,在分发工具前后发射tool_start和tool_end;模型操作失败时发射model_error,运行结束时发射run_end。
每个事件都带有运行 ID、递增的序号和时间戳。模型与工具的完成事件还会通过单调时钟记录耗时。凭借这些信息,我们足以还原操作顺序,并找出慢调用。
const events: AgentEvent[] = [];

const result = await runAgent({
  prompt: 'Inspect the project',
  model,
  tools,
  onEvent: event => events.push(event),
});

console.log(result.runId, events);
从src/core/events.ts中导入AgentEvent。回调是可选的:不需要遥测的调用方可以直接省略它。
有一个容易被忽视的要求:可观测性不能干扰执行流程。事件监听器抛出异常,不应导致一次本已成功的工具调用失败。事件发射器会捕获监听器的异常,并可选择通过onObserverError上报,而这个处理器自身的失败也会被抑制。不过回调是同步执行的,所以响应缓慢的监听器仍会拖慢Agent。
发射器用node:crypto的randomUUID()一次性生成runId,并将sequence初始化为零。它的emit(event)方法负责丰富事件内容,同时隔离两类回调:
const enriched = {
  ...event, runId, sequence: ++sequence,
  timestamp: new Date().toISOString()
};
try {
  options.onEvent?.(enriched);
} catch (error) {
  try { options.onObserverError?.(error); }
  catch { /* Observer failures cannot change the run outcome. */ }
}
在模型或工具边界处,执行前先记录const start = performance.now(),执行完再上报durationMs: performance.now() - start。通过一个共享的finish()辅助函数,在返回每个最终结果前发出run_end事件,这样提前退出的路径也能被观测到。
如实记录模型用量,而非凭空编造
我们还可以在模型响应中附带可选的、由提供商上报的token用量:
return {
  content: 'Done',
  usage: { inputTokens: 125, outputTokens: 20 },
};
测试框架会把上报的用量计数累加到result.usage中,同时记录modelCallsWithUsage。后一个字段很关键:如果上报的 token 为零,且没有任何用量上报调用,说明用量未知,而不是免费运行。无效的计数会被直接拒绝,而不会悄悄污染统计结果。
累加器使用可选的输入和输出计数,并会对单个数值以及汇总结果进行校验:
export type Usage = { inputTokens?: number; outputTokens?: number };
export type UsageTotals = {
  inputTokens: number; outputTokens: number; modelCallsWithUsage: number
};

export function addUsage(totals: UsageTotals, usage: Usage | undefined): void {
  if (!usage) return;
  for (const value of [usage.inputTokens, usage.outputTokens]) {
    if (value !== undefined && (!Number.isSafeInteger(value) || value < 0)) {
      throw new RangeError('Model usage must contain nonnegative safe integers');
    }
  }
  if (!Number.isSafeInteger(totals.inputTokens + (usage.inputTokens ?? 0)) ||
      !Number.isSafeInteger(totals.outputTokens + (usage.outputTokens ?? 0))) {
    throw new RangeError('Accumulated model usage exceeds safe integer range');
  }
  totals.inputTokens += usage.inputTokens ?? 0;
  totals.outputTokens += usage.outputTokens ?? 0;
  totals.modelCallsWithUsage++;
}
在运行开始时把统计值初始化为零。在模型响应契约中加入usage?: Usage,每次校验完响应后调用addUsage(totals, response.usage),并在结果中带上统计值的副本。缺少用量信息时计数器保持不变。
事件载荷刻意不包含提示词、工具参数和工具结果。错误字符串仍可能含有敏感数据,导出时须谨慎。这只是一套轻量的内存级埋点,并非分布式追踪,也不是持久化的审计日志。
tests/events.test.ts中的测试验证了事件顺序、关联关系、用量统计、观察者隔离以及终止事件。
7. 测试失败路径,而不只是正常路径
我们的测试框架现在已有工具校验、执行限制、上下文管理和可观测性。但这些机制之间会相互影响:模型可能返回格式错误的工具调用,取消请求可能在一批任务执行到一半时到来,被拒绝的批次也可能让对话陷入无法再发给模型的状态。最后一个里程碑就直接测试这些边界情况。
欢迎查看配套仓库中的最后一个里程碑:
git switch --detach 07-testing
新的测试位于tests/failures.test.ts。这些测试沿用了第一个里程碑中使用的脚本化模型,因此即使没有 API key,失败场景也能稳定复现。
先校验,再信任模型响应
只校验工具参数还不够。模型适配器也可能返回格式错误的响应:缺少 content、toolCalls 不是数组、参数缺失,或者调用 ID 重复。新增的validateModelResponse()会在框架记录响应或执行任何操作之前,先对响应结构做检查。
import type { Model, ToolCall } from './types.ts';

/** Validate the adapter boundary before accepting a model turn or running side effects. */
export function validateModelResponse(value: unknown): asserts value is Awaited> {
  if (value === null || typeof value !== 'object' || Array.isArray(value)) {
    throw new TypeError('Model response must be an object');
  }
  const response = value as Record;
  if (typeof response.content !== 'string') throw new TypeError('Model response content must be a string');
  if (response.toolCalls === undefined) return;
  if (!Array.isArray(response.toolCalls)) throw new TypeError('Model toolCalls must be an array');
  const ids = new Set();
  for (const call of response.toolCalls as unknown[]) {
    if (call === null || typeof call !== 'object' || Array.isArray(call)) {
      throw new TypeError('Tool call must be an object');
    }
    const item = call as Partial;
    if (typeof item.id !== 'string' || !item.id.trim()) throw new TypeError('Tool call id must be a nonempty string');
    if (typeof item.name !== 'string' || !item.name.trim()) {
      throw new TypeError('Tool call name must be a nonempty string');
    }
    if (!Object.hasOwn(item, 'arguments')) throw new TypeError('Tool call arguments are missing');
    if (ids.has(item.id)) throw new TypeError(`Duplicate tool call id: ${item.id}`);
    ids.add(item.id);
  }
}
在model.generate()之后、追加助手消息或执行工具之前,立即在try块中调用validateModelResponse(response)和addUsage(usage, response.usage)。只要其中任何一个抛出异常,就发出model_error并返回finish('model_error', { error: message }),其中message是异常信息。
格式错误的响应会以model_error终止,且不会产生任何工具副作用。这与参数无效的有效工具调用不同:后者会变成可恢复的工具错误,让模型有机会重试。
把被拒绝的批次挡在对话记录之外
测试还发现了一个真实的集成缺陷。此前,测试框架会先追加包含工具调用的助手消息,之后才检查该批次是否超出maxToolCalls。一旦批次被拒绝,对话记录里就会留下无人应答的工具调用。
修复方案很小但很关键:先检查预算,再记录助手轮次。
if (calls.length > maxToolCalls - toolCalls) {
  return finish('tool_limit');
}
messages.push({
  role: 'assistant',
  content: response.content,
  ...(calls.length ? { toolCalls: calls } : {})
});
这样预算拒绝相对于会话记录就是原子操作。不过,如果取消发生在已获准的批次执行过程中,仍可能留下不完整的终态记录;恢复这类运行需要先做对账。
使用可复现的随机变化
除了针对格式错误响应、取消操作和观察者故障的定向测试,我们还会运行150 个带随机种子的工具批次场景,覆盖不同的批次大小和预算。固定的伪随机种子保证每次运行生成相同序列,让故障可以复现。
下面的示例应放在tests/failures.test.ts中。它们共用一个空操作工具,以及一个用于构造格式正确调用的辅助函数:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';
import type { Tool } from '../src/core/types.ts';

const noop: Tool = {
  name: 'noop', description: 'Return a fixed result',
  parameters: { type: 'object' },
  async execute() { return 'ok'; }
};
const call = (id: string) => ({ id, name: 'noop', arguments: {} });
第一项测试将 budget 从 0 变到 8,batch size 从 0 变到 12,并检查执行次数、终止状态,以及被拒绝的调用是否被排除在 transcript 之外:
test('seeded batches respect tool budgets', async () => {
  let seed = 0x12345678;
  const next = () => {
    seed ^= seed << 13;
    seed ^= seed >>> 17;
    seed ^= seed << 5;
    return seed >>> 0;
  };

  for (let i = 0; i < 150; i++) {
    const limit = next() % 9;
    const batch = next() % 13;
    let executed = 0;
    const result = await runAgent({
      prompt: 'test', maxToolCalls: limit,
      tools: [{
        ...noop,
        async execute() { executed++; return 'ok'; }
      }],
      model: scriptedModel([
        {
          content: '',
          toolCalls: Array.from({ length: batch }, (_, j) => call(`call-${j}`))
        },
        { content: 'done' }
      ])
    });

    const admitted = batch <= limit;
    assert.equal(executed, admitted ? batch : 0, `case ${i}`);
    assert.equal(result.toolCalls, admitted ? batch : 0, `case ${i}`);
    assert.equal(
      result.status, admitted ? 'completed' : 'tool_limit', `case ${i}`
    );
    if (!admitted) {
      assert.deepEqual(result.messages, [{ role: 'user', content: 'test' }]);
    }
  }
});
获批的批次会执行所有请求的工具,而超预算的批次则一个工具都不执行。case标签用于标识是哪个生成场景失败了,固定的随机种子则让我们能够复现这个失败。
另外还有60次运行,用来验证工具抛出的异常始终是可恢复的错误。这些测试重复同样的失败路径,只是换用不同的错误信息,且不使用随机种子:
test('tool exceptions remain recoverable', async () => {
  let executed = 0;
  for (let i = 0; i < 60; i++) {
    const result = await runAgent({
      prompt: 'test',
      tools: [{
        ...noop,
        async execute() {
          executed++;
          throw new Error(`failure ${i}`);
        }
      }],
      model: scriptedModel([
        { content: '', toolCalls: [call('1')] },
        { content: 'recovered' }
      ])
    });
    assert.equal(result.status, 'completed');
    assert.equal(result.answer, 'recovered');
    assert.ok(result.messages.some(message =>
      message.role === 'tool' && message.isError &&
      message.content === `failure ${i}`
    ));
  }
  assert.equal(executed, 60);
});
预置场景是属性风格的断言检查,而异常测试则反复验证某条具体的恢复路径。两者都不能证明正确性,也无法替代操作系统的沙箱隔离,但都无需真实模型即可运行,还能为测试工具的行为提供可复现的证据。
至此,我们已经把这个测试工具从简单的模型/工具循环,打造成一个负责校验、权限、限额、上下文和遥测的执行层。模型依然负责提出动作,而真正决定执行什么的是测试工具。
运行npm test即可执行这些示例。仓库中还包含针对上述边界的更多专项用例,以及各里程碑的完整实现代码。
下一步:接入真实的语言模型
在整个教程中,我们一直使用脚本模拟的模型,而没有调用真实的大模型。这是有意为之:确定性的响应让我们无需网络请求、API 密钥,也不必应付模型输出的不可预测性,就能测试测试工具本身,包括它的各种失败路径。
但Model接口的设计初衷就是让不同提供商可以互换。接入 OpenAI、Anthropic 或其他提供商,并不需要重写智能体循环,只需编写一个适配器,在提供商的 API 与我们现有的类型之间做转换即可。
举个例子,使用 Responses API 的 OpenAI 适配器大致如下:
// src/models/openai.ts
import OpenAI from 'openai';
import type { Model } from '../core/types.ts';

export function openAIModel(client: OpenAI): Model {
  return {
    async generate({ messages, tools, signal }) {
      const response = await client.responses.create(
        {
          model: 'YOUR_MODEL',
          input: toOpenAIInput(messages),
          tools: toOpenAITools(tools),
        },
        { signal }
      );

      return {
        content: extractText(response),
        toolCalls: extractToolCalls(response),
        usage: extractUsage(response),
      };
    },
  };
}
这只是一份架构草图,并非完整的适配器。转换函数需要把我们的消息和工具定义翻译成服务商的格式,再对其响应做归一化处理。特别是要保留工具调用的 ID,解析工具参数,并在后续请求中把工具结果与正确的调用关联起来。
适配器还会透传 harness 的AbortSignal,让取消操作能一路传递到 API 请求。服务商返回的错误会转为异常,而 harness 已经把这类异常当作model_error结果来处理了。
只要适配器实现了Model接口,系统其余部分就无需改动。无论下一次响应来自哪家服务商,同一套工具注册表、参数校验、执行预算、上下文管理和可观测性机制都能照常运作。
还有一些值得探索的改进:针对具体服务商的 token 统计、API 重试与限流处理、持久化会话历史,以及为运行不可信代码提供更强的进程隔离。这些本身就是不小的工程难题,但都能装进我们已划定的边界内,无需另起炉灶改架构。
完整实现见07-testing里程碑。
我们构建的不只是一个向模型发送提示词并执行函数的循环,而是一整套机制,它决定哪些操作被允许、能做多少工作、模型能收到什么上下文,以及故障如何处理和观测。
这正是“带工具的语言模型”与“Agent harness”的本质区别。



