从AI解决方案到知识共享:为社区构建MCP
这是一份针对 周末挑战:慷慨版 的提交 别只问 AI,把答案分享出来。 AI 是软件开发的真正倍增器,也是快速解决技术问题的理想伙伴。 但所有这些知识 — — 我们自己留着,或者说,我们失去了它们。 故事总是止步于此。 提问 → 回答 → 问题解决 — — 对话沉入聊天记录,消失不见。 然后另一个人
Copilot Studio 与 5 种不同的 Agent 构建器
我们都知道微软在 AI 和代理方面一直全速前进,随之而来的是变化(以及重命名 😎),但这也带来了重复和重叠。正是如此,我们在 M365/Power Platform 中得到了 5 种不同的代理构建工具。请注意,我没有包括 Foundry/Azure 构建工具,因为它们更多属于过程代码领域,而 M36
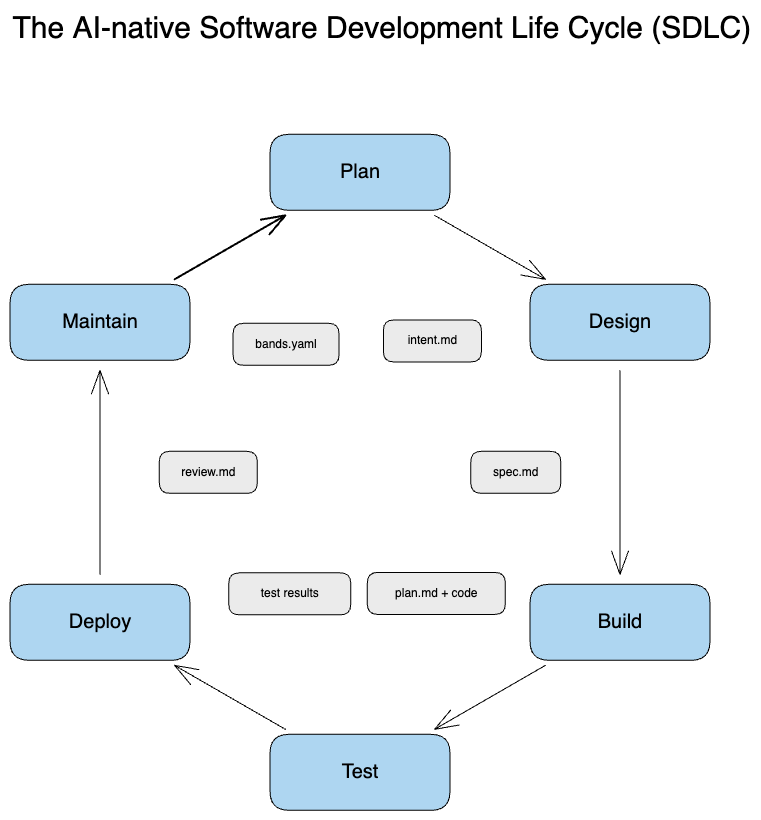
实践中的能动 AI 工程:AI 工程师与前置部署工程师如何使用 Claude Code、Codex 和 G 进行构建
一份实用的三工具指南,面向 AI 原生软件开发生命周期(SDLC):规划、设计、构建、测试、部署、维护,针对 Agentic 编码重新构想。 2025 年 3 月,一个名为 METR 的小型非营利研究小组发布了一张图表,令许多工程领导者比平时更加坐直。 通过倒推六年的模型发布,METR 测量了 AI
使用 OpenTelemetry 实现 Claude Code 可观测性
像 Claude Code 、 OpenAI Codex 、 Google Antigravity 和 Cursor 这样的智能体编程工具,如今已成为日常软件开发的标配。 随着智能体系统日趋成熟,开发者交给它们的大部分工作都是层层委派完成的,一次交给一个 subagent。许多团队也在探索并采用共享
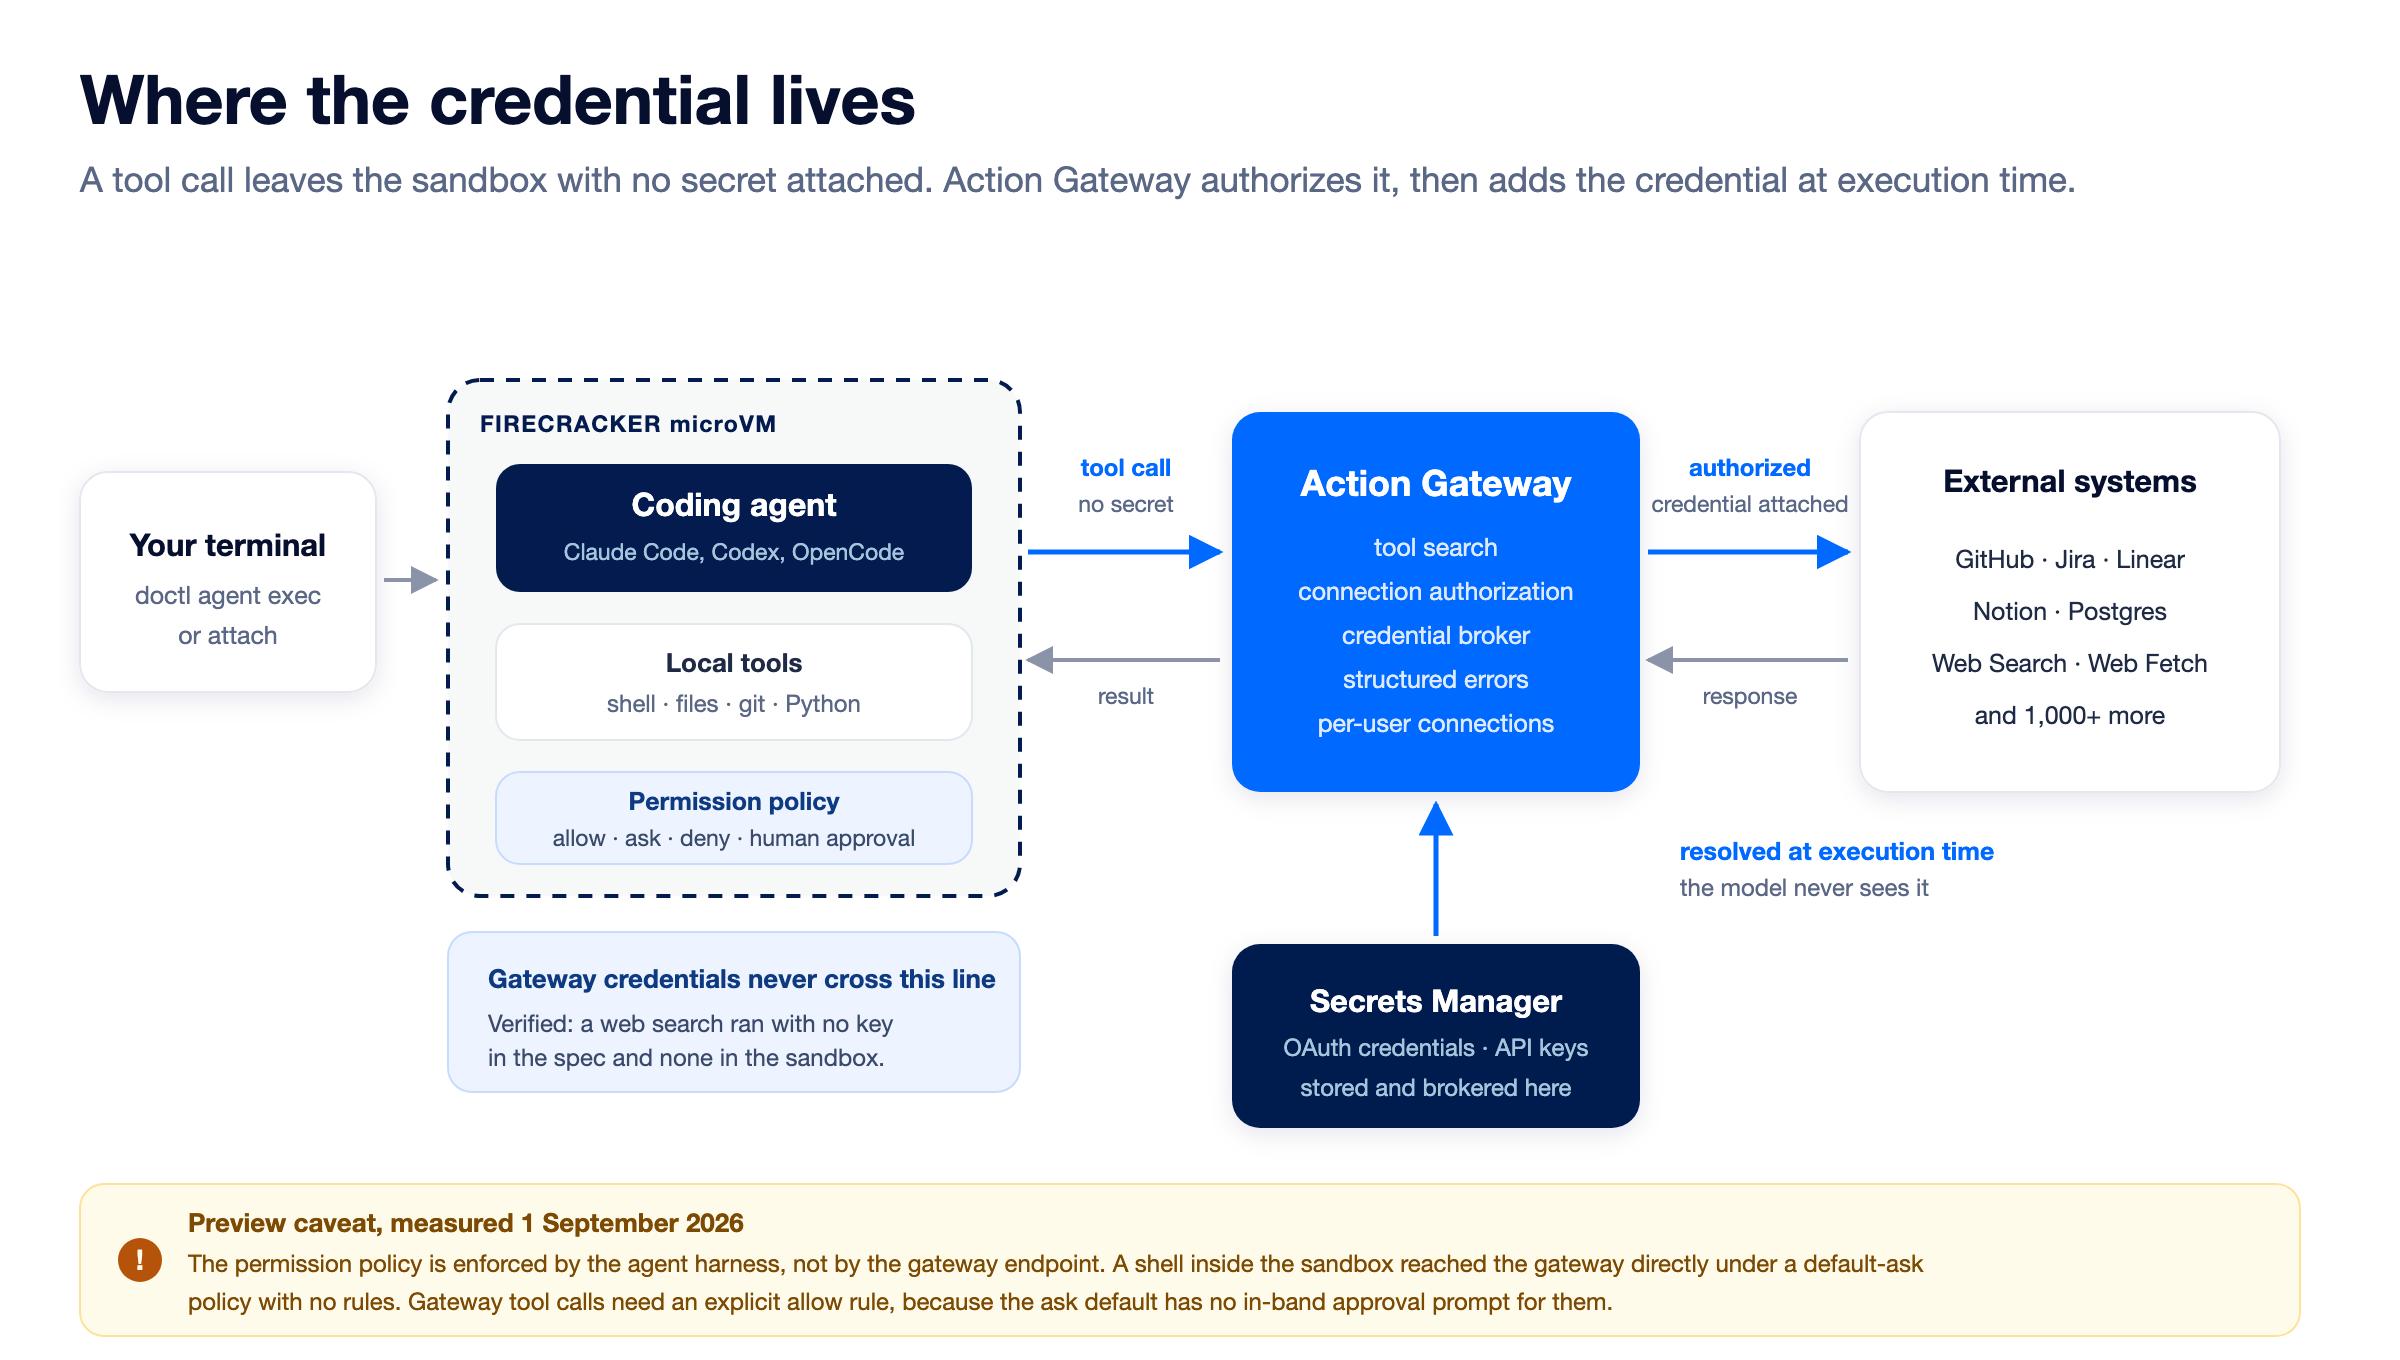
面向 AI 代理的 MCP 网关:使用 DigitalOcean Action 将 AI 代理连接到 SaaS 工具而无需共享凭据
每个 agent 演示之所以能够工作,是因为 agent 只需要回答。当 agent 需要执行操作时,生产才真正开始:克隆仓库、创建拉取请求、查询数据库、退款支付、提交工单。agent 一旦开始行动,四个问题会同时出现。凭证存放在哪里。谁有权批准写操作。失败时会发生什么。此次运行的成本是多少。 本文
Kong AI Gateway 2.0 在 Google Cloud 上:保护 GKE、Cloud Run 和 Vertex AI(Agent 平台)
在 Google Cloud 上运行的大多数团队不会只选择一种计算模型然后止步不前。一些服务部署在 GKE 上,因为它们需要细粒度的控制、sidecar 或 GPU 调度。另一些服务则运行在 Cloud Run 上,因为无状态的 HTTP API 不需要一个集群来照看它。越来越多的第三类工作负载加入
在旧电脑上运行本地LLM:简单的家庭实验指南
目录 为什么在家运行 AI 模型? 什么是本地 LLM? 您需要什么样的电脑? 安装 Ollama 下载您的第一个模型 开始对话 如果模型太慢怎么办? 创建家庭实验室助手 从其他程序使用 Ollama 添加网页界面 常见问题 家庭实验室项目创意 保持您的设置私密 接下来有什么? 最后的想法 为什么在
如何构建能够知道自己不知道的AI系统:实用指南
大型语言模型(LLM)从根本上改变了我们构建内部业务应用的方式。它们使开发者能够创建智能软件,能够综合复杂的企业数据,回答内部查询,并自动化重复的工作流程。 然而,将LLM应用从本地原型迁移到生产企业系统时,可能会暴露一个关键的可靠性问题: 过度自信 。 标准语言模型被优化为生成统计上最可能的下一个
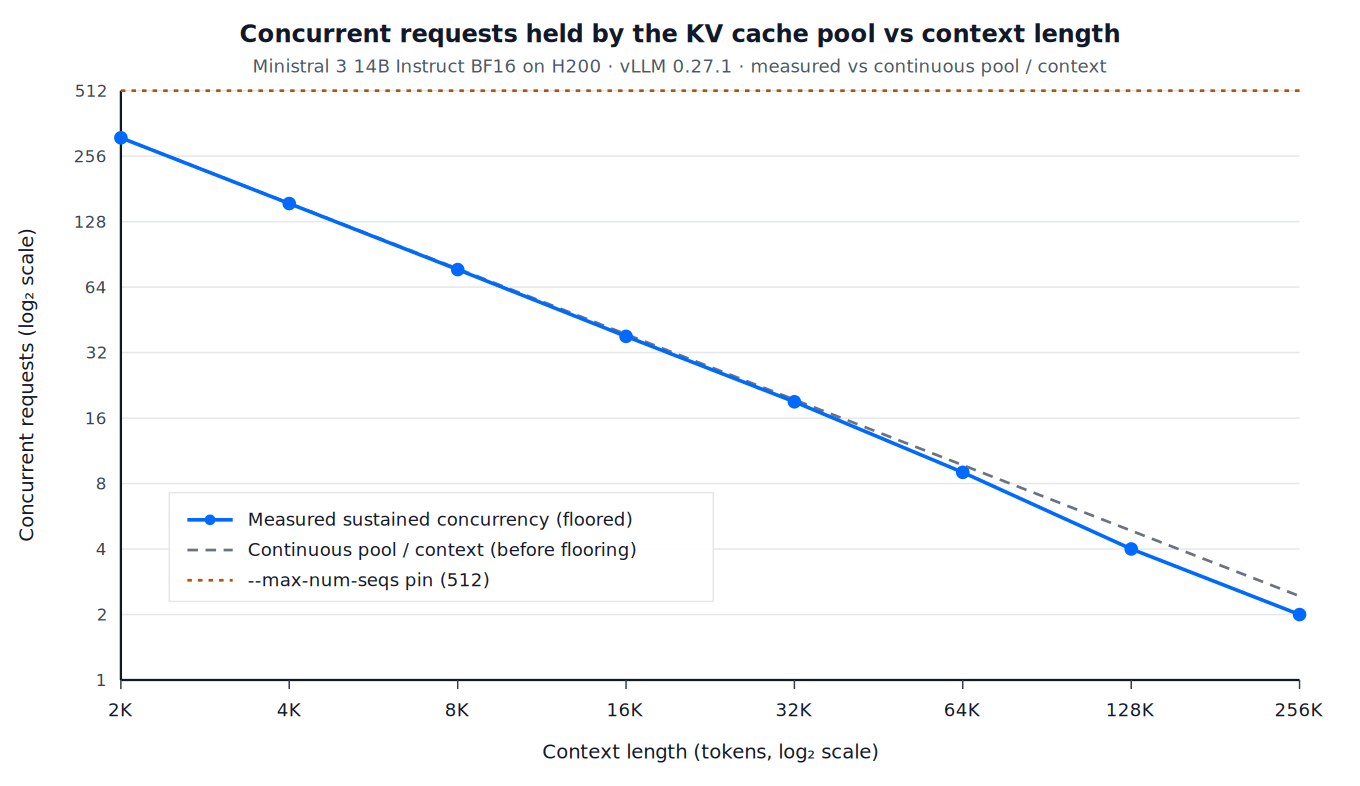
上下文长度是否线性影响推理成本?我们测量了为什么不是这样
简介 成本计算器按上下文长度线性定价:输入 token 增加十倍,费用也增加十倍。这就是费率表的构建方式,而市场自身的定价行为承认这并不是长上下文实际服务的成本。在 DigitalOcean 自家目录中,OpenAI 的 GPT-5.5 和 GPT-5.6 系列在 272K token 时调整费率:
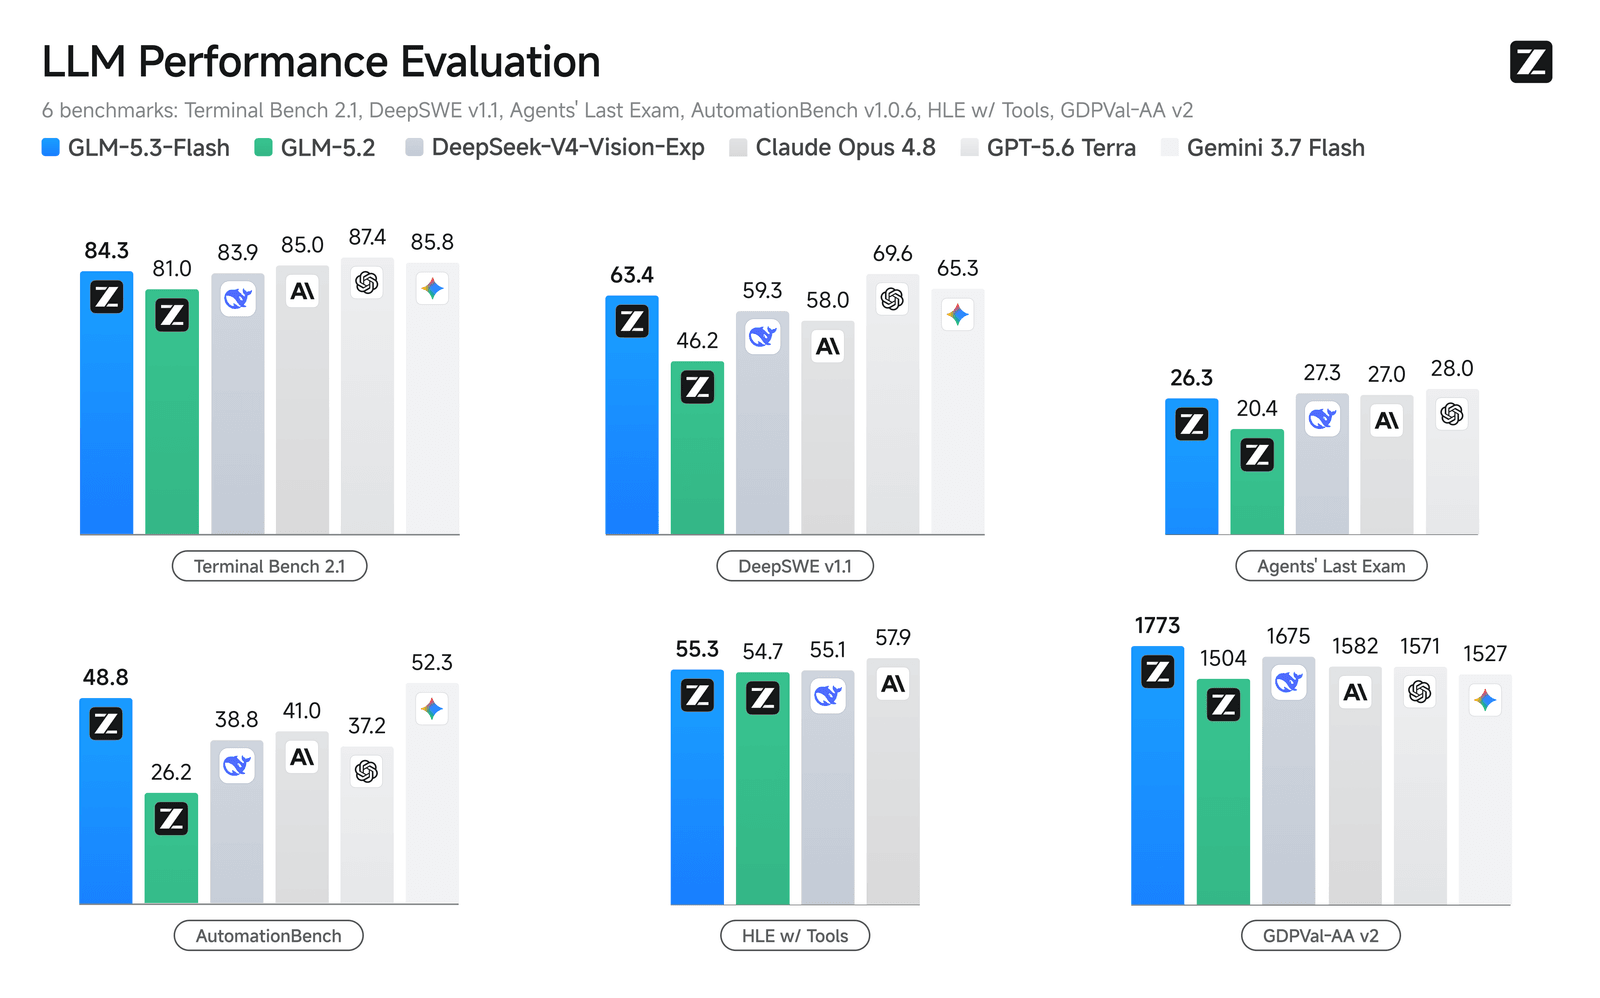
GLM-5.3-Flash 是 DigitalOcean 上最便宜的模型,也是最冗长的。
在 DigitalOcean Serverless Inference 上于 2026 年 8 月测量。 我们询问 GLM-5.3-Flash SSH 默认使用的端口。它花费了 625 个输出 token 得到 “22”。 这是五次运行的中位数,而非挑选的异常值。 Qwen3.8-Max 回答同一问