我让AI设计工具搭建了我的作品集网站——客户注意到了
作品集网站应该让潜在客户轻松回答三个问题:你做什么,你为谁工作,以及你能否真正交付?问题是,构建一个能够传达这三点的作品集往往比预期花费更长时间。我想看看 AI 设计工具是否能在不让网站看起来像另一个通用 AI 生成模板的情况下处理第一个版本。 于是我在这些工具中使用了相同的核心需求——Figma
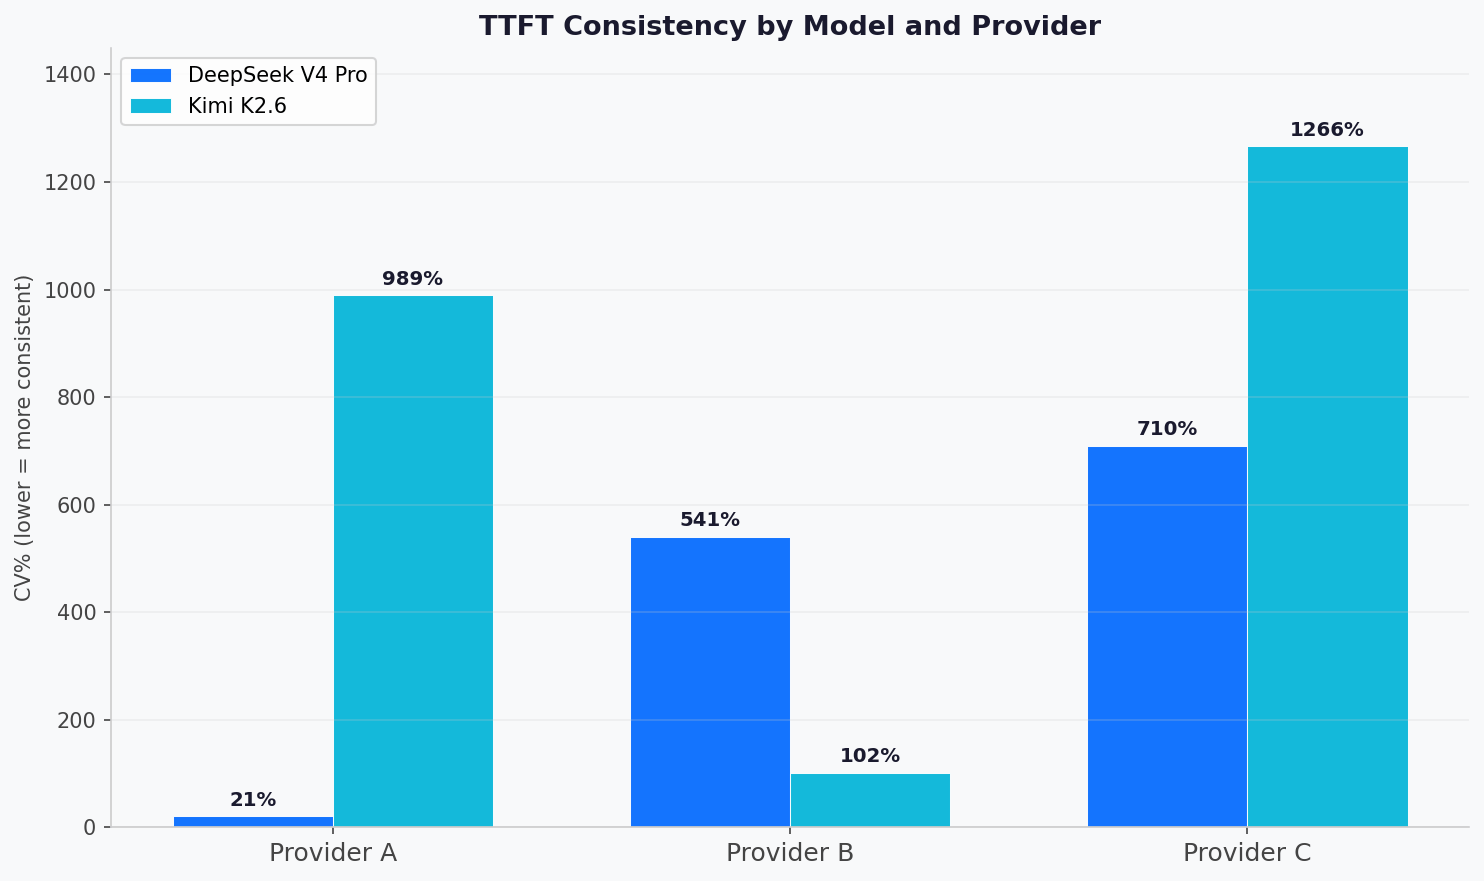
为什么同一模型的无服务器推理一致性会有差异
引言 想象一下,你正在为自己的应用挑选一个 LLM 。你做了大量调研,想找出哪款模型最契合自己的使用场景。你可能在沙箱里用 DigitalOcean Serverless Inference 试跑过它,觉得效果不错,于是决定换用另一家提供同款模型的服务商,把它集成到应用里。可等到正式上线,模型的准确
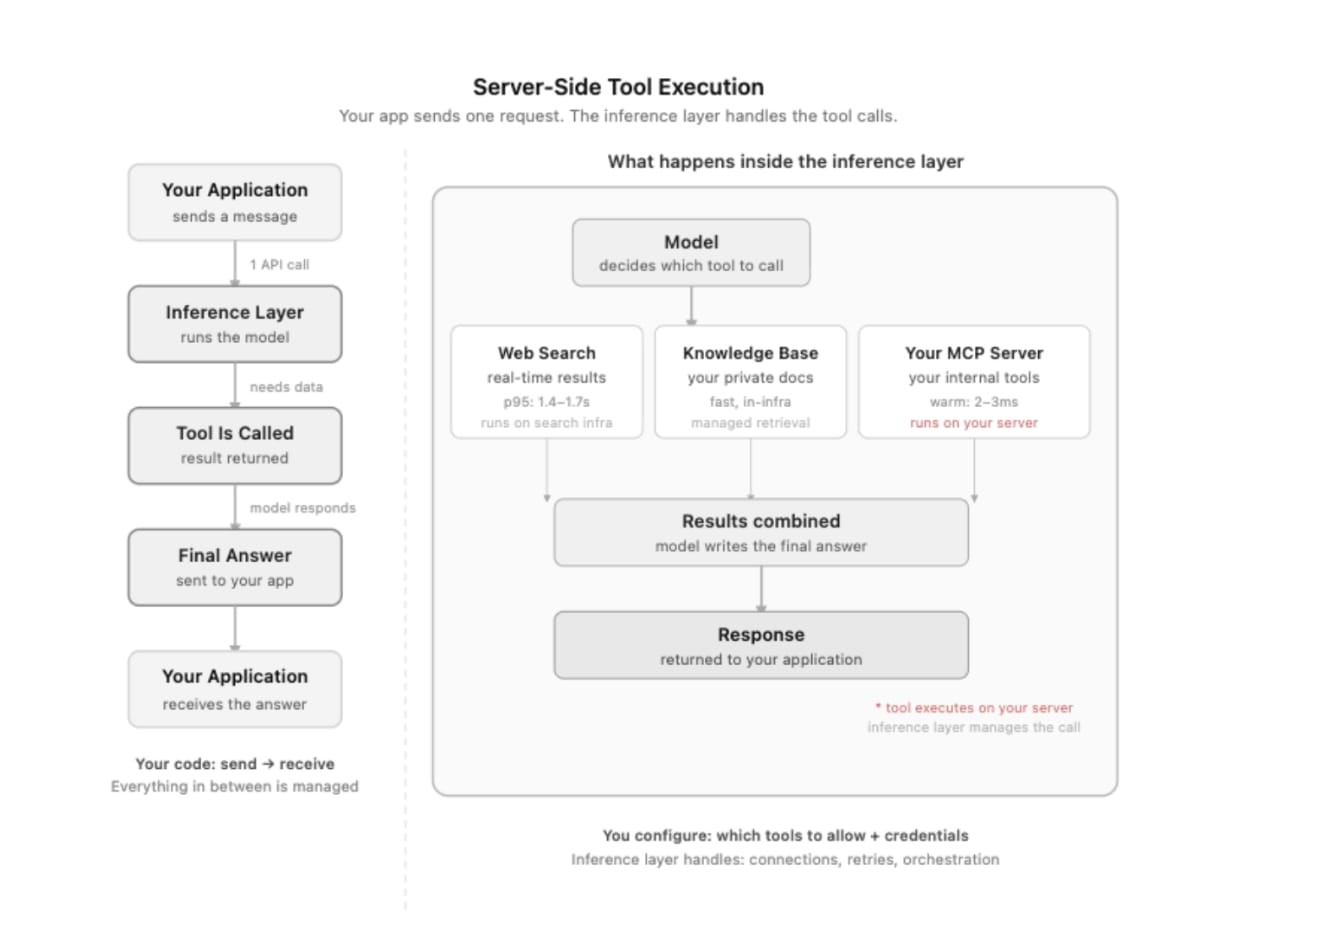
面向 AI 代理的服务器端工具:架构、延迟及何时切换
每个 AI 代理最终都会遇到同样的结构性问题:模型能够进行推理,但若没有工具就无法行动。需要有人来运行这些工具,例如获取搜索结果、查询数据库、调用 API,而这个人通常就是你的代码。 大多数团队采用同样的方式构建这一流程。模型返回一个工具调用,你的代码捕获它,运行工具,格式化结果并发送回去。重复此过
在 DigitalOcean 推理平台上,六个模型竞速,最便宜者获胜
每次要把模型挂到端点后面,我都会做同一个偷懒的决定:随手挑上次用过的,或者最近刚读到过的那个,然后告诉自己“回头再正经跑一次基准测试”。可“回头”永远不会来——总有真正赶截止日期的活儿排在前面,而比较模型延迟这种事,哪怕不算拖延,感觉上也像是在拖延。所以我从没做过,一次都没有。 于是我干脆写了个工具
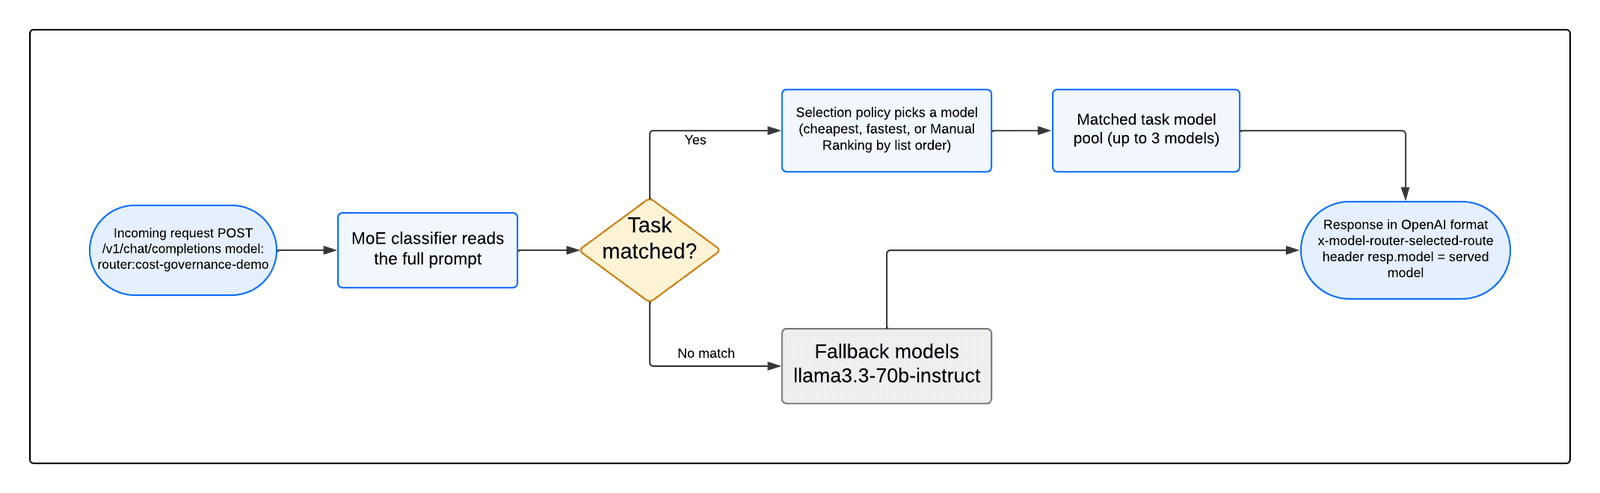
基于推理路由器的多模型 API 成本治理
介绍 推理路由器是位于您的应用与模型服务层之间的中间件,它会根据任务将每个 LLM API 调用路由到合适的模型,而不是把所有请求发送到同一个端点。它解决的问题是大多数 SaaS 后端默认会产生的计费工件:当单一前沿模型处理所有请求时,简单的分类调用(94 输入 token)和复杂的推理调用(3,4
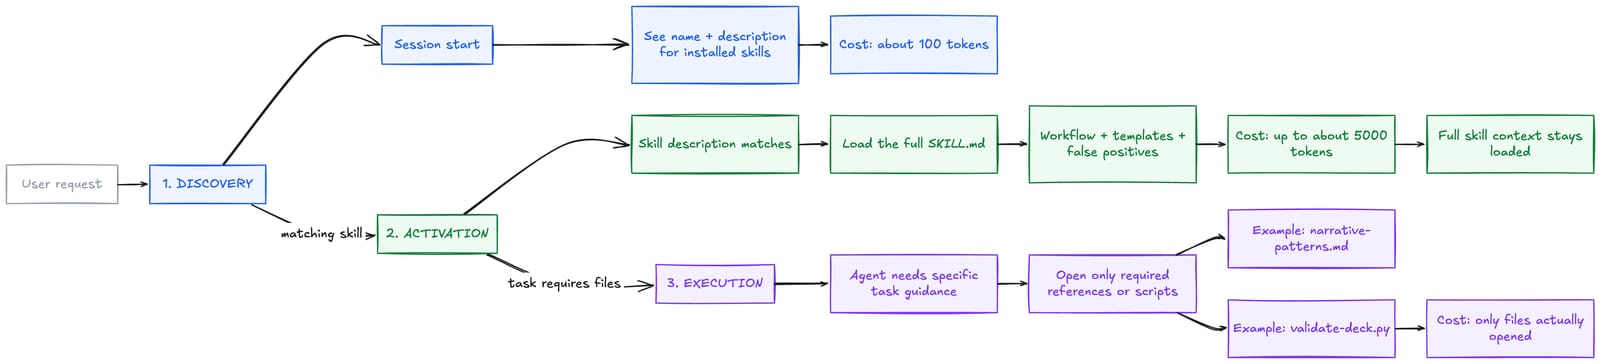
学习 AI SDLC – 构建代理技能的完整指南
也许你会有这样的经历:本周你已经用同样的说明四次解释了 AI 模型。 你反复谈到你们团队是如何组织一份演示文稿的;部署前会运行哪些检查;为什么暂存数据库不是 README 中提到的那个。 每次你都要重新输入一次;每次,代理都能做得不错;但每次,下一次会话都要从零开始。 这就是 Agent Skill
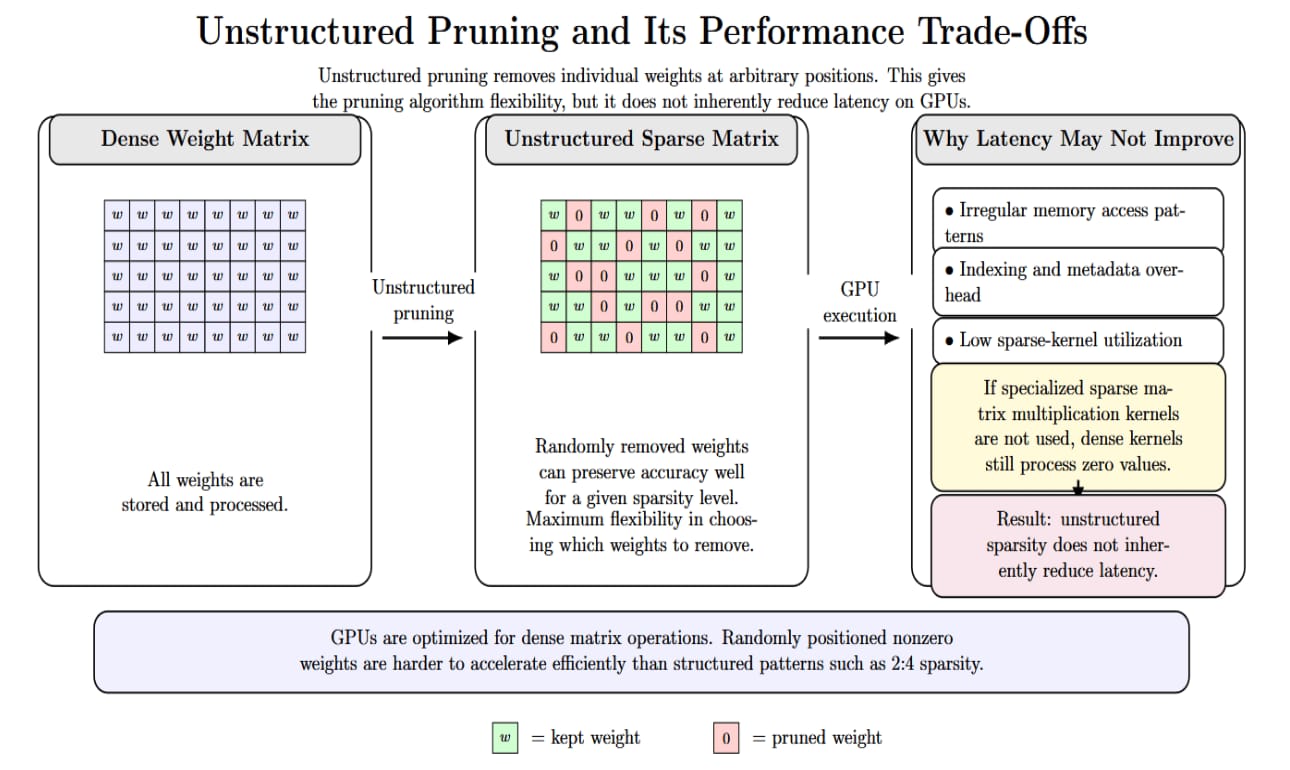
在GPU云上使用SparseGPT和Wanda进行高效的LLM压缩
训练万亿参数模型成本高昂,而推理才是持续产生的运营开销。每个请求都会占用 GPU 显存、 内存带宽、计算周期、批处理槽位和服务容量。模型权重必须常驻 GPU 显存。键值缓存(KV cache)会在生成过程中不断增长。服务引擎还必须以合理的延迟,在大量并发用户之间复用这些资源。 我们来做一个简单的思想
如何测试 Flutter 应用:单元测试、Widget 测试、Golden 测试与集成测试详解
第一次在技术面试中被问到“你的测试覆盖率是多少?”时,我没有给出好答案。 到那时,我已经交付了几个真实的 Flutter 应用。它们运行正常,用户也在使用。但我的测试,如果能称之为测试的话,只是针对我曾经栽过跟头的定价函数写的少量单元测试,除此之外什么也没有。 几个月后,我重构了一个任务完成流程(在
如果 AI 能写代码,你还需要学编程吗?
每个初学者在2026年都在悄悄问同一个问题:当AI模型能写代码时,为什么还要学编程?这种担忧是合理的,入门门槛确实比以前更窄了。但编程中变得便宜的只是敲代码这一环节,剩下的——知道该问什么、能分辨对与几乎对——反而比以前更有价值。 如今,几乎每篇关于AI与就业的帖子底部都会出现这个问题,通常表述得很
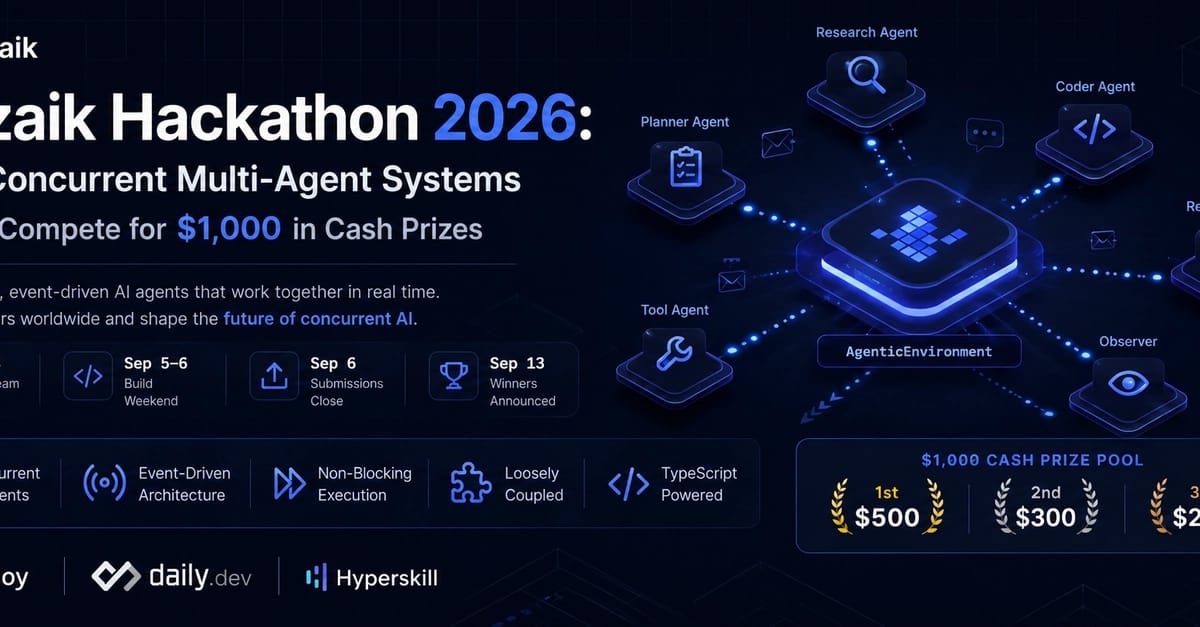
Mozaik 黑客松 2026:构建并发多智能体系统,争夺 1000 美元现金奖
在白板上规划一个 多智能体系统 ,听起来很简单:给一个智能体派任务,让另一个接手下一步,再加个审核者,连上几个工具,一个智能体工作流就搭好了。 可一旦这些智能体需要同时运行,事情就复杂了。 串行工作流会把智能体锁死在固定顺序里:一个跑完,下一个才启动,下游全都得干等。这种模型思路清晰、容易推理,但随